不记得自己是从何时开始喜欢Beyond的了。确实算是一个Beyond迷吧。几乎是每首歌都听过,也几乎每首都会哼。当然限于天赋,大多数是吊不上来的。。。
这首歌翻唱的不错,很有韵味
膘叔的简单人生
不记得自己是从何时开始喜欢Beyond的了。确实算是一个Beyond迷吧。几乎是每首歌都听过,也几乎每首都会哼。当然限于天赋,大多数是吊不上来的。。。
这首歌翻唱的不错,很有韵味
上文ipad 越狱第一步:备份数据介绍了如何备份系统。这一次介绍如何越狱。
软件spirit在上文中有下载链接:spirit.exe【由于我讲的是win下面的方法,mac下的spirit就不提供了。】
OK让我们开始吧。
将spirit.exe拷到C盘根目录下或者某个目录下(目录名有要求,1、英文;2、没有空格)
然后接上线,运行spirit.exe,机器会自动重启,这时基本上就越狱成功了,因为你重启机器后会有cydia的软件在第二屏。根据他的提示下一步下一步就OK了。
当然需要更多的配置,比如:隐藏桌面图标、文件管理等等工具,就需要使用cydia提供的软件了。这里有一篇文章,介绍了很多常用工具,可以查看一下,文中有介绍几个source源需要通过cydia程序加进去(如果你采用了91助手,就更方便了)
文章地址:http://bbs.weiphone.com/read-htm-tid-820992.html
什么是Seoparking?
SEOparking是一个国外的免费自助建站服务网站。它不用自己设置布局,只要添加域名(不提供免费二级域名),再选择模板、设置SEO优化、自动更新什么类别的内容(也支持自己添加文章)、更新频率、更新数量、添加你的广告代码(不提供广告服务)就行了,完全自动化了,以后基本什么都不用管。
SEOparking不限建站数量,添加再多域名也没问题,还支持批量添加域名。
网址:http://www.seoparking.com
使用Seoparking要注意什么
在SEOparking时,请记住,仅支持顶级域名,二级域名是不行的,连.com.cn都不行,但.cn域名却可以,如果你有闲置的顶级域名可以试试SEOparking,没有也就不必注册了。
为什么要使用seoparking?
如果你有域名还不知道如何做时,你真的可以考虑使用Seoparking。因为在国内域名都要备案,而且现在的备案可能还要拍照。如果用国外的空间,能够绑定的域名也不会太多。所以seoparking就可以值得你试用一下。贴点广告代码,还能养养PR和alexa排名。何乐而不为?反正闲着也是闲着。
当然,有domain parking也可以考虑【国内好象没有很好的domain parking】
seoparking使用中有疑问怎么办?
SEOparking常见问题:http://www.seoparking.com/faq
SEOparking常见问题中文版:http://translate.google.cn/translate?…&sl=en&tl=zh-CN【google自动翻译,将就着看看喽】
--EOF--
介绍完上面的情况,我翻了翻我注册的域名,看来是可以考虑把这些域名放到Seoparking上面去了。正象我上面说的,反正,闲着也是闲着。
司徒正美,不用多介绍了吧?博客园上,JS牛人。就象他说的,取名叫ruby并不一定就是玩ruby的(额,好象没记错)
上原文吧,因为我对JS的了解还处于较初级的阶段,所以关注的就比较多了,原文来自:http://www.cnblogs.com/rubylouvre/archive/2010/02/11/1667364.html,原文有JS的执行功能,可以尝试。
请看以下两个函数:
function a(){
alert("a")
}
var b = function(){
alert("b")
}function a (){
alert("a")
}();//报错
var b = function(){
alert("b")
}();
(function foo(){}); // 表达式:注意它被包含在分组操作符中
var bar = function foo(){}; // 表达式,因为它是赋值表达式的一部分
new function bar(){}; // 表达式,因为它是New表达式的一部分给 function 外套一对括号(分组操作符)就不报错了,括号是表达式,是表达式就有返回值,所以可以在后面加一对括号让它们执行,再看
(function a (){
alert("a")
})();//没有问题
另外,我们知道,函数名的作用就是用来引用的,现在没用了,我们是不是可以把它去掉呢?
(function (){
alert(arguments.callee)
})();//弹出自身
知道这个,我们就可以方便地递归自身了。如弄一个深拷贝函数
var deepExtend = function(destination, source) {
for (var property in source) {
if (source[property] && source[property].constructor &&
source[property].constructor === Object) {
destination[property] = destination[property] || {};
arguments.callee(destination[property], source[property]);
} else {
destination[property] = source[property];
}
}
return destination;
};另外,从另一方便也启法了我们如何兼【廉】价地批量生产各种各样的自动执行函数。因为把函数转换为表达式的方法并不一定要靠分组操作符,我们还可以用 void操作符,~操作符,!操作符……
void function(){
alert("司徒正美");
}()

0, function(){
alert("司徒正美");
}();
-function(){
alert("司徒正美");
}();
+function(){
alert("司徒正美");
}();
!function(){
alert("司徒正美");
}();
~function(){
alert("司徒正美");
}();
typeof function(){
alert("司徒正美");
}();
--EOF--
自动执行函数确实有意思。。。
前两天说要上ipad越狱步骤的,结果也没有放出来。没办法,稍微有点事情。。。
OK开始上教程【我也是边看边做的】
IPAD越狱前,总要先备份一下SHSH文件。
系统要求:XP或者Win7操作系统,Itunes版本不能高于9.1 (所以想要越狱成功,千万不能手痒升级iTunes)【网上有人用itunes 9.2越狱成功,但目前不知道是否有后遗症】
软件准备:
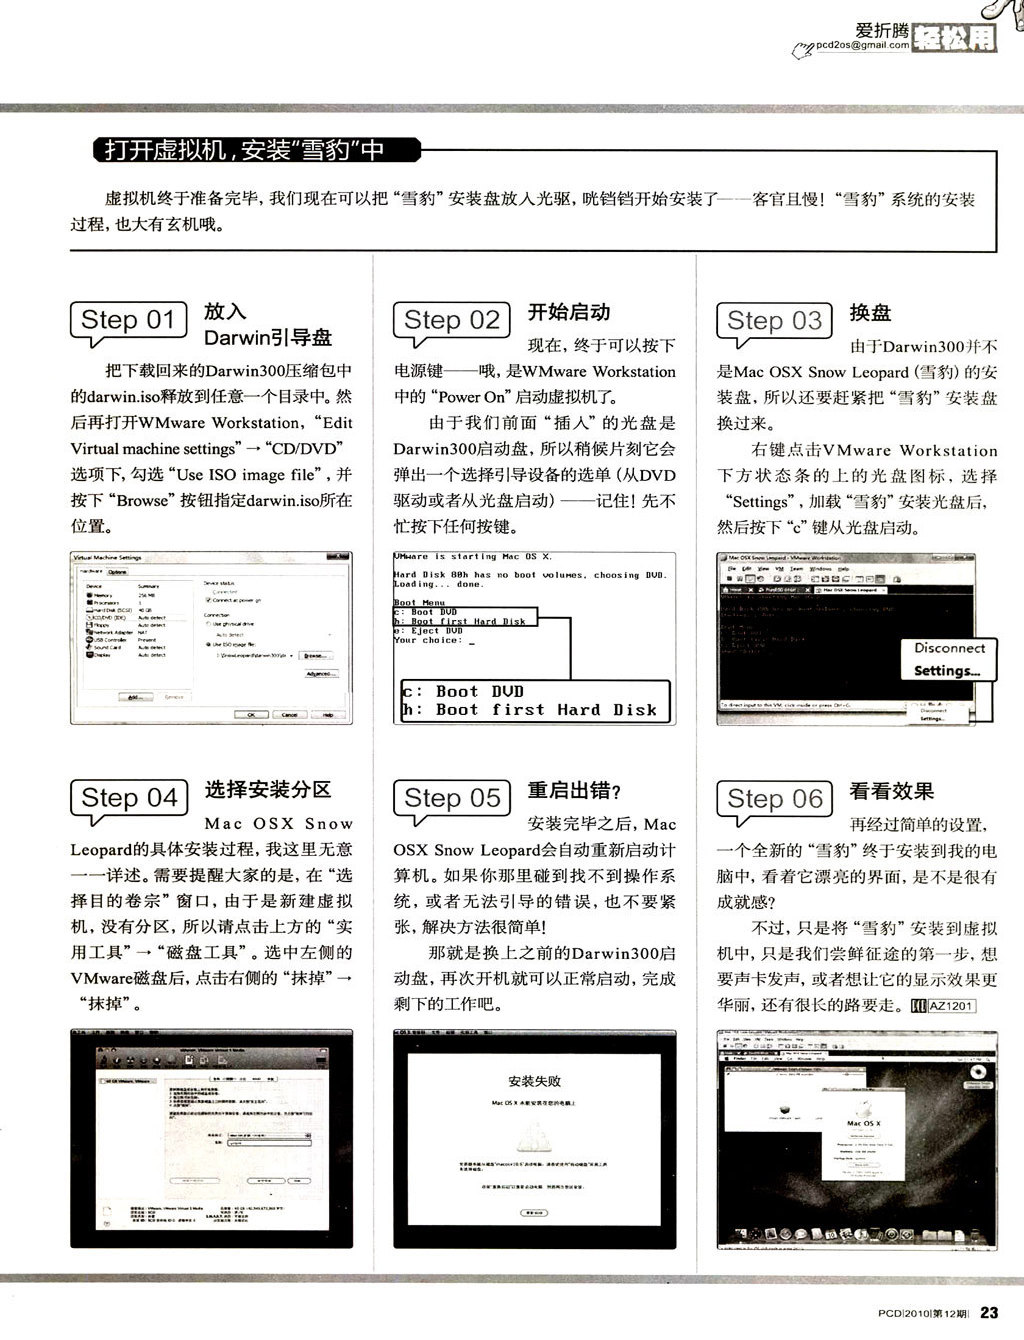
 【由于我讲的是win下面的方法,mac下的spirit就不提供了。】
实际操作:
第一步,让你的IPAD进入DFU模式(恢复模式)
(圆点+开/关机键直到IPAD黑屏,松开开/关机键大约7秒左右直到Itunes检测到连接为止,如图)
第二步,运行AutoSHSH_RC2.exe
出现窗口第一个点【确定】第二个点【是】
(这是第二个窗口)
点击是后,出来下面的窗口:
然后选择你的存储路径
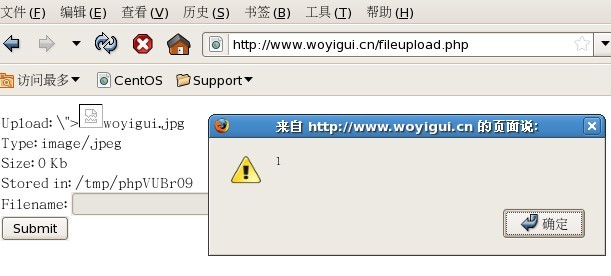
这样之后就算是你备份成功了。。下面就需要越狱了。
从PHP5.3起,也自带了匿名函数支持,只是它的支持并没有象js这样强大,风雪之隅测试过,可以查看:深入理解PHP之匿名函数,而这篇文章对于匿名函数和new Object以及new Function()的应用,作了较为详细的介绍和测试,如果你在开发中遇到这些问题,产生疑惑了,可以借鉴一下。
今天在园子里闲逛,看到wsxjr(很邪恶地联想到“我是下贱人”,晕)写的Javascript匿名函数的一种应用:封装一文,想起自己很久以前学习javascript的经历,也曾经碰到过几个由匿名函数造成的困扰(其中一个就是由闭包引起的),下面就整理几段简单代码讨论一下,让我们大家一起进步。
1、简单形式的封装调用
var userName = function() { return "jeff wong" } ();
alert(userName);var anonymousFunc = function() { return "jeff wong" }; //匿名函数
var name = anonymousFunc(); //执行该函数 返回人名
alert(name);var a = new Object();
var b = new Function();
//alert(typeof (a)); //object
//alert(typeof (b)); //function
alert(a); //[object Object]
alert(b); //匿名函数
//alert(a == b); //false
//alert(a === b); //false正如你所看到的那样,我们new一个Object,变量a弹出的是[object Object],而new一个Function(注意,是大写Function),b在弹出的时候,生成了匿名函数。 既然b是匿名函数,函数当然可以执行,我们可以继续试试下面的代码验证自己的猜测:
alert(b()); //undefined
alert(a()); //脚本错误 提示“缺少函数”
3、new 一下function也大有乾坤(小写function)
(1)、简单的空函数
var func = new function() { };
alert(typeof (func)); //object
alert(func); //[object Object]
//alert(func()); //脚本错误 func不是函数其实上面的代码也就等价于下面的写法:
function anonymousClass() { } //匿名类
var instance = new anonymousClass();
alert(typeof (instance));//object
alert(instance); //[object Object](2)、函数带个返回值的,也不是很难理解
var func = new function() { return "jeff wong" };
alert(typeof (func));
alert(func);
//alert(func()); //脚本错误 缺少函数其实上面的代码也就等价于下面的写法:
function anonymousClass() { return "jeff wong"; } //匿名类
var instance = new anonymousClass();
alert(typeof (instance));//object
alert(instance); //[object Object]
(3)、还是函数带个返回值的,写法稍微有点不同
下面的代码请注意和(2)中的区分一下,因为接下来要重点讨论的就是那一点点的不同书写形式:
var func = new function() { return new String("jeff wong"); };
alert(typeof (func)); //object 意料之中
alert(func); //这里?!
//alert(func()); //脚本错误 缺少函数上面代码的等价形式依然简单:
function anonymousClass() { return new String("jeff wong"); }
var instance = new anonymousClass();
alert(typeof (instance));
alert(instance);
已经运行看到结果了吗?没错,第三种写法我们在弹出func或者instance的时候,都出人意料地得到了一段字符串"jeff wong"。细心比较(2)和(3)中的代码,除了return处的写法稍有不同之外,两处代码几乎完全一致,所以我们推断,毫无疑问,是new String的形式让我们的函数产生了意想不到的效果。 为什么会这样呢?
原来,在javascript中,只要在new表达式之后的constructor返回(return)一个原始类型(无return时其实是return原始类型undefined,如(1)),比如第(2)种写法,那么就返回new创建的匿名对象;而如果new表达式之后的constructor返回一个引用对象,比如对象(Object),函数(function)及数组(Array)等等,那么返回的该引用对象就将覆盖new创建的匿名对象。现在再来分析(3)中的写法,由于new String会构造一个字符串引用对象,它就覆盖了new所创建的匿名对象,而new String的所指向引用值是“jeff wong”,所以弹出的必然是当前new String所分配的值。
最后,留个思考题,大家看看下面的代码返回什么结果:
var func = new function() { var str = new String("jeff wong"); return str; };//再换种写法
//alert(typeof (func)); //object 意料之中
alert(func); //猜一下这里应该是什么结果?
原文来自于:http://www.cnblogs.com/jeffwongishandsome/archive/2010/06/27/1766207.html
作者:Jeff Wong
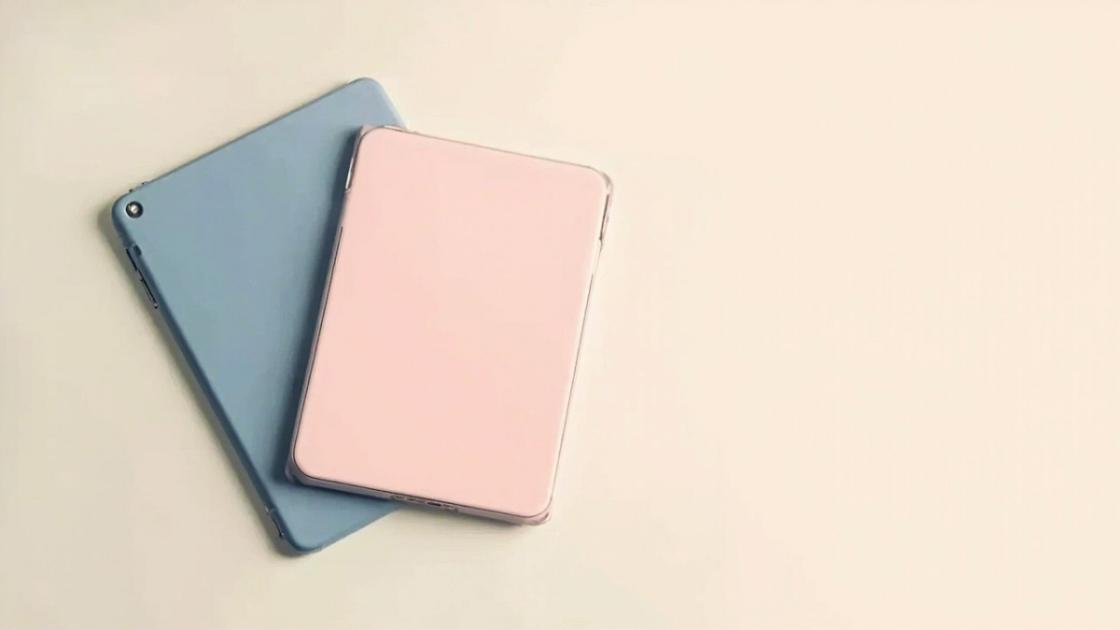
不多说了上图。。。顺便提一问,我的某PDF100多M的打不开,真痛苦。。。60多M的可以开,只是很慢。100多M的直接白屏。伤心啊,还是只能看小文件的PDF了。
开始上图吧。。【本来是想买yoobao的,但卖家说人家是做电池的不是做外包装的。于是换 了这个。当然我也知道可能这个利润更高一点。无所谓了,大家都开心就好。我看的舒服也就好了。。。】
包装盒
mysql-introduction-and-performance-optimization.ppt
外包装
张开双翼
台式书
让人意外的是这个标题:【Google爬虫:不仅索引链接,还可以运行js代码】,真的没想过,看看cnbeta怎么说的?
一直以来Google的搜索爬虫就具有阅读JavaScript代码的功能,但是多年以来我们一直都不清楚Google的爬虫是否真正理解了其正在抓取的 东西或者说它仅仅只是在易于理解的数据结构中对各种链接进行呆板的检索。本周五,一位Google的发言人向《福布斯》确认Google所作的远远超过对 js代码的简单分析。这位发言人表示:“Google能够分析并理解某些JavaScript”。
Google的表述让我们意识到其爬虫所作的工作也许不仅仅只是获得对页面的相关链接,还能够像人一样与各类程序发生互动——发现Bing这类搜索引擎所 不能发现的网络世界。而这意味着,Google重新定义了搜索引擎。在Google的搜索结果里面只有很少的js代码,而且Google也将这种js代码 的解释功能做了很多保留。比如在Google站点搜索(Google's Site Search)的文档显示其不能够索引带有js代码的内容。一本关于索引的入门教材这样写道:它(Google爬虫)“不能够处理带有富媒体的内容或者是 动态网页”。仔细检查服务器日志中的记录我们便可以发现Google现在索引那些并不是直接包含在js代码里面的链接,Google的爬虫只有确定自己能够运行部分代码的时候才能明白整段代码到底是什么意思。
Mark Drummond,一家独立搜索引擎公司Wowd的首席执行官(我们在今年之前的杂志中采访过他)在一封邮件中告诉我们理解js代码“是一个非常深刻、难度极大和一场经典的计算科学难题。”他解释道Google的努力在于它能够发现js代码在网页中是否存在停止运行的情况。 他表示“停止运行的问题是无法判定的”,他说迄今为止还没有已知的算法能够在任何程序的任何时间点告诉我们该程序是否陷入了死循环,而且数学上已经证明了 这一点。Drummond自己的公司通过人工的方式检索其索引并标明是否有可能简化这个复杂的问题,同时判断一个网络程序是否向另外的程序发起了数据请 求。也许,这正是Google现在在做的事情。
另一位同Google接近的搜索引擎人士也认同Drummond关于理解js代码复杂性的看法。他认为用一个程序去分析另一个程序是很困难的事情,执行js代码几乎是现阶段能够做到的极限了。
而Google在六月发布的改进版搜索算法(即Caffeine)似乎开始能够理解部分js代码了。如果这是真的,那么Google的工程师已经教会了其爬虫如何执行部分js代码。这真是一大突破!
cnBeta.com编译自Forbes
--EOF--
额。这样就比较有意思了。。JS也能够被解析?确实有点恐怖,未来会怎么样?真的是象浏览器一样的访问吗?他们也会兼容所有的浏览器吗?会。。。模拟登录吗?这才是我关心的,会识别验证码吗?
一般来说,限速这东西仅限于FTP,可以给FTP用户进行限速,但,如果你没有FTP,仅有HTTP的情况下如何呢?上次vampire演示过一段,同时还根据URL来读取文件的区块。事实上我们的需要没有那么复杂,向tom zheng博客上的这段就够我们用了。不是吗?再者,现在用nginx的机器应该很多了吧(我没有用,因为,我不可能为线上每个用户都去设置一遍他们的rewrite规则。只能将就一下了。)
原文来自:http://zys.8800.org/index.php/archives/322
nginx可以通过HTTPLimitZoneModule和HTTPCoreModule两个目录来限速。
示例:
limit_zone one $binary_remote_addr 10m;
location / {
limit_conn one 1;
limit_rate 100k;
}
说明:
limit_zone,是针对每个IP定义一个存储session状态的容器。这个示例中定义了一个10m的容器,按照32bytes/session,可以处理320000个session。
然后针对 /目录进行设定。
limit_conn one 1; 是限制每个IP只能发起一个连接。
limit_rate 100k; 是对每个连接限速100k. 注意,这里是对连接限速,而不是对IP限速。如果一个IP允许两个并发连接,那么这个IP就是限速limit_rate x 2。
关于limit_zone的原始文档,请见 http://wiki.nginx.org/NginxHttpLimitZoneModule
关于limit_rate和limit_conn的原始文档,请见 http://wiki.nginx.org/NginxHttpCoreModule
Facebook 的照片分享很受欢迎,迄今,Facebook 用户已经上传了150亿张照片,加上缩略图,总容量超过1.5PB,而每周新增的照片为2亿2000万张,约25TB,高峰期,Facebook 每秒处理55万张照片,这些数字让如何管理这些数据成为一个巨大的挑战。本文由 Facebook 工程师撰写,讲述了他们是如何管理这些照片的。
旧的 NFS 照片架构
老的照片系统架构分以下几个层:
# 上传层接收用户上传的照片并保存在 NFS 存储层。
# 照片服务层接收 HTTP 请求并从 NFS 存储层输出照片。
# NFS存储层建立在商业存储系统之上。
因为每张照片都以文件形式单独存储,这样庞大的照片量导致非常庞大的元数据规模,超过了 NFS 存储层的缓存上限,导致每次招聘请求会上传都包含多次I/O操作。庞大的元数据成为整个照片架构的瓶颈。这就是为什么 Facebook 主要依赖 CDN 的原因。为了解决这些问题,他们做了两项优化:
# Cachr: 一个缓存服务器,缓存 Facebook 的小尺寸用户资料照片。
# NFS文件句柄缓存:部署在照片输出层,以降低 NFS 存储层的元数据开销。
新的 Haystack 照片架构
新的照片架构将输出层和存储层合并为一个物理层,建立在一个基于 HTTP 的照片服务器上,照片存储在一个叫做 haystack 的对象库,以消除照片读取操作中不必要的元数据开销。新架构中,I/O 操作只针对真正的照片数据(而不是文件系统元数据)。haystack 可以细分为以下几个功能层:
# HTTP 服务器
# 照片存储
# Haystack 对象存储
# 文件系统
# 存储空间
存储
Haystack 部署在商业存储刀片服务器上,典型配置为一个2U的服务器,包含:
# 两个4核CPU
# 16GB – 32GB 内存
# 硬件 RAID,含256-512M NVRAM 高速缓存
# 超过12个1TB SATA 硬盘
每个刀片服务器提供大约10TB的存储能力,使用了硬件 RAID-6, RAID 6在保持低成本的基础上实现了很好的性能和冗余。不佳的写性能可以通过高速缓存解决,硬盘缓存被禁用以防止断电损失。
文件系统
Haystack 对象库是建立在10TB容量的单一文件系统之上。文件系统中的每个文件都在一张区块表中对应具体的物理位置,目前使用的文件系统为 XFS。
Haystack 对象库
Haystack 是一个简单的日志结构,存储着其内部数据对象的指针。一个 Haystack 包括两个文件,包括指针和索引文件:
Haystack 对象存储结构
指针和索引文件结构
Haystack 写操作
Haystack 写操作同步将指针追加到 haystack 存储文件,当指针积累到一定程度,就会生成索引写到索引文件。为了降低硬件故障带来的损失,索引文件还会定期写道存储空间中。
Haystack 读操作
传到 haystack 读操作的参数包括指针的偏移量,key,代用Key,Cookie 以及数据尺寸。Haystack 于是根据数据尺寸从文件中读取整个指针。
Haystack 删除操作
删除比较简单,只是在 Haystack 存储的指针上设置一个已删除标志。已经删除的指针和索引的空间并不回收。
照片存储服务器
照片存储服务器负责接受 HTTP 请求,并转换成相应的 Haystack 操作。为了降低I/O操作,该服务器维护着全部 Haystack 中文件索引的缓存。服务器启动时,系统就会将这些索引读到缓存中。由于每个节点都有数百万张照片,必须保证索引的容量不会超过服务器的物理内存。
对于用户上传的图片,系统分配一个64位的独立ID,照片接着被缩放成4种不同尺寸,每种尺寸的图拥有相同的随机 Cookie 和 ID,图片尺寸描述(大,中,小,缩略图)被存在代用key 中。接着上传服务器通知照片存储服务器将这些资料联通图片存储到 haystack 中。
每张图片的索引缓存包含以下数据
Haystack 使用 Google 的开源 sparse hash data 结构以保证内存中的索引缓存尽可能小。
照片存储的写/修改操作
写操作将照片数据写到 Haystack 存储并更新内存中的索引。如果索引中已经包含相同的 Key,说明是修改操作。
照片存储的读操作
传递到 Haystack 的参数包括 Haystack ID,照片的 Key, 尺寸以及 Cookie,服务器从缓存中查找并到 Haystack 中读取真正的数据。
照片存储的删除操作
通知 Haystack 执行删除操作之后,内存中的索引缓存会被更新,将便宜量设置为0,表示照片已被删除。
重新捆扎
重新捆扎会复制并建立新的 Haystack,期间,略过那些已经删除的照片的数据,并重新建立内存中的索引缓存。
HTTP 服务器
Http 框架使用的是简单的 evhttp 服务器。使用多线程,每个线程都可以单独处理一个 HTTP 请求。
结束语
Haystack 是一个基于 HTTP 的对象存储,包含指向实体数据的指针,该架构消除了文件系统元数据的开销,并实现将全部索引直接存储到缓存,以最小的 I/O 操作实现对照片的存储和读取。
本文国际来源:http://www.facebook.com/FacebookEngineering#/note.php?note_id=76191543919&ref=mf
中文翻译来源:COMSHARP CMS 官方网站
我的来源:http://zys.8800.org/index.php/archives/334
