易栈网-膘叔

浏览模式: 标准 | 列表 | 图文
What makes a good programmer?

What makes a good programmer?

本文来自nio's blog(nio?尼奥?黑客帝国?),原文如下:

What makes a good programmer?

Some casual surfing led me to this article from a couple of years ago, titled "How to recognize a good programmer". It was a nice read, but as many in the comments pointed out, the criteria the author set forth most likely describe himself and are not really useful as rules-of-thumb on how to recognize a good programmer.

It got me thinking though, on what are the attributes I consider useful in fellow programmers. So what makes a good programmer?

以下五项,按照优先级,你会怎样排序呢?

  • Security(安全性)
  • Maintainability(可维护性)
  • Usability(可用性)
  • Performance(性能)
  • LOC (lines-of-code) count(代码量)

作者认为最重要的是 usability,因为你开发的东西最终价值取决于最终用户。我们开发的目的是为了解决问题,如果解决不了问题,则说明项目是失败的。

Linux下安装TM2008

Linux下安装TM2008

正是因为看了这篇文章,我才能在linux下面使用TM进行聊天,以前都是使用虚拟机的。如今。我也可以直接在ubuntu下面聊天了。

内容如下[说明一下,本篇内容为精简版,如需查看完整版,请到http://rainux.org/running-tm2008-beta-with-wine]:

腾讯已经发布了官方的 QQ for Linux,虽然有很多问题,例如没有 amd64 版本,功能太弱,聊天记录格式与 Windows 下的 QQ/TM 格式不一致等等,但无疑是 Linux 里使用 QQ/TM 最简单的方案。如果它已经能满足你的需求了,那么不必浪费时间看本文。

精简版本

如果你没时间看我唠叨,精简的版本是:TM2008 Beta 运行需要 Unicode 版本的 IE6、rpcrt4.dll、Visual C++ 2005 SP1 运行库,安装程序需要 GDI+。不可以使用 IEs4Linux,因为它安装的 IE6 及相关运行库是 Win9x 的 ANSI 版本。必须使用 CrossOver Games 里的 rpcrt4.dll,然后用 winetricks 安装 msxml3 gdiplus riched20 riched30 ie6 vcrun6 vcrun2005sp1 即可安装运行 TM2008 Beta。

详细版本

只看精简版没搞定?请看详细的(唠叨的)版本:

安装 Wine,运行一下 winecfg,让它生成一个干净的 ~/.wine 目录。如果要使用已有的 ~/.wine,请先将其备份。同时确保 winecfg 里设置的 Windows 版本至少是 Windows 2000(我用的是 Wine 1.x 默认的 Windows XP)。

获取一份 CrossOver Games 里的 rpcrt4.dll, 将其复制为 ~/.wine/drive_c/windows/system32/rpcrt4.dll(覆盖已有的文件),运行 winecfg,在 Libraries -> DLL Overrides 里将 rpcrt4 设置为 Native (Windows)。

下载 winetricks,使用它安装 IE6 和一些重要的运行库。如果这个过程失败,删除 ~/.wine(或者恢复备份的 ~/.wine)并从头再来。

sh winetricks msxml3 gdiplus riched20 riched30 ie6 vcrun6 vcrun2005sp1

此时如果你有 Windows 上安装好的 TM2008,它已经可以运行了,但是无法登录,会提示“网络连接失败,请检查网络。”。所以还是老老实实用安装程序装一次吧。这里有个很莫名的问题,如 果直接使用 Wine 运行 TM2008 安装程序,它很可能会直接崩溃,看不到任何图形界面的提示。而使用 Wine 运行一个其它的程序,例如 cmd.exe 或者 Total Commander,再用这个程序去启动 TM2008 安装程序则不会有任何问题。

查看聊天记录时的性能问题

好了,现在不会有什么问题阻挡你了,TM2008 Beta 安装和启动都非常顺利,使用也很稳定。甚至 QQ2009 Preview4 都可以安装并启动,不过使用时很容易崩溃。但是如果你像我这样疯狂地保存了七八年的聊天记录,你会发现:

  • 每次启动 TM2008 后第一次给任何人发消息都会导致 TM2008 失去响应将近 20 秒钟,之后继续发消息则不会有问题。第一次接收到某人的消息也会同样如此。
  • 任何试图查看聊天记录的操作都会导致 TM2008 消耗 100% CPU 并且很长时间没有反应,等待足够长的时间后才可以看到聊天记录。

这是由于 TM2008 的聊天记录数据库使用了 Windows 的 Structured Storage 技术,而其 API 库 ole32.dll 的 Wine 实现还不完善或者可能性能太低。虽然可以用 winetricks 安装 dcom98 来获取一个 Win9x 的 ANSI 版本的 ole32.dll,但它没法让 Unicode 版本的 TM2008 运行起来。搜遍了网络也找不到在 Wine 里使用 Win2k 以上系统的 ole32.dll 的方法。没办法,为了保持聊天记录的一致性,只有两个选择。要么不在 Linux 里看聊天记录;要么把聊天记录数据库 Msg2.0.db 备份并从 QQ Profile 目录(我的文档\QQ Files\QQ 号码)里删除,让 TM2008 自己生成一个空白的 Msg2.0.db,暂时抛弃历史包袱,以后再到 Windows 下把新的记录导出为备份文件后合并到老的数据库里。

整理:详解javascript function中的caller,callee,call,apply

整理:详解javascript function中的caller,callee,call,apply

膘叔:如果不了解javascript的话,你可以尝试看一下PHP,在PHP中有三个函数:
func_get_arg(),func_get_args(),func_get_num(),这三个函数是用来处理PHP中某个方法参数不固定的时候的行为。你可以将它当作是伪重载(overload)的另一种处理方法。也可以用来更改某个函数的默认行为。

javascript中也有类似的方法,那就是callee,caller等 。以下是playgoogle网站的整理内容,作者为karry,可以参考一下。

caller

返回一个对函数的引用,该函数调用了当前函数。也就是说,返回的是调用该函数的函数。
functionName.caller
functionName 对象是所执行函数的名称。

说明
对 于函数来说,caller 属性只有在函数执行时才有定义。如果函数是由顶层调用的,那么 caller 包含的就是 null 。如果在字符串上下文中使用 caller 属性,那么结果和 functionName.toString 一样,也就是说,显示的是函数的反编译文本。值得注意的一点是,事件的触发总是带着一个匿名的函数。

点击查看--caller测试示例


callee

返 回正被执行的 Function 对象,也就是所指定的 Function 对象的正文,他是arguments对象的一个属性。[function.]arguments.callee,可选项 function 参数是当前正在执行的 Function 对象的名称。

说明
callee 属性的初始值就是正被执行的 Function 对象。

callee 属性是 arguments 对象的一个成员,它表示对函数对象本身的引用,这有利于匿名函数的递归或者保证函数的封装性,例如下边示例的递归计算1到n的自然数之和。而该属性仅当相 关函数正在执行时才可用。还有需要注意的是callee拥有length属性,这个属性有时候用于验证还是比较好的。arguments.length是 实参长度,arguments.callee.length是形参长度,由此可以判断调用时形参长度是否和实参长度一致。

点击查看--callee测试示例

apply and call
它们的作用都是将函数绑定到另外一个对象上去运行,两者仅在定义参数方式有所区别:
apply(thisArg,argArray);
call(thisArg[,arg1,arg2…] ]);
即所有函数内部的this指针都会被赋值为thisArg,这可实现将函数作为另外一个对象的方法运行的目的

apply的说明
如果 argArray 不是一个有效的数组或者不是 arguments 对象,那么将导致一个 TypeError。如果没有提供 argArray 和 thisArg任何一个参数,那么 Global 对象将被用作 thisArg,并且无法被传递任何参数。

call的说明
call 方法可将一个函数的对象上下文从初始的上下文改变为由 thisArg指定的新对象。如果没有提供 thisArg参数,那么 Global 对象被用作 thisArg

相关技巧:
应用call和apply还有一个技巧在里面,就是用call和apply应用另一个函数(类)以后,当前的
函数(类)就具备了另一个函数(类)的方法或者是属性,这也可以称之为“继承”。

点击查看--call 和 apply 测试示例

Linux下清除.svn目录

Linux下清除.svn目录

SVN给开发带来了方便,但在导出的时候,如果选择了checkout,那么目录里是带有.svn目录的,除非是export。

如果您的项目中是checkout的,如果还要export,那就烦了一点。因为export是从服务器上导回来的。如果服务器速度慢(网上的免费SVN服务器),那就更痛苦了。因此直接删除.svn目录是最快的解决方法。

windows下面可以直接搜索.svn,然后delete就行了
linux下面怎么办?

其实更方便,只要一句话
进入项目目录后,运行 find . -name ".svn" | xargs rm -rf
然后你就会发现。.svn目录全没有了。HOHO

查了一下google,发现还有另外一个方法:

find -name "CVS" -exec rm -f {} \;

利用-name和-exec两个参数组合,可以实现批量查找删除指定文件的目的。

要活用find,它是很强大的。

find [path...] [expression]

-name pattern
Base of file name (the path with the leading directories removed) matches shell pattern pattern. The metacharacters (`*', `?', and `[]') do not match a `.' at the start of the base name. To ignore a directory and the files under it, use -prune; see an example in the description of -path.

-exec command ;
Execute command; true if 0 status is returned. All following arguments to find are taken to be arguments to the command until an argument consisting of `;' is encountered. The string `{}' is replaced by the current file name being processed everywhere it occurs in the arguments to the command, not just in arguments where it is alone, as in some versions of find. Both of these constructions might need to be escaped (with a `\') or quoted to protect them from expansion by the shell. The command is executed in the starting directory.

js中的分号引起的语义变化

膘叔:我的JS不太好,所以觉得可以学习一下。
原文如下:
js一直以其松散而著称,然后,很多时候,然,童鞋们,不要误解松散的字面意思,松散但是其词法结构,而不是书写习惯,如果果真误解了,会将自己领入一个自己的松散编织的咒语。

上次写的那个jquery的屏蔽层的, 因为我用的
(function(){})(jquery)
方式
我后面想, 如果想再写个插件的话就要

(function(){})(jquery)

(function(){})(jquery)
于是,我调试了下,轰, 脚本报错 了,,,,同时我改传window的作用域来 实验
(function(scope){})(window)
依然 “页面脚本错误” 斗大的报错信息郝然眼底
到这里,我犯了个不可饶恕的低级错误,也许这个错误同样的很多同学也会步这个后尘,细心的你发现了么,当然,也许你一眼就发现了我的问题出在哪里了,因为我这确实是犯的个低级错误!
js 是函数式的语言,在js中,()具有二意性,
意一为表达式中的提高优先级别 比如 (a+b)*c
那该运算表达式优先计算a+b
意二 则为函数调用比如(function(){})()
上面的后面()即为匿名函数(function(){})的调用
如果上面的空匿名函数换成这样
(function(){
return function(){
alert("自由是现实的,现实是操蛋的")
}
})()
首先这个匿名方法返回一个function
如果在后面在加个() 比如这样
(function(){
return function(){
alert("自由是现实的,现实是操蛋的")
}
})()
(function(){})
后面在加一个()里面带一个匿名函数。
系统就会把这个()当成是前面返回的那个匿名函数的调用表达式,而里面的空function(){}则被当做参数提交了。
到这里,前面我不小心弄出来的那个 斗大的报错信息 恍然大悟。
我一直和自己说,注重细节,细节决定成败,然而却一直都忽略了这个问题,每一句表达式后一定要加;来断句,这是个良好习惯,只是一直以来都没有引发问题而已,这里,我不得不深刻反省,犯如此之低级错误,真应该做深刻的检讨,上cctv,上新闻联播,向全国人民道歉!
谁动了我的分号


-------------------------------------------------------------------------------------------
本文链接: http://www.cnblogs.com/litao229/archive/2009/07/24/1530375.html

带你深入了解Web站点数据库的分布存储【转帖】

带你深入了解Web站点数据库的分布存储【转帖】

我是从SA Notes转载的,因此,虽然本文属于他转载的内容,但我仍然感谢 Sa Notes的转载,否则我也看不到此内容。

原文如下:

转自:http://database.csdn.net/page/b12503e6-9f14-4cc1-90dd-88632444a46e

在Web 2.0时代,网站将会经常面临着快速增加的访问量,但是我们的应用如何满足用户的访问需求,而且基本上我们看到的情况都是性能瓶颈都是在数据库上,这个不 怪数据库,毕竟要满足很大访问量确实对于任何一款数据库都是很大的压力,不论是商业数据库Oracle、MS sql Server、DB2之类,还是开源的MySQL、PostgreSQL,都是很大的挑战,解决的方法很简单,就是把数据分散在不同的数据库上(可以是硬 件上的,也可以是逻辑上的),本文就是主要讨论如何数据库分散存储的的问题。

目前主要分布存储的方式都是按照一定的方式进行切分,主要是垂直切分(纵向)和水平切分(横向)两种方式,当然,也有两种结合的方式,达到更贴切的切分粒度。

1. 垂直切分(纵向)数据是数据库切分按照网站业务、产品进行切分,比如用户数据、博客文章数据、照片数据、标签数据、群组数据等等每个业务一个独立的数据库或者数据库服务器。

2. 水平切分(横向)数据是把所有数据当作一个大产品,但是把所有的平面数据按照某些Key(比如用户名)分散在不同数据库或者数据库服务器上,分散对数据访问的压力,这种方式也是本文主要要探讨的。

本文主要针对的的 MySQL/PostgreSQL 类的开源数据库,同时平台是在 linux/FreeBSD,使用 php/Perl/Ruby/Python 等脚本语言,搭配 Apache/Lighttpd 等Web服务器 的平台下面的Web应用,不讨论静态文件的存储,比如视频、图片、CSS、JS,那是另外一个话题。

说明:下面将会反复提到的一个名次“节点”(Node),指的是一个数据库节点,可能是物理的一台数据库服务器,也可能是一个数据库,一般情况是指一台数据库服务器,并且是具有 Master/Slave 结构的数据库服务器,我们查看一下图片,了解这样节点的架构:

一、基于散列的分布方式

1. 散列方式介绍

基于散列(Hash)的分布存储方式,主要是依赖主要Key和散列算法,比如以用户为主的应用主要的角色就是用户,那么做Key的就可以是用户ID 或者是用 户名、邮件地址之类(该值必须在站点中随处传递),使用这个唯一值作为Key,通过对这个Key进行散列算法,把不同的用户数据分散在不同的数据库节点 (Node)上。

我们通过简单的实例来描述这个问题:比如有一个应用,Key是用户ID,拥有10个数据库节点,最简单的散列算法是我们 用户ID数模以我们所有节点数,余数就是对应的节点机器,算法:所在节点 = 用户ID % 总节点数,那么,用户ID为125的用户所在节点:125 % 10 = 5,那么应该在名字为5的节点上。同样的,可以构造更为强大合理的Hash算法来更均匀的分配用户到不同的节点上。

2. 散列分布存储方式的扩容

我们知道既然定义了一个散列算法,那么这些Key就会按部就班的分散到指定节点上,但是如果目前的所有节点不够满足要求怎么办?这就存在一个扩容的问题,扩容首当其冲的就是要修改散列算法,同时数据也要根据散列算法进修迁移或者修改。

(1) 迁移方式扩容:修 改散列算法以后,比如之前是10个节点,现在增加到20个节点,那么Hash算法就是[模20],相应的存在一个以前的节点被分配的数据会比较多,但是新 加入的节点数据少的不平衡的状态,那么可以考虑使用把以前数据中的数据按照Key使用新的Hash算法进行运算出新节点,把数据迁移到新节点,缺点但是这 个成本相应比较大,不稳定性增加;好处是数据比较均匀,并且能够充分利用新旧节点。

(2) 充分利用新节点:增 加新节点以后,Hash算法把新加入的数据全部Hash到新节点上,不再往旧节点上分配数据,这样不存在迁移数据的成本。优点是只需要修改Hash算法, 无须迁移数据就能够简单的增加节点,但是在查询数据的时候,必须使用考虑到旧Key使用旧Hash算法,新增加的Key使用新的Hash算法,不然无法查 找到数据所在节点。缺点很明显,一个是Hash算法复杂度增加,如果频繁的增加新节点,算法将非常复杂,无法维护,另外一个方面是旧节点无法充分利用资源 了,因为旧节点只是单纯的保留旧Key数据,当然了,这个也有合适的解决方案。

总结来说,散列方式分布数据,要新增节点比较困难和繁琐,但是也有很多适合的场合,特别适合能够预计到未来数据量大小的应用,但是普遍 Web2.0 网站都无法预计到数据量。

二、基于全局节点分配方式

1. 全局节点分配方式介绍

就是把所有Key信息与数据库节点之间的映射关系记录下来,保存到全局表中,当需要访问某个节点的时候,首先去全局表中查找,找到以后再定位到相应节点。全局表的存储方式一般两种:

(1) 采用节点数据库本身(MySQL/PostgreSQL)存储节点信息,能够远程访问,为了保证性能,同时配合使用 Heap(MEMORY) 内存表,或者是使用 Memcached 缓存方式来缓存,加速节点查找

(2) 采用 BDB(BerkeleyDB)、DBM/GDBM/NDBM 这类本地文件数据库,基于 key=>value 哈希数据库,查找性能比较高,同时结合 APC、Memcached 之类的缓存加速。

第 一种存储方式是容易查询(包括远程查询),缺点是性能不太好(这个是所有关系型数据库的通病);第二种方式的有点是本地查询速度很快(特别是hash型数 据库,时间复杂度是O(1),比较快),缺点是无法远程使用,并且无法在多台机器中间同步共享数据,存在数据一致的情况。

我们来描述实施 大概结构:假如我们有10个数据库节点,一个全局数据库用于存储Key到节点的映射信息,假设全局数据库有一个表叫做 AllNode ,包含两个字段,Key 和 NodeID,假设我们继续按照上面的案例,用户ID是Key,并且有一个用户ID为125的用户,它对应的节点,我们查询表获得:

Key NodeID
13 2
148 5
22 9
125 6

可以确认这个用户ID为125的用户,所在的节点是6,那么就可以迅速定位到该节点,进行数据的处理。

我们来查看一下分布存储结构图:

2. 全局节点分布方式的扩容

全局节点分配方式同样存在扩容的问题,不过它早就考虑到这个问题,并且这么设计就是为了便于扩容,主要的扩容方式是两种:

(1) 通过节点自然增加来分配Key到节点的映射扩容

这 种是最典型、最简单、最节约机器资源的扩容方式,大致就是按照每个节点分配指定的数据量,比如一个节点存储10万用户数据,第一个节点存储0-10w用户 数据,第二个节点存储10w-20w用户数据,第三个节点存储20w-30w用户信息,依此类推,用户增加到一定数据量就增加节点服务器,同时把Key分 配到新增加的节点上,映射关系记录到全局表中,这样可以无限的增加节点。存在的问题是,如果早期的节点用户访问频率比较低,而后期增加的节点用户访问频率 比较高,则存在节点服务器负载不均衡的现象,这个也是可以想方案解决的。

(2) 通过概率算法来映射Key到节点的的扩容

这种方式是在既然有的节点基础上,给每个节点设定一个被分配到Key的概率,然后分配Key的时候,按照每个节点被指定的概率进行分配,如果每个节点平均的数据容量超过了指定的百分比,比如50%,那么这时候就考虑增加新节点,那么新节点增加Key的概率要大于旧节点。

一般情况下,对于节点的被分配的概率也是记录在数据库中的,比如我们把所有的概率为100,共有10个节点,那么设定每个节点被分配的数据的概率为10,我们查看数据表结构:

NodeID Weight
1 10
2 10
3 10

现在新加入了一个 节点,新加入的节点,被分配Key的几率要大于旧节点,那么就必须对这个新加入的节点进行概率计算,计算公式:10х+у=100, у>х,得出:у{10...90},х{1...9},x是单个旧节点的概率,旧节点的每个节点的概率是一样的,y是新节点的概率,按照这个计算 公式,推算出新节点y的概率的范围,具体按照具体不同应用的概率公式进行计算。

三、存在的问题

现在我们来分析和解决一下我们上面两种分布存储方式的存在的问题,便于在实际考虑架构的时候能够避免或者是融合一些问题和缺点。

1. 散列和全局分配方式都存在问题

(1) 散列方式扩容不是很方便,必须修改散列算法,同时可能还需要对数据进行迁移,它的优点是从Key定位一个节点非常快,O(1)的时间复杂度,而且基本不需要查询数据库,节约响应时间。

(2) 全局分配方式存在的问题最明显的是单点故障,全局数据库down掉将影响所有应用。另外一个问题是查询量大,对每个Key节点的操作都必须经过全局数据库,压力很大,优点是扩容方便,增加节点简单。

2. 分布存储带来的搜索和统计问题

(1) 一般搜索或统计都是对所有数据进行处理,但因为拆分以后,数据分散在不同节点机器上,无法进行全局查找和统计。解决方案一是对主要的基础数据存储在全局表中,便于查找和统计,但这类数据不宜太多,部分核心数据。

(2) 采用站内搜索引擎来索引和记录全部数据,比如采用 Lucene 等开源索引系统进行所有数据的索引,便于搜索。 对于统计操作可以采用后台非实时统计,可采用遍历所有节点的方式,但效率低下。

3. 性能优化问题

(1) 散列算法,节点概率和分配等为了提高性能都可以使用编译语言开发,做成lib或者是所有php扩展形式。

(2) 对于采用 MySQL 的情况,可以采用自定义的数据库连接池,采用 Apache Module 形式加载,能够自由定制的采用各种连接方式。

(3) 对于全局数据或都频繁访问的数据,可以采用APC、Memcache、DBM、BDB、共享内存、文件系统等各种方式进行缓存,减少数据库的访问压力。

(4) 采用数据本身的强大处理机制,比如 MySQL5 的表分区或者是 MySQL5 的Cluster 。另外建议在实际架构中采用InnoDB表引擎作为主要存储引擎,MyISAM作为一些日志、统计数据等场合,不论在安全、可靠性、速度都有保障。
Table2CSS Converter

Table2CSS Converter

说实话没有试用过,但是看介绍并且相信一下汉化新世纪。所以。推荐一下下

做网页,如今 都习惯于采用xhtml+css了吧?当然对于我这样习惯table套table的原始人物,这个工具仿佛不错。。

介绍就足够吸引人了:
Table2CSS是一款可以将表格布局网页完美转换 成DIV+CSS方式的软件。支持外部CSS,支持网页及目录 批量转换。

01add96af4c6b82cf486b456f6c6d34a
下载地址:
58b0c6fbbf006a28e80abf1c100660eb
php Socket 基础

php Socket 基础

纯参考,突然让我想起以前的ugia.cn提供的upu(还是ugu来着?不记得了)上传组件。
利用socket监听,然后上传,利用流来写入文件。值得参考一下,想着ASP可以利用 xmlhttp进行大文件上传,想来PHP应该也可以,啥时候研究一下。
以下内容就是socket的初学者要看的文章,我也要看。呵呵

内容如下,未做删减 http://phpsoho.com/article/php/200809/11-245.html
PHP使 用Berkley的socket库来创建它的连接。socket只不过是一个数据结构。你使用这个socket数据结构去开始一个客户端和服务器之间的会 话。这个服务器是一直在监听准备产生一个新的会话。当一个客户端连接服务器,它就打开服务器正在进行监听的一个端口进行会话。这时,服务器端接受客户端的 连接请求,那么就进行一次循环。现在这个客户端就能够发送信息到服务器,服务器也能发送信息给客户端。
产生一个Socket,你需要三个变量:一个协议、一个socket类型和一个公共协议类型。产生一个socket有三种协议供选择,继续看下面的内容来获取详细的协议内容。
定义一个公共的协议类型是进行连接一个必不可少的元素。下面的表我们看看有那些公共的协议类型。

表一:协议

名字/常量 描述
AF_INET 这是大多数用来产生socket的协议,使用TCP或UDP来传输,用在IPv4的地址
AF_INET6 与上面类似,不过是来用在IPv6的地址
AF_UNIX 本地协议,使用在Unix和Linux系统上,它很少使用,一般都是当客户端和服务器在同一台机器上的时候使用

表二:Socket类型

名字/常量 描述
SOCK_STREAM 这个协议是按照顺序的、可靠的、数据完整的基于字节流的连接。这是一个使用最多的socket类型,这个socket是使用TCP来进行传输。
SOCK_DGRAM 这个协议是无连接的、固定长度的传输调用。该协议是不可靠的,使用UDP来进行它的连接。
SOCK_SEQPACKET 这个协议是双线路的、可靠的连接,发送固定长度的数据包进行传输。必须把这个包完整的接受才能进行读取。
SOCK_RAW 这个socket类型提供单一的网络访问,这个socket类型使用ICMP公共协议。(ping、traceroute使用该协议)
SOCK_RDM 这个类型是很少使用的,在大部分的操作系统上没有实现,它是提供给数据链路层使用,不保证数据包顺序

表三:公共协议

名字/常量 描述
ICMP 互联网控制消息协议,主要使用在网关和主机上,用来检查网络状况和报告错误信息
UDP 用户数据报文协议,它是一个无连接,不可靠的传输协议
TCP 传输控制协议,这是一个使用最多的可靠的公共协议,它能保证数据包能够到达接受者那儿,如果在传输过程中发生错误,那么它将重新发送出错数据包。
现 在你知道了产生一个socket的三个元素,那么我们就在php中使用socket_create()函数来产生一个socket。这个 socket_create()函数需要三个参数:一个协议、一个socket类型、一个公共协议。socket_create()函数运行成功返回一个 包含socket的资源类型,如果没有成功则返回false。
Resourece socket_create(int protocol, int socketType, int commonProtocol);
现在你产生一个socket,然后呢?php提供了几个操纵socket的函数。你能够绑定socket到一个IP,监听一个socket的通信,接受一个socket;现在我们来看一个例子,了解函数是如何产生、接受和监听一个socket。

$commonProtocol = getprotobyname(“tcp”);//使用公共协议名字来获取一个协议类型
$socket = socket_create(AF_INET, SOCK_STREAM, $commonProtocol);//产生一个socket并且返回一个socket资源的实例
socket_bind($socket, ‘localhost’, 1337);//绑定socket到本地计算机
socket_listen($socket);//监听所有进来的socket连接
// More socket functionality to come

面这个例子产生一个你自己的服务器端。例子第一行

$commonProtocol = getprotobyname(“tcp”);

使用公共协议名字来获取一个协议类型。在这里使用的是TCP公共协议,如果你想使用UDP或者ICMP协议,那么你应该把 getprotobyname()函数的参数改为“udp”或“icmp”。还有一个可选的办法是不使用getprotobyname()函数而是指定 SOL_TCP或SOL_UDP在socket_create()函数中。
$socket = socket_create(AF_INET, SOCK_STREAM, SOL_TCP);
例子的第二行是产生一个socket并且返回一个socket资源的实例。在你有了一个socket资源的实例以后,你就必须把socket绑定到一个IP地址和某一个端口上。

socket_bind($socket, ‘localhost’, 1337);


在这里你绑定socket到本地计算机(127.0.0.1)和绑定socket到你的1337端口。然后你就需要监听所有进来的socket连接。

socket_listen($socket);


在第四行以后,你就需要了解所有的socket函数和他们的使用。

表四:Socket函数

函数名      描述
socket_accept() 接受一个Socket连接
socket_bind() 把socket绑定在一个IP地址和端口上
socket_clear_error() 清除socket的错误或者最后的错误代码
socket_close() 关闭一个socket资源
socket_connect() 开始一个socket连接
socket_create_listen() 在指定端口打开一个socket监听
socket_create_pair() 产生一对没有区别的socket到一个数组里
socket_create() 产生一个socket,相当于产生一个socket的数据结构
socket_get_option() 获取socket选项
socket_getpeername() 获取远程类似主机的ip地址
socket_getsockname() 获取本地socket的ip地址
socket_iovec_add() 添加一个新的向量到一个分散/聚合的数组
socket_iovec_alloc() 这个函数创建一个能够发送接收读写的iovec数据结构
socket_iovec_delete() 删除一个已经分配的iovec
socket_iovec_fetch() 返回指定的iovec资源的数据
socket_iovec_free() 释放一个iovec资源
socket_iovec_set() 设置iovec的数据新值
socket_last_error() 获取当前socket的最后错误代码
socket_listen() 监听由指定socket的所有连接
socket_read() 读取指定长度的数据
socket_readv() 读取从分散/聚合数组过来的数据
socket_recv() 从socket里结束数据到缓存
socket_recvfrom() 接受数据从指定的socket,如果没有指定则默认当前socket
socket_recvmsg() 从iovec里接受消息
socket_select() 多路选择
socket_send() 这个函数发送数据到已连接的socket
socket_sendmsg() 发送消息到socket
socket_sendto() 发送消息到指定地址的socket
socket_set_block() 在socket里设置为块模式
socket_set_nonblock() socket里设置为非块模式
socket_set_option() 设置socket选项
socket_shutdown() 这个函数允许你关闭读、写、或者指定的socket
socket_strerror() 返回指定错误号的详细错误
socket_write() 写数据到socket缓存
socket_writev() 写数据到分散/聚合数组

以上所有的函数都是PHP中关于socket的,使用这些函数,你必须把你的socket打开,如果你没有打开,请编辑你的php.ini文件,去掉下面这行前面的注释:

extension=php_sockets.dll

如果你无法去掉注释,那么请使用下面的代码来加载扩展库:

if(!extension_loaded(‘sockets’))
{
if(strtoupper(substr(PHP_OS, 3)) == “WIN”)
{
dl(‘php_sockets.dll’);
}else{
dl(‘sockets.so’);
}
}

如果你不知道你的socket是否打开,那么你可以使用phpinfo()函数来确定socket是否打开。你通过查看phpinfo信息了解socket是否打开。
查看phpinfo()关于socket的信息

◆ 产生一个服务器

现在我们把第一个例子进行完善。你需要监听一个指定的socket并且处理用户的连接。

$commonProtocol = getprotobyname("tcp");
$socket = socket_create(AF_INET, SOCK_STREAM, $commonProtocol);
socket_bind($socket, 'localhost', 1337);
socket_listen($socket);
// Accept any incoming connections to the server
$connection = socket_accept($socket);
if($connection){
socket_write($connection, "You have connected to the socket...\n\r");
}

你应该使用你的命令提示符来运行这个例子。理由是因为这里将产生一个服务器,而不是一个Web页面。如果你尝试使用Web浏览器来运行这个脚本,那么很有可能它会超过30秒的限时。你可以使用下面的代码来设置一个无限的运行时间,但是还是建议使用命令提示符来运行。

set_time_limit(0);

在你的命令提示符中对这个脚本进行简单测试:

Php.exe example01_server.php

如果你没有在系统的环境变量中设置php解释器的路径,那么你将需要给php.exe指定详细的路径。当你运行这个服务器端的时候,你能够通过远程登陆(telnet)的方式连接到端口1337来测试这个服务器。

上面的服务器端有三个问题:

1. 它不能接受多个连接。
2. 它只完成唯一的一个命令。
3. 你不能通过Web浏览器连接这个服务器。

这个第一个问题比较容易解决,你可以使用一个应用程序去每次都连接到服务器。但是后面的问题是你需要使用一个Web页面去连接这个服务器,这个比较困难。你可以让你的服务器接受连接,然后些数据到客户端(如果它一定要写的话),关闭连接并且等待下一个连接。
在上一个代码的基础上再改进,产生下面的代码来做你的新服务器端:

// Set up our socket 
$commonProtocol = getprotobyname("tcp");
$socket = socket_create(AF_INET, SOCK_STREAM, $commonProtocol);
socket_bind($socket, 'localhost', 1337); //socket_bind() 把socket绑定在一个IP地址和端口上
socket_listen($socket);
// Initialize the buffer
$buffer = "NO DATA";
while(true) {
// Accept any connections coming in on this socket
$connection = socket_accept($socket);//socket_accept() 接受一个Socket连接
printf("Socket connected\r\n");
// Check to see if there is anything in the buffer
if($buffer != ""){
printf("Something is in the buffer...sending data...\r\n");
socket_write($connection, $buffer . "\r\n"); //socket_write() 写数据到socket缓存
printf("Wrote to socket\r\n");
}else {
printf("No Data in the buffer\r\n");
}
// Get the input
while($data = socket_read($connection, 1024, PHP_NORMAL_READ))//socket_read() 读取指定长度的数据
{
$buffer = $data;
socket_write($connection, "Information Received\r\n");
printf("Buffer: " . $buffer . "\r\n");
}
socket_close($connection); //socket_close() 关闭一个socket资源
printf("Closed the socket\r\n\r\n");
}

这个服务器端要做什么呢?它初始化一个socket并且打开一个缓存收发数据。它等待连接,一旦产生一个连接,它将打印“Socket connected”在服务器端的屏幕上。这个服务器检查缓冲区,如果缓冲区里有数据,它将把数据发送到连接过来的计算机。然后它发送这个数据的接受信 息,一旦它接受了信息,就把信息保存到数据里,并且让连接的计算机知道这些信息,最后关闭连接。当连接关闭后,服务器又开始处理下一次连接。


◆ 产生一个客户端


处理第二个问题是很容易的。你需要产生一个php页连接一个socket,发送一些数据进它的缓存并处理它。然后你有个处理后的数据在还顿,你能够发送你的数据到服务器。在另外一台客户端连接,它将处理那些数据。
下面的例子示范了使用socket:

// Create the socket and connect 
$socket = socket_create(AF_INET, SOCK_STREAM, SOL_TCP);
$connection = socket_connect($socket,’localhost’, 1337);
while($buffer = socket_read($socket, 1024, PHP_NORMAL_READ)) {
if($buffer == “NO DATA”) {
echo(“<p>NO DATA</p>”);
break;
}else{
// Do something with the data in the buffer
echo(“<p>Buffer Data: “ . $buffer . “</p>”);
}
}
echo(“<p>Writing to Socket</p>”);
// Write some test data to our socket
if(!socket_write($socket, “SOME DATA\r\n”)){
echo(“<p>Write failed</p>”);
}
// Read any response from the socket
while($buffer = socket_read($socket, 1024, PHP_NORMAL_READ)){
echo(“<p>Data sent was: SOME DATA<br> Response was:” . $buffer . “</p>”);
}
echo(“<p>Done Reading from Socket</p>”);

这个例子的代码演示了客户端连接到服务器。客户端读取数据。如果这是第一时间到达这个循环的首次连接,这个服务器将发送“NO DATA”返回给客户端。如果情况发生了,这个客户端在连接之上。客户端发送它的数据到服务器,数据发送给服务器,客户端等待响应。一旦接受到响应,那么 它将把响应写到屏幕上。

纯CSS无hacks的跨游览器多列布局

CSS在我的网站上没有分类,因此我也不知道怎么放就扔到javascript里了。权且当成前端分类吧?哈哈,自我安慰一下
CSS我实在不熟,所以看到有好的东西,都会暂时的收藏。

作者是司徒正美(老是让我想起车田正美,不知道的人,估计和我不是同一年代的。OHOHOH)

内容如下:

翻译自Matthew James Taylor的Equal Height Columns with Cross-Browser CSS and No Hacks,有些部分根据我的理解改了,让一些初心者更好理解。

利用纯CSS创建一个等高多列的布局并不件易事,本教程将着重分析出现在多列布局的多个问题,然后为大家等来一个简单全游览器通吃的解决方法,不使用图片,脚本,CSS hacks并在最严格的XHTML 规范中都能通过验证。

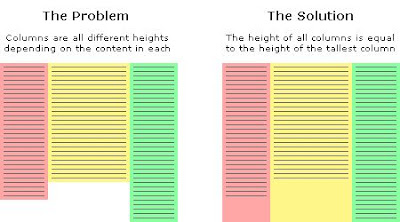
问题的症结所在

可点击放大缩小

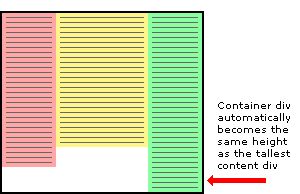
如上图所示,由于各列的内容不一致导致其背景的高度也不统一。而背景实质上是内容(标准的盒子模型是由内容区,补白区,边框区与边界区组成,背景存 在于前三者中;IE为前两者)的自适应的问题。再转化一下,如何撑大那些较短的列的高度,让所有列的高度等于最高的列的高度?这个,的确很很棘手,因为我 们不清楚各列的高度,也无从得知哪一列最高。我们也不能简单地给所有列一个明确的高度,这可能会导致所有列都多出一大片空白,或者很不亏由于高度不足导致 某些列的内容无法全部显示出来!现实中,内容的长度是动态的,因此每列的高度也是动态的。我们必须意识到在网络中,不存在”固定“二字,每个人的显示器的 分辩率都不尽一样,游览器的字体大小设置也不尽相同,这些都会影响到内容的显示高度。

对内容与背景实行分离

解决等高问题的第一步就是把它拆分为两个较小的,可以单独解决的部分。这样,我们原来是一列对应一个DIV,现在是一列对应一个DIV,一个用来装 载内容,一个用来显示背景。这种分离有利于我们对各个元素的掌控和把它们用另一种更有效的方式组合起来,这引起我很快会在下面的章节讲述。

利用浮动嵌套解决最高列的高度的问题。

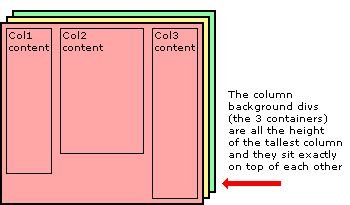
这是解决多列等高的关键。使一个DIV的高度等于最高列的高度的唯一方法就是让这个DIV包含所有的列。换句话说,通过把所有的列放在一个容器中,容器的高度就是最高列的高度。这是个非常有用的结构。

可点击放大缩小

单行三列的布局的结构层代码。

<div id="container1">
<div id="col1">Column 1</div>
<div id="col2">Column 2</div>
<div id="col3">Column 3</div>
</div>

对应的表现层代码。

#container1 {
float:left;
width:100%;
}
#col1 {
float:left;
width:30%;
background:red;
}
#col2 {
float:left;
width:40%;
background:yellow;
}
#col3 {
float:left;
width:30%;
background:green;
}

为了使用这种结构在所有游览器都正常工作,我们必须让外层容器往左或右浮动,并且其子元素包含每一栏内容的DIV也跟着浮动,哪一个方向都无所谓。 浮动会使用它们往上对齐于外围容器的上补白,并且浮动的容器会自动调整自身的高度与宽度以实现对浮动子元素的包含。但是如果容器被定义了高度与宽度,则它 不会随子元素的大小而自动调整自身显示区域来适应子元素的显示。但在IE6与低版本的IE中,子浮动元素能撑开外围元素;幸好IE7与IE8已引正了这个 不符合标准的做法。

增加用来显示背景的容器

下一步是增加额外的容器,让它们彼此嵌套,并让所有外围的容器数(新增的加上原来的那一个)等于列的总数:3。这三个容器用来显示各列的背景。请注意,我们去掉了原来各列的背景,把它们移至这些容器上。

可点击放大缩小

新的结构层代码,让新增的容器套在原来的外围容器上!

<div id="container3">
<div id="container2">
<div id="container1">
<div id="col1">Column 1</div>
<div id="col2">Column 2</div>
<div id="col3">Column 3</div>
</div>
</div>
</div>

新的表现层代码,新增的容器都是浮动元素!

所有元素左浮动,将容器宽度设为100%,使他们占满页面的宽度。背景色从内容 div 移除并加至容器上。注,原文是所有容器的宽都设为100%,其实根本没有这样的必须,因为在浮动嵌套中,外面的容器必须会被撑大能容得下内部子元素的大小!

#container3 {
float:left;
/*width:100%;*/
background:green;
}
#container2 {
float:left;
/*width:100%;*/
background:yellow;
}
#container1 {
float:left;
width:100%;
background:red;
}
#col1 {
float:left;
width:30%;
}
#col2 {
float:left;
width:40%;
}
#col3 {
float:left;
width:30%;
}

用相对定位来移动容器

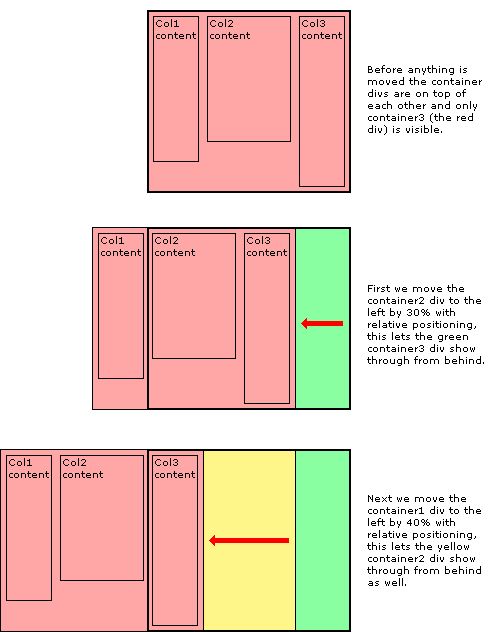
现在是所有容器都完美地累在一起,只显示一种背景颜色,我们必须让其他背景也显示出来。为此我们就得利用相对定位来让这些容器像阶梯一样放置。这个 本可以使用负边界技术,但该死的IE5.5的盒子模型与W3C的不一致,为了兼容我们就得使用到CSS hack。由于本文声明是不使用CSS hack,因此放弃。首先让#container2向右移到30%,由于#container2装着#container1,而#container1上 装着那三个列,这样一来,最右边的列就被移出游览器的右边了。而最外围最底层的容器#container3则露出来了,露了左边的30%。然后我们再移动 最上层的容器#container1,向右边移动40%,于是原来盖住的第二层容器也露出来了,露出其左边的40%,而#container1则只剩下 100%-30%-40%=30%;上方的列也只剩下最右边的列,却表现为位于最左边。这样,背景也显示正常了!

可点击放大缩小

对应的表现层代码

#container3 {
float:left;
/*width:100%;*/
/*没有必要的代码被注释掉!*/
background:green;
}
#container2 {
float:left;
/*width:100%;*/
/*没有必要的代码被注释掉!*/
background:yellow;
position:relative;
right:30%;
}
#container1 {
float:left;
width:100%;
background:red;
position:relative;
right:40%;
}
#col1 {
float:left;
width:30%;
}
#col2 {
float:left;
width:40%;
}
#col3 {
float:left;
width:30%;
}

把各列的内容移回原来的位置上

由于最上层的那三列都是被整体往右往到(页面的)70%,我们再把它们都往左移回70%就是!最后,由于我们前两个背景容器都是被向右移动,移出了游览器,它们都与游览器的右边连在一起,我们可以设置最底层的背景容器的overflow来隐藏那些被移出的部分。

#container3 {
float:left;
/*width:100%;*/
/*没有必要的代码被注释掉!*/
background:green;
overflow:hidden;
position:relative;
}
#container2 {
float:left;
/*width:100%;*/
/*没有必要的代码被注释掉!*/
background:yellow;
position:relative;
right:30%;
}
#container1 {
float:left;
width:100%;
background:red;
position:relative;
right:40%;
}
#col1 {
float:left;
width:30%;
position:relative;
left:70%;
}
#col2 {
float:left;
width:40%;
position:relative;
left:70%;
}
#col3 {
float:left;
width:30%;
position:relative;
left:70%;
}

对列添加补白(内边距)

最后,我们对列增加补白,让每列显得大方一些,而不是密密麻麻地塞满一列。但是如果我们增加补白,可能有一些游览器的有病又犯了,在IE6和更低版本的 IE中,其怪异的盒子模型,会产生一些我们不愿看到的结果。如,一个 200px 宽 20px 补白的 box 在 IE 中被视为 200px 宽,在其他浏览器中则为正确的 240px。补白应该加在元素的宽度上。

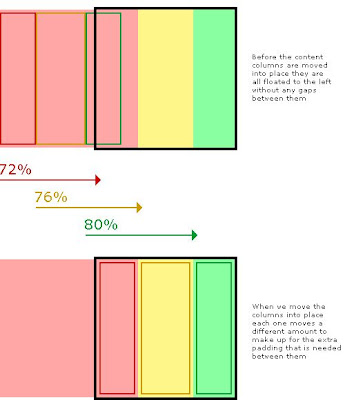
不过放心,我们可以用完全不依赖于 padding 的方法来解决这个问题。相反,我们把列弄窄一点(列宽减去两侧的补白),之后用相对定位把它们移至正确的位置。例如,我们用了 2% 的补白,则 30% 的列将减至 26%,40% 的列减至 36%。用相对定位移回列时需谨记,现在列变窄了,所以当它们一起像最初那样左浮动时,每一个需要比上一个移动更远的距离。

可点击放大缩小

完整的CSS

为了使布局保持在小宽度我在每个内容列增加了overflow:hidden; 这将切去超出列宽的东东,并阻止其干扰其他布局。重申一下,这只是 IE 的问题,其他所有浏览器会保持正确的布局,不管列内是虾米。如果你真想这样做,可以用 IE 条件注释只对 IE 写规则。

#container3 {
float:left;
background:green;
overflow:hidden;
position:relative;
}
#container2 {
float:left;
background:yellow;
position:relative;
right:30%;
}
#container1 {
float:left;
width:100%;
background:red;
position:relative;
right:40%;
}
#col1 {
float:left;
width:26%;
position:relative;
left:72%;
overflow:hidden;
}
#col2 {
float:left;
width:36%;
position:relative;
left:76%;
overflow:hidden;
}
#col3 {
float:left;
width:26%;
position:relative;
left:80%;
overflow:hidden;
}
AppEngine在本周引起很大反响,它提供了一个简单易用的方法 来运行Python写成的Web应用。但是Ruby社区并不需要看Google的脸色,它已经拥有了关于简单部署的解决方案。我们来看两个新的解决方案, 它们均是基于Rails开发者使用的公用基础之上构建的。
Column 1

Heroku 和Morph实验室是Ruby on Rails的托管提供商,提供运行Ruby on Rails应用的整套环境。和传统的托管商相比,他们并不仅仅是提供一个服务器给你,而且提供有趣的工具和接口来帮助你更加容易的工作,使你从繁重的安 装、配置、管理和保证服务器安全中解脱出来。两者皆是使用Amazon的EC2网格计算技术来运行应用,因此你可以毫不担心可伸缩性与性能问题。

Column 2

另一个被Heroku和Morph实验室所推崇的重要特性是无痛部署。部署一个新应用只需要几分钟而已:来看看Heroku的即时部署demo和Morph eXchange的6分钟部署demo,部署是多么简单。

Column 3
两者所带来的是如此的相似。InfoQ采访了这两个项目的相关人员,有更多信息奉上。
James Lindenbaum阐述了Heroku的独有特性:
Heroku无疑是Rails应用最简单的部署平台。只是简单的把代码放进去,然后启动、运行,没人会做不到这些。Heroku会处理一切,从版本控制到 自动伸缩的协作(基于Amazon的EC2之上)。我们提供一整套工具来开发和管理应用,不管是通过Web接口还是新的扩展API。
Heroku的一个非常有趣的特性就是基于浏览器的开发环境。它参考了Gyre的开发经验,Gyre的开发者Adam Wiggins也是Heroku背后的一员。因此如果你希望快速修改和追加的话,只需要通过浏览器编辑正在运行的应用的源代码,并在修改后自动部署。当 然,使用浏览器IDE并不是唯一访问Heroku服务的方法,还可以来看看Heroku的API和外部Git访问。

运行代码

好了,文章就此结果,更多的例子可以参看原作者的网址,或点击以下链接:2 列 , 3 列, 4 列,以及 5 列。

使用Apache做负载均衡

使用Apache做负载均衡

看到这个标题的时候,我和此文作者是一样的心态,apache也能做这个?我一向以为是nginx之类的才行?
仔细一想,如果可行,那应该是用了apache 的 proxy吧?以前用proxy做过asp的代理,如果负载均衡,估计用这个也应该可以吧?
究竟是不是这样呢?看看原文内容就知道了
原文地址为:http://tech.idv2.com/2009/07/22/loadbalancer-with-apache/
内容如下:

第一次看到这个标题时我也很惊讶,Apache居然还能做负载均衡?真是太强大了。 经过一番调查后发现的确可以,而且功能一点都不差。 这都归功于 mod_proxy 这个模块。 不愧是强大的Apache啊。

废话少说,下面就来解释一下负载均衡的设置方法。

一般来说,负载均衡就是将客户端的请求分流给后端的各个真实服务器, 达到负载均衡的目的。还有一种方式是用两台服务器,一台作为主服务器(Master), 另一台作为热备份(Hot Standby),请求全部分给主服务器,在主服务器当机时, 立即切换到备份服务器,以提高系统的整体可靠性。

负载均衡的设置

Apache可以应对上面这两种需求。先来讨论一下如何做负载均衡。 首先需要启用Apache的几个模块:

LoadModule proxy_module modules/mod_proxy.so
LoadModule proxy_balancer_module modules/mod_proxy_balancer.so
LoadModule proxy_http_module modules/mod_proxy_http.so

mod_proxy提供代理服务器功能,mod_proxy_balancer提供负载均衡功能, mod_proxy_http让代理服务器能支持HTTP协议。如果把mod_proxy_http换成 其他协议模块(如mod_proxy_ftp),或许能支持其他协议的负载均衡, 有兴趣的朋友可以自己尝试一下。

然后要添加以下配置:

ProxyRequests Off
<Proxy balancer://mycluster>
BalancerMember http://node-a.myserver.com:8080
BalancerMember http://node-b.myserver.com:8080
</Proxy>
ProxyPass / balancer://mycluster

# 警告:以下这段配置仅用于调试,绝不要添加到生产环境中!!!
<Location /balancer-manager>
SetHandler balancer-manager
Order Deny,Allow
Deny from all
Allow from localhost
</Location>

从上面的 ProxyRequests Off 这条可以看出,实际上负载均衡器就是一个反向代理, 只不过它的代理转发地址不是某台具体的服务器,而是一个 balancer:// 协议:

ProxyPass / balancer://mycluster

协议地址可以随便定义。然后,在<Proxy>段中设置该balancer协议的内容即可。 BalancerMember指令可以添加负载均衡组中的真实服务器地址。

下面那段<Location /balancer-manager>是用来监视负载均衡的工作情况的, 调试时可以加上(生产环境中禁止使用!),然后访问 http://localhost/balancer-manager/ 即可看到 负载均衡的工作状况。

OK,改完之后重启服务器,访问你的Apache所在服务器的地址,即可看到负载均衡的效果了。 打开 balancer-manager 的界面,可以看到请求是平均分配的。

如果不想平均分配怎么办?给 BalancerMember 加上 loadfactor 参数即可,取值范围为1-100。 比如你有三台服务器,负载分配比例为 7:2:1,只需这样设置:

ProxyRequests Off
<Proxy balancer://mycluster>
BalancerMember http://node-a.myserver.com:8080 loadfactor=7
BalancerMember http://node-b.myserver.com:8080 loadfactor=2
BalancerMember http://node-c.myserver.com:8080 loadfactor=1
</Proxy>
ProxyPass / balancer://mycluster

默认情况下,负载均衡会尽量让各个服务器接受的请求次数满足预设的比例。 如果要改变算法,可以使用 lbmethod 属性。如:

ProxyRequests Off
<Proxy balancer://mycluster>
BalancerMember http://node-a.myserver.com:8080 loadfactor=7
BalancerMember http://node-b.myserver.com:8080 loadfactor=2
BalancerMember http://node-c.myserver.com:8080 loadfactor=1
</Proxy>
ProxyPass / balancer://mycluster
ProxySet lbmethod=bytraffic

lbmethod可能的取值有:

lbmethod=byrequests 按照请求次数均衡(默认)
lbmethod=bytraffic 按照流量均衡
lbmethod=bybusyness 按照繁忙程度均衡(总是分配给活跃请求数最少的服务器)

各种算法的原理请参见Apache的文档。

热备份(Hot Standby)

热备份的实现很简单,只需添加 status=+H 属性,就可以把某台服务器指定为备份服务器:

ProxyRequests Off
<Proxy balancer://mycluster>
BalancerMember http://node-a.myserver.com:8080
BalancerMember http://node-b.myserver.com:8080 status=+H
</Proxy>
ProxyPass / balancer://mycluster

从 balancer-manager 界面中可以看到,请求总是流向 node-a ,一旦node-a挂掉, Apache会检测到错误并把请求分流给 node-b。Apache会每隔几分钟检测一下 node-a 的状况, 如果node-a恢复,就继续使用node-a。