易栈网-膘叔

浏览模式: 标准 | 列表 | 图文
很妖的实现:以JSon来实现TextBox可选择可输入

很妖的实现:以JSon来实现TextBox可选择可输入

这个实现方式有点妖。
原文是用asp.net实现的。我也没有改,因为,json数据的获取在PHP中真是太简单了。拿到数据后json_encode一下就全有了。。

想看的就做个参考吧。我还是觉得妖
这里只是把主要的代码贴出来,不再进行过多的说明,重要的地方以注释的方式进行说明。

<div id="pubDiv" style="background-position: #9999FF; font-size:12px; display:none; z-index:0; overflow:auto; position:absolute; border:#EDEDED 0px solid;background:#EDEDED;"></div>
<script type="text/javascript" language="javascript">
// 注意下面的等号右面,不能是“<%=BuildJson() %>”,因为JSon整体不能是字符串,同时最后也不能加分号:“;”
var strJson = <%=BuildJson() %>

function ShowBdzDiv() {
var dept = document.getElementById("<%=ddlDeptEdit.ClientID %>").value;
// 构建要下拉选择的内容
var strHtml = "<table border=0px cellpadding=0 cellspacing=0 width=120px><tr>";
for (var key in strJson[dept]) {
strHtml += "<tr><td onclick=SetBdz()>" + key + "</td></tr>";
}
strHtml += "</table>";
var oBdz = document.getElementById("<%=txtBdz.ClientID %>");
var oDiv = document.getElementById("pubDiv");
oDiv.innerHTML = strHtml;

// 设置显示的位置,并显示
oDiv.style.top = "99px";
oDiv.style.left = "100px";
oDiv.style.display = "block";

}
// 当点击选择一个内容时
function SetBdz() {
var oBdz = document.getElementById("<%=txtBdz.ClientID %>");
// 把选择内容设置到TextBox上,并隐藏下拉选择项
oBdz.value = event.srcElement.innerText;
HiddenDiv();
}
// 隐藏下拉选择项
function HiddenDiv() {
var oDiv = document.getElementById("pubDiv");
oDiv.style.display = "none";
}
</script>
。。。
<!--这里只有一点要注意:设置AutoCompleteType="Disabled"-->
<asp:TextBox ID="txtBdz" AutoCompleteType="Disabled" onfocus="ShowBdzDiv()" runat="server"></asp:TextBox>

这里要说明的是,这里只实现了下拉选择项的点击选择,不能使用键盘操作。

又见架构:小规模低性能低流量网站设计原则

又见架构:小规模低性能低流量网站设计原则

来自dbanotes的文章,不多介绍了。我很多文章来自于dbanotes和sanotes网站

原文地址:http://www.dbanotes.net/arch/small_site_arch.html
原文如下:

到处都是什么大规模啊,高流量啊,高性能之类的网站架构设计,这类文章一是满足人们好奇心,但看过之后也就看过了,实际收益可能并不大;另外一个副作用是容易让人心潮澎湃,没学走先学跑,在很多条件仍不具备的情况下,过度设计、过度扩展(高德纳大爷也说过,"过早优化是万恶之源"),所以,这里反弹琵琶,讨论一下小规模、低性能、低流量的网站该如何搞法。

如果站点起步阶段可能就是一台机器(或是一台虚拟机,比如 JobsDigg.com ),这个时候,去关注什么数据拆分啊,负载均衡啊,都是没影子的事情。很多大站点的经验绝不能照搬,辩证的参考才是硬道理。

拥抱熟知的技术

动手构建站点的时候,不要到处去问别人该用什么,什么熟悉用什么,如果用自己不擅长的技术手段来写网站,等你写完,黄花菜可能都凉了。所以,有现成 的软件组件可用,就不要自己重新发明轮子。人家说 Python 牛,但自己只懂 PHP ,那就 PHP 好了,如果熟悉 .net ?,那也不错。用烂技术不是丢人的事情,把好技术用烂才丢人。

架构层次清晰化

起步的阶段应该清楚的确定下来架构的层次。如果都搅和在一起,业务一旦扩增开来,如果原有的一堆东西拆不开就是非常痛苦的事情。

Web Server <--> (AppServer)<-->Cache(eg. Memcached)<-->DB

层次清晰化的一个体现是(以 LAMP 架构为例):即使只有一台机器,也应该起个 Memcached 的实例,效果的确非常好--一般人儿我不告诉他...不要把什么都压到 DB 上,DB 一旦 I/O 压力走到磁盘上,问题要暴露出来是很快的。没错,DB 本身也会利用自己的 Cache,但 DB 的Cache 和 Memcached 设计出发点毕竟不一样。

数据冗余? 有必要

很多人并不是数据库设计专家,如果应用要自己设计表结构什么的,基本都是临时抱佛脚,但三个范式很多人倒是记得牢,这是大多数小型 Web 站点遇到的一个头疼事儿,一个小小的应用搞了几十个表... 忘掉范式这个玩意儿! 记住,尽可能的冗余数据,你在数据层陷入的时间越多,你在产品上投入的就会越少。用户更关心的是产品的设计。

前端优化很重要

因为流量低,访客可能也不多,这时候值得注意的是页面不要太大,多数流量低的站点吃亏就在于一个页面动辄几兆(我前两天看到一个Startup的首页有4M之大,可谓惊人),用户看个页面半分钟都打不开,你说咋发展? 先把基本的条件满足,再去研究前端优化。

功能增加要谨慎

不是有个 80/20 原则么? 把最重要的精力放在最能给你带来商业价值的地方。有些花里胡哨的功能带来很大的开销,反而收效甚微。记住,小站点,最有价值的是业务模式,而不是你的技术有多牛。技术是为业务服务的,不要炫技。

有些网站不停的添加功能,恰恰是把这些新功能变成了压死自己的稻草。

从开始考虑性能

这一点是可选的,但也重要。设计应用的时候在开始就应考虑 Profile 这件事情。一套应用能否在后期进行有效优化和扩展,很大的程度限制在是否有比较合适的 Profile 机制上。需要补充的是,对性能的考虑必然要把有关的历史数据考虑进来。另请参见网站运维之道的容量规划以及其它小帖子。

好架构不是设计出来的

这是最后要补充的一点。好的架构和最初的设计有关系,但最重要的是发展中的演化:

发展-->发现问题-->反馈-->解决问题(执行力)--> 改进->进化到下一阶段--新问题出现(循环)

有些站点到了某个阶段停足不前,可能卡在执行力这个地方,来自用户的反馈意见上来了之后,没有驱动力去做改进。最后也是死猪不怕开水烫了。

这篇文章有浓重的山寨风格,所以,你不要太认真。如果在用短平快的方式构建某些山寨网站的话,可参考其中对你有益的点,不赞同的地方可以直接忽视掉,就没必要费力留言进行争论了。

--EOF--

FCK常用操作

FCK常用操作

1、获取编辑器中HTML内容
function getEditorHTMLContents(EditorName)
{
var oEditor = FCKeditorAPI.GetInstance(EditorName);
return(oEditor.GetXHTML(true));
}
2、获取编辑器中文字内容(无html代码)
function getEditorTextContents(EditorName)
{
var oEditor = FCKeditorAPI.GetInstance(EditorName);
return(oEditor.EditorDocument.body.innerText);
}
3、设置编辑器中内容
function SetEditorContents(EditorName, ContentStr)
{
var oEditor = FCKeditorAPI.GetInstance(EditorName) ;
oEditor.SetHTML(ContentStr) ;
}
function InsertHTML(html) {
var oEditor = FCKeditorAPI.GetInstance("editor") ;
if (oEditor.EditMode == FCK_EDITMODE_WYSIWYG ) {
oEditor.InsertHtml(html) ;
}else
alert( "FCK必须处于WYSIWYG模式!" ) ;
}
如何判断你的Linux系统是否被黑

如何判断你的Linux系统是否被黑

虽然在用LINUX,但其实对于它的安全,并不是很了解,所以,看到有这样的文章时,还是会记录一下。
原文:http://item.feedsky.com/~feedsky/phpv/~1232318/202448855/1235221/1/item.html
来自:PHP5研究室

俗称“脚本小鬼”的家伙是属于那种很糟糕的黑客,因为基本上他们中的许多和大多数人都是如此的没有技巧。可以这样说,如果你安装了所有正确的补丁,拥有经 过测试的防火墙,并且在多个级别都激活了先进的入侵检测系统,那么只有在一种情况下你才会被黑,那就是,你太懒了以至没去做该做的事情,例如,安装 BIND的最新补丁。

一不留神而被黑确实让人感到为难,更严重的是某些脚本小鬼还会下载一些众所周知的“root kits”或者流行的刺探工具,这些都占用了你的CPU,存储器,数据和带宽。这些坏人是从那里开始着手的呢?这就要从root kit开始说起。

一个root kit其实就是一个软件包,黑客利用它来提供给自己对你的机器具有root级别的访问权限。一旦这个黑客能够以root的身份访问你的机器,一切都完了。 唯一可以做就是用最快的效率备份你的数据,清理硬盘,然后重新安装操作系统。无论如何,一旦你的机器被某人接管了要想恢复并不是一件轻而易举的事情。

你能信任你的ps命令吗?

找出root kit的首个窍门是运行ps命令。有可能对你来说一切都看来很正常。图示是一个ps命令输出的例子。真正的问题是,“真的一切都正常吗?”黑客常用的一个 诡计就是把ps命令替换掉,而这个替换上的ps将不会显示那些正在你的机器上运行的非法程序。为了测试个,应该检查你的ps文件的大小,它通常位于 /bin/ps。在我们的Linux机器里它大概有60kB。我最近遇到一个被root kit替换的ps程序,这个东西只有大约12kB的大小。

另一个明显的骗局是把root的命令历史记录文件链接到/dev/null。这个命令历史记录文件是用来跟踪和记录一个用户在登录上一台Linux机器 后所用过的命令的。黑客们把你的历史纪录文件重定向到/dev/null的目的在于使你不能看到他们曾经输入过的命令。

你可以通过在 shell提示符下敲入history来访问你的历史记录文件。假如你发现自己正在使用history命令,而它并没有出现在之前使用过的命令列表里,你 要看一看你的~/.bash_history 文件。假如这个文件是空的,就执行一个ls -l ~/.bash_history命令。在你执行了上述的命令后你将看到类似以下的输出:

-rw------- 1 jd jd 13829 Oct 10 17:06 /home/jd/.bash_history

又或者,你可能会看到类似以下的输出:

lrwxrwxrwx 1 jd jd 9 Oct 10 19:40 /home/jd/.bash_history -> /dev/null

假如你看到的是第二种,就表明这个 .bash_history 文件已经被重定向到/dev/null。这是一个致命的信息,现在就立即把你的机器从Internet上断掉,尽可能备份你的数据,并且开始重新安装系统。

寻找未知的用户账号

在你打算对你的Linux机器做一次检测的时候,首先检查是否有未知的用户账号无疑是明智的。在下一次你登录到你的Linux机器时,敲入以下的命令:

grep :x:0: /etc/passwd

只有一行,我再强调一遍,在一个标准的Linux安装里,grep命令应该只返回一行,类似以下:

root:x:0:0:root:/root:/bin/bash

假如在敲入之前的grep命令后你的系统返回的结果不止一行,那可能就有问题了。应该只有一个用户的UID为0,而如果grep命令的返回结果超过一行,那就表示不止一个用户。

认真来说,虽然对于发现黑客行为,以上都是一些很好的基本方法。但这些技巧本身并不能构成足够的安全性,而且其深度和广度和在文章头提到的入侵检测系统比起来也差得远。

转贴:偷菜盛行

转贴:偷菜盛行

其实,开心网,我也就上去一段时间就不怎么玩了,主要还是我老婆在玩。
不习惯那种氛围吧?不过自己也会偶尔上去做做投票啥的,里面的停车位、买奴隶、咬人、种田啥的确实没有什么好玩的。

买房?纯粹是YY嘛。现实中买不起房只能去网上自己安慰一下自己?打工?王老吉分店总经理又怎么样?还是在YY。种田吧,还要担心被偷,停车吧还要被贴牌。车也买不起。所以。。。对这类YY型游戏,我是兴趣不大的。

当然做做投票,还是有点乐趣的,SNS嘛。传说中的六格理论(名字可能记错)?每6个人你就会认识一个人。找找朋友也还是有机会的。

下面贴上某位朋友的文章,里面介绍的两篇原文写的不错,挺长。我也全部看完了。作者截出来的这段很有意思。。。

原文:http://shiningray.cn/tou-cai.html

今天读到两篇文章,《这么开心》与和菜头的《韩流来袭》。这两篇应该合起来看。

前一篇文章作者分析了kaixin001的花园组件的设定,这种设定是完全鼓励偷窃而非劳作的——相比之下,开心农场的设定就要更有“道德”一些,开心农场中任何植物不能被完全偷光。

和菜头则通过韩国奇怪的搜索引擎(各家独立的庞大门户,和局限于自己的引擎),说出了这种模式的问题:

中国人有着悠久的传统,每天在书包里带一块砖,用饭盒打一盒单位的水泥回家,经过数月之功,修建一个自己家的小厨房。对于 分享和探索,中国人没有多少兴趣。但是,对于像个搬仓鼠一样把外面的资源弄回自己的小家,却人人都有浓厚的兴趣。开心网上最火热的两款游戏是争车位和偷 菜,可以从一个侧面印证这一点。

对于这种分享上的文化差异,我希望只是设计师的设定问题。

老王:如何修复损坏的MyISAM表

myisam如果经常insert,update,delete会产生很多的碎片,而且因为表类型的关系,其实它如果使用不当,也会有损坏的情况发生,一般情况下,可以使用repair table来进行修复。老王说,尽量使用 myisamchk来进行修复,因为这是命令行下的,所以,我没有用过。命令行下,我用的也是repair table。
所以,我转载了老王的这篇博客,写完后,老王又来了一篇TableCache设置过小造成MyISAM频繁损坏,看来,myisam表之所以容易损坏,和tablecache的设置还是有关的。

修复表的原文如下:
当我们用PHPMyAdmin浏览数据库时,有时候会发现某些MyISAM表的Collation项显示为“in use”,这多半说明此表已经损坏。即便是没有出现“in use”字样,也不能就此说明表是完好无损的,熟悉检查及修复方法是必须的。

通过语句:

检查表使用CHECK TABLE语句,如下:

CHECK TABLE tbl_name [, tbl_name] ... [option] ...
option = {FOR UPGRADE | QUICK | FAST | MEDIUM | EXTENDED | CHANGED}

修复表使用REPAIR TABLE语句,如下:

REPAIR [NO_WRITE_TO_BINLOG | LOCAL] TABLE
tbl_name [, tbl_name] ...
[QUICK] [EXTENDED] [USE_FRM]

通过命令:

检查修复表可以使用myisamchk命令:

myisamchk [options] tbl_name ...

如果没有指定参数,那么myisamchk命令缺省执行的就是检查动作。若是要修复表,可以使用-r或-o参数,应该优先使用-r修复,不行的话再使用-o修复。此外,在修复前应该使用FLUSH TABLES刷新缓存,并关闭数据库服务器或者锁定所有的待修复表,以确保在修复过程中不会有其他写操作。

自动修复:

在my.cnf配置文件中的mysqld部分设定myisam-recover参数,当服务启动时可以自动修复有问题的表(速度快慢视数据多少):

[mysqld]
myisam-recover [= options]

参数有DEFAULT,BACKUP,FORCE,QUICK,可以设定为BACKUP,FORCE,万万不可单独设置成FORCE,否则数据文件丢了都没处哭去。


应该尽量使用myisamchk命令去修复,不行再用repair语句去修复(慢),还不行就参考下面链接。

参考文档:How to Repair Tables
而对于tablecache的设定,老王建议:如果你比较懒惰,也可以用MySQL Performance Tuning Primer Script来判断参数是否合理

仍是架构:关于呼叫中心业务系统构架方面的设想

仍是架构:关于呼叫中心业务系统构架方面的设想

我也来个前言,架构这东西,研究的人越多,我能够做参考的也就越多,哇哈哈哈。不多说,贴copy来的文章,原文见博客园:http://www.cnblogs.com/micronet-lukey/archive/2009/04/14/1435520.html。

当然这个架构和我们传统意义上的WEB架构不太一样,但我想说的是这些问题还是可以作为一定的参考。比如我们在开发的时候,是直接上SVN还是采用传统的目录共享式开发。现在SVN已经成为很多项目开发所必备工具了,但如果我们在部署的时候采用SVN进行分发代码呢?审核关如何过?

程序员->发送到SVN服务器->SVN分发到测试组->测试组分发到正式机

这是一种解决方法,其实也有点象下文的图片。但实际操作中,当然不太会这样操作。不过也差不多是类似的方法。

让我注意的其实是文章的最后一句话。。。

前言:

目前,公司的呼叫中心程序已经在中国的很多城市运行着。由于受到技术和网络环境的限制,这些呼叫中心程序安装实施完毕后,我们都是采取客户先反映问题,然后我们再安排人员时间进行维护。这种被动的维护机制带了很多问题。

目前存在的问题:

一:客户在描述问题的时候,并不能深入到系统的内部,往往只是描述了一个系统报错的现象。由于公司里已经没有当时的运行环境,在公司内很难做到故障重现,也就很难定位到故障的原因。系统维护和bug修补难度很大。

二:呼叫中心的程序日志都是分散存放的。哪台计算机中的程序报错,就到那台电脑中找出错日志。这个过程必须人工干预。有时候,有些报错内容非常致命,但由于公司不能及时获取到这些信息,导致很多问题就像一颗定时炸弹一样无法及时排除。

三:当公司更新了一个版本后,如果不能到现场维护,只能通过远程或者让客户代劳替换新程序。这种更新机制一旦遇到网络中断,或者客户不配合,将给维护工作带来很大障碍。如果由于需求变更较多,需要经常更新版本, 那么面临的问题将很难解决。

解决的措施:

就第一和第二个问题,可以通过改进目前的日志记录方式来解决。通讯服务器接收客户端程序的错误日志。并且把这些日志内容打包成E_Mail邮件,定时发送到公司指定的邮箱中。

就第三个问题,可以通过自动更新服务来解决。维护人员把最新的软件更新包上传到客户端的通讯服务器中。客户端程序监测到有最新的软件更新包,可以自动更新。

5f84572c0872c2608b4e6724b8b32ec6

解决问题的核心就是在客户那安装一台通讯服务器。这台通讯服务器既要能能够连接到Internet,同时还要和内部的服务器向连接。这台通讯服务器有两个作用:

1:发送各个程序的错误日志到公司的邮件。

2:接收公司上传的程序更新包,并自动通知各个客户端程序更新。

所有的工作都由服务器自动完成。

总结:

任 何一个系统,在现场部署完成,用户正式开始使用后,对于我们开发组来说,那只是万里长征走完了第一步,后期不断地查错,改进,更新,替换也会占用到大量的 人力物力,如果是外省的客户,跑一趟现场还会占用大量的财力。按照现在的技术能力和网络环境,我们完全可以通过技术手段,更高效地对各个系统进行维护。

维护的最高境界是:客户还没有发现问题,我们已经捕捉到bug并在后台悄悄地把程序更新了。

keepalived?来自Sanotes的PDF

keepalived?来自Sanotes的PDF

其实关于这方面我并不了解,昨天在“PHP研讨会议群”里,一直有人在问,但,我确实不了解,于是乎,我没有参与

今天一大早翻开google reader,发现Sanotes就给了我一个惊囍,真是说曹操曹操就到啊。头条就是:keepalived权威指南,吓死我了。

我想,我并没有求过签咋的呀。哈哈

本地做了一个备份:c8d7f11c5e7e7e5995c6b351181a3d80

还是架构:再谈 eBay 的扩展性最佳实践

最近,好象谈架构比较多了,所以,我也就跟着copy,paste了一把。。原文来自DBA notes,网址为:http://www.dbanotes.net/arch/best_practices_for_scaling_websites_lessons_from_ebay.html,作者:feng。

内容如下:

很多人都觉得 eBay 在 QCon (北京) 上的技术讲座不错,但对我来说,其实冲击力没那么大了。eBay 一两年前就是这个 PPT 。不过还是比 Amazon 的 Jeff Barr 强了很多,以后要是开个什么会,你把 Jeff Barr 请来还讲那个销售文档,估计自己都不好意思。

不过,eBay 这次的PPT 总算还是有点更新的。

1)数据分片(Partition Everything)

说是分区(Partition),这里不能简单等同于 Oracle 的分区,理解成分片(Sharding)就好啦。可以参考一下我以前写的科普小文:开源数据库 Sharding 技术 (Share Nothing)。这里要强调一下的是,分片是在数据量的确有规模的时候才适合进行,如果单节点足以应付,那么还是不要冒进。

从分片的模式上,eBay 主要根据功能切分(Functional Segmentation)和水平分割(负载均衡考虑),作为推论,所有会话都是无状态性的。

2)异步处理(Asynchrony Everywhere)

其实对于任何网站来说,过度追求"同步"化设计还是比较糟糕的做法。以用户能观察到的数据为视角进行设计,中间可以最大限度用异步来完成。

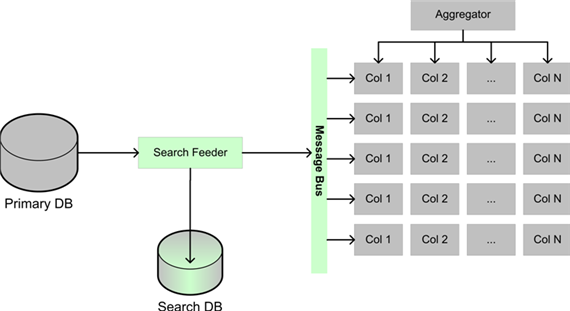
eBay 的举例的模式有两个,一个是事件队列(Event Queue),另一个是信息分发(Message Multicast)。前者基本上是个生产者--消费者的模型。后者主要用在搜索的架构上。

eBay_message_multicast.png

(膘叔:不知道怎么回事,我下载总是只显示一半看来是我的RP不好?)

注意到图中的消息总线,这才是 eBay 整个架构中的动脉,估计轻易不会批露技术细节

3)自动化(Automate Everything)

这里的自动化举了两个例子,一个是针对运维方面的,另外举了关于机器学习的东西,这是演讲者 Randy Shoup 的强项所在。

eBay 的自动化,在一年前的另一篇文章里可以窥测一点东西。只是这篇文章当初没有被更多人重视,参见:eclipse at eBay。可以看到 eBay 能在自动化方面做得这么好(起码敢出来讲)不是一朝一夕之功。

4)故障检测与回溯(Remember Everything Fails)

更好的失败检测机制: 监控每天超过 2TB 的日志,根据日志中的相关事件得出判断或者预警。这个看起来简单,但实现起来还是需要一点技巧和策略的,重要的是,需要不断根据结果的反馈去改进。

完美回滚: 任何服务都通过服务配置中的标记来识别,无痛回滚。(个人感觉这个非常有难度,尤其是升级的时候)

优雅降级(Graceful Degradation):能够相对容易的对应用标记"Marks down(下线)"

5)拥抱不一致性(Embrace Inconsistency)

举了 CAP 原则,程立将其形象描述为帽子戏法,非常准确。说起一致性,自从 Amazon CTO Werner Vogels的 Eventually Consistent 一出,基本上不需要我废话了,这就是事务处理的九阴真经,大家回家慢慢参详好了。

eBay 也有自己的绝对准则: 绝对没有分布式事务(两阶段提交), 通过状态机与操作顺序最小化不一致性,通过异步事件(消息总线?)达到最终一致性。

--EOF--

另外小道消息:Amazon CTO Werner Vogels 可能会参加六月份在杭州举办的侠客行大会。

以前的老帖子:eBay 的Scalability最佳实践


对了,如果想直接看讲了什么内容,请看

InfoQ中文站相关内容:

  1. 可伸缩性最佳实践:来自eBay的经验
  2. eBay的表示层架构与Eclipse
  3. 牺牲一致性来换取分布式架构的可伸缩性
  4. ActionScript类库推动mash-up Web2.0平台
  5. 从业务角度论证如何采用REST风格架构
  6. Engine Yard要接管Ruby 1.8.6的维护?
  7. 可伸缩性原则
  8. 透过digg.com和Reddit了解mashup应用
  9. 使用WCF消费REST服务
  10. eBay技术特别专题


jQuery简单开发

jQuery简单开发

jQuery这种轻量级的框架大家使用的都比较多,1.3后效率据说又上升了不少,因此,开发基于jQuery的插件也就显得那么理所当然了。
一般来说,jQuery有两种插件模式,一种是:$.extends({}) ,另一种是:$.fn.extends({})
个人理解:前一种是属于全局性的调用,后一种是针对某个元件的绑定调用。这当然是简单的理解。但事实上,也基本上就是这么做的。

官方的例子也比较简单:

$.extend({
max: function(a, b) {
return a > b ? a : b;
},
min: function(a, b) {
return a > b ? b : a;
},
avg: function(a, b) {
return a / b;
}
});

看上去是不是容易?然后就可以直接调用了。 $.min(2,3) 返回2
一般情况下,为了在扩展中使用$,却又担心的页面使用了jQuery.noConflict()而取消了$指向jQuery的引用,则需要这样写

( function($){
$.fn.extend({
//....code in here
});
})(jQuery);

这样写不仅能够将$显式指向jQuery,而且将产生的变量封在function的作用范围内,不会污染window全局。
而基于$.fn.extends({})的扩展又如何开发呢?

在这里我引用Roby的译文:http://www.robysky.com/archives/171
英文原文:http://www.learningjquery.com/2007/10/a-plugin-development-pattern

我认为以下插件开发模式是必须应该掌握的:
1.在JQuery命名空间内声明一个特定的命名;
2.接收参数来控制插件的行为;
3.提供公有方法访问插件的配置项值;
4.提供公有方法来访问插件中其他的方法(如果可能的话);
5.保证私有方法是私有的;
6.支持元数据插件;

下面,我将逐一讲述上面的内容,并在同时给出相关的简单插件开发代码。
1.在JQuery命名空间内声明一个特定的命名

这意味着开发的是一个单一命名的插件脚本,如果你的脚本包含多个插件或者有补充性质的插件,比如$.fn.doSomething() 和$.fn.undoSomething(),那你得声明多个命名了。但是总体来说,当开发一个插件时,我们应该努力做到用一个单一的命名来搞定整个插件。

在例子中,我们将声明一个名为“hilight”的插件。

$.fn.hilight = function() {
// Our plugin implementation code goes here.
};

我们可以这样调用:
$(’#myDiv’).hilight();
但是假如我们需要打破这种单一的命名和调用方式呢?有很多理由支持我们这么做:设计上的需要;更加简单和可读的配置;而且那样将更加符合OO的要求。

在没有给命名空间来到麻烦的前提下,将插件的部署打破成为多个函数的形式将是十分繁琐的。我们通过认识并利用JavaScript中 functions是最高层的对象,和其他对象一样,functions可以被赋予属性,前面我们已经将hilight命名声明在了JQuery的原型对象上,那么,其实,其他的我们想扩展的属性或对象都能够在hilight上进行声明。稍后将详细讲述此点。
2.接收参数来控制插件的行为;

来为我们的hilight插件添加指定前景和背景色的功能,我们需要在函数中允许一个object类型的选项设置。如下所展示的那样:

$.fn.hilight = function(options) {
var defaults = {
foreground: 'red',
background: 'yellow'
};
// Extend our default options with those provided.
var opts = $.extend(defaults, options);
// Our plugin implementation code goes here.
};

现在,我们的插件可以这样来调用:

$(’#myDiv’).hilight({
foreground: ‘blue’
});
3.提供公有方法访问插件的配置项值;

上面的代码我们可以做一下改进,使得插件的默认值可以在插件之外被设置。这无疑是十分重要的,因为它使得插件用户可以使用最少的代码来修改插件配置,这其实是我们利用函数对象的开始。

// plugin definition
$.fn.hilight = function(options) {
// Extend our default options with those provided.
// Note that the first arg to extend is an empty object -
// this is to keep from overriding our "defaults" object.
var opts = $.extend({}, $.fn.hilight.defaults, options);
// Our plugin implementation code goes here.
};

// plugin defaults - added as a property on our plugin function
$.fn.hilight.defaults = {
foreground: 'red',
background: 'yellow'
};

4.提供公有方法来访问插件中其他的方法(如果可能的话)

这里要讲的方法和前面的讲解一脉相承,用此方法来扩展你的插件(而且能够让其他人进行扩展)是件很有意思的事情。例如,在扩展hilight插件时,我们可以定义一个format方法用来格式化高亮显示的文本,原来的hilight插件和扩展了format方法的插件代码如下:

$.fn.hilight = function(options) {
// iterate and reformat each matched element
return this.each(function() {
var $this = $(this);
...
var markup = $this.html();
// call our format function
markup = $.fn.hilight.format(markup);
$this.html(markup);
});
};

// define our format function
$.fn.hilight.format = function(txt) {'
return '<strong>' + txt + '</strong>';
};

如前面所述,我们已经很容易的通过设置options对象的属性来允许一个回调函数来覆写默认的格式设置。在这里有另外一个非常棒的方法来个性化你的插件,上面展示的方法实际上就是通过暴露format方法,使其可以被重新定义。这种做法使得其他人可以采用他们自己的习惯和方式来重写你的插件,这意味着他们可以为你的插件写额外的扩展插件。
仔细考量一下前面我们用到的插件例子程序,你可能会想“我们究竟应该在什么时候使用这种插件方式来实现需求”的问题。一个来自现实应用中的插件便是“ Cycle Plugin”,它是一个支持多种滑动显示特效的插件,特效包括滚动、滑动和渐变等等。但是,实际上,并没有办法来定义每一个可能会用在滑动变幻上的特效。这就是这种扩展方式的有用之处。“ Cycle Plugin”插件暴露了”transitions”对象,这使得用户只需要按照如下方式便可以添加自己的变幻定义:
$.fn.cycle.transitions = {
…
};
这种技巧使得用户可以定义或者采用自己习惯的方式来扩展“ Cycle Plugin”。
5.保证私有方法是私有的;

上面提到的暴露插件中的公有方法的技巧使得插件能够被覆写,这将使插件变得十分灵活而强大,但至于哪一部分,那些属性和方法应该被暴露出来,你得小心了。一旦使其能够被外界访问到,你就得注意到任何调用参数和语义化的变动都可能使其丧失向前的兼容性。作为一般准则,如果不确定是否应该暴露某个属性或对象的话,那就最好别那样做。
那么我们应该怎样来定义多个方法而不至于使命名空间混乱并且保证不被暴露再外呢?这就是闭包的工作,为了便于演示,我们给插件加入了一个叫做 “debug”的功能,它用来记录firebug控制台所选择的网页元素数目。为了创建一个闭包,我们将整个功能的定义放入在一个function中了(有关这方面的知识,可参见JQuery手册)。

// create closure
(function($) {
// plugin definition
$.fn.hilight = function(options) {
debug(this);
...
};
// private function for debugging
function debug($obj) {
if (window.console && window.console.log)
window.console.log('hilight selection count: ' + $obj.size());
};
...
// end of closure
})(jQuery);

debug方法在这里是无法被在插件以外访问到的,因此,我们称之为它是插件私有的。
6.支持元数据插件;

根据你所写的插件的类型,为你的插件加入元数据插件的支持将使其变得更强大。就我个人来说,喜欢采用元数据插件的重要原因便是它可以让你使用定义之外的标签来覆写你的插件属性设置(这在创建demo和例子时十分有用),而且支持它十分的简单。
更新:这部分内容可以在本文的评论中展开讨论(既然有争议的话)

// plugin definition
$.fn.hilight = function(options) {
...
// build main options before element iteration
var opts = $.extend({}, $.fn.hilight.defaults, options);
return this.each(function() {
var $this = $(this);
// build element specific options
var o = $.meta ? $.extend({}, opts, $this.data()) : opts;
...

改动部分的代码会做如下的事情:
*测试metadata插件是否可用
*如果可以,将用metadata扩展options对象
这被加入到jQuery.extend,作为其最后一个参数,所以它可以覆写任何其他参数设置。现在我们可以通过下面的方式控制其行为:

<!-- markup -->
<div class="hilight { background: 'red', foreground: 'white' }">Have a nice day!</div>
<div class="hilight { foreground: 'orange' }">Have a nice day!</div>
<div class="hilight { background: 'green' }">Have a nice day!</div>

而在调用方面,我们通过一行简单的代码就可以实现预期的效果:
$(’.hilight’).hilight();

将上面所述内容涉及到的代码放在一起,完整的例子程序代码如下:

//
// create closure
//
(function($) {
//
// plugin definition
//
$.fn.hilight = function(options) {
debug(this);
// build main options before element iteration
var opts = $.extend({}, $.fn.hilight.defaults, options);
// iterate and reformat each matched element
return this.each(function() {
$this = $(this);
// build element specific options
var o = $.meta ? $.extend({}, opts, $this.data()) : opts;
// update element styles
$this.css({
backgroundColor: o.background,
color: o.foreground
});
var markup = $this.html();
// call our format function
markup = $.fn.hilight.format(markup);
$this.html(markup);
});
};
//
// private function for debugging
//
function debug($obj) {
if (window.console && window.console.log)
window.console.log('hilight selection count: ' + $obj.size());
};
//
// define and expose our format function
//
$.fn.hilight.format = function(txt) {
return '<strong>' + txt + '</strong>';
};
//
// plugin defaults
//
$.fn.hilight.defaults = {
foreground: 'red',
background: 'yellow'
};
//
// end of closure
//
})(jQuery);

看完以上的内容,你是不是对jQuery的插件开发加深了一定的了解了呢?
顺便提一下,yhustc在自己的博客上写了一个基于jQuery的软键盘插件,你是不是又可以根据上面的教程来写一个基于$.fn.extends的扩展呢?让yhustc的插件可以绑定在某个元件上?