易栈网-膘叔

浏览模式: 标准 | 列表 | 图文
你可能不知道的MySQL

你可能不知道的MySQL

冰山上的博客,更新速度之快,令我乍叹不已,我以为我算是勤劳的,想不到,他更是属于勤劳中的勤劳分子。。

以下内容又是COPY于他的网站,看来,他关注的部分内容还是比我高档,我仍然沉迷于一些小技巧,而忽略了一些大的东西。

心有多大,舞台有多大,其实这对技术人员来说非常重要,如果你只注重于一小块技术,那么在大的方面,你永远不会有进步。
扯远了。。不过以下一些小技巧我真的大部分都没有用过,所以我才会贴出来,让大家一起学习一下,如果知道的就直接跳过,当我没说。

内容如下:http://xinsync.xju.edu.cn/index.php/archives/4719

前言:

实验的数据表如下定义:

mysql> desc tbl_name;
+-------+--------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------+--------------+------+-----+---------+-------+
| uid | int(11) | NO | | NULL | |
| sid | mediumint(9) | NO | | NULL | |
| times | mediumint(9) | NO | | NULL | |
+-------+--------------+------+-----+---------+-------+
3 rows in set (0.00 sec)

存储引擎是MyISAM,里面有10,000条数据。

一、”\G”的作用

mysql> select * from tbl_name limit 1;
+--------+--------+-------+
| uid | sid | times |
+--------+--------+-------+
| 104460 | 291250 | 29 |
+--------+--------+-------+
1 row in set (0.00 sec)

mysql> select * from tbl_name limit 1\G;
*************************** 1. row ***************************
uid: 104460
sid: 291250
times: 29
1 row in set (0.00 sec)

有时候,操作返回的列数非常多,屏幕不能一行显示完,显示折行,试试”\G”,把列数据逐行显示(”\G”挽救了我,以前看explain语句横向显示不全折行看起来巨费劲,还要把数据和列对应起来)。

二、”Group by”的”隐形杀手”

mysql> explain select uid,sum(times) from tbl_name group by uid\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: ALL
possible_keys: NULL
key: NULL
key_len: NULL
ref: NULL
rows: 10000
Extra: Using temporary; Using filesort
1 row in set (0.00 sec)

mysql> explain select uid,sum(times) from tbl_name group by uid order by null\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: ALL
possible_keys: NULL
key: NULL
key_len: NULL
ref: NULL
rows: 10000
Extra: Using temporary
1 row in set (0.00 sec)

默认情况下,Group by col会对col字段进行排序,这就是为什么第一语句里面有Using filesort的原因,如果你不需要对col字段进行排序,加上order by null吧,要快很多,因为filesort很慢的。

三、大批量数据插入

最高效的大批量插入数据的方法:

load data infile ‘/path/to/file’ into table tbl_name;

如果没有办法先生成文本文件或者不想生成文本文件,可以一次插入多行:

insert into tbl_name values (1,2,3),(4,5,6),(7,8,9)…

注意一条sql语句的最大长度是有限制的。如果还不想这样,可以试试MySQL的prepare,应该都会比硬生生的逐条插入要快许多。

如果数据表有索引,建议先暂时禁用索引:

alter table tbl_name disable keys;

插入完毕之后再激活索引:

alter table tbl_name enable keys;

对MyISAM表尤其有用。避免每插入一条记录系统更新一下索引。

四、最快复制表结构方法

mysql> create table clone_tbl select * from tbl_name limit 0;
Query OK, 0 rows affected (0.08 sec)

只会复制表结构,索引不会复制,如果还要复制数据,把limit 0去掉即可。

五、加引号和不加引号区别

给数据表tbl_name添加索引:

mysql> create index uid on tbl_name(uid);

测试如下查询:

mysql> explain select * from tbl_name where uid = '1081283900'\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: ref
possible_keys: uid
key: uid
key_len: 4
ref: const
rows: 143
Extra:
1 row in set (0.00 sec)

我们在整型字段的值上加索引,是可以用到索引的,网上不少人误传在整型字段上加引号无法使用索引。修改uid字段类型为varchar(12):

mysql> alter table tbl_name change uid uid varchar(12) not null;

测试如下查询:

mysql> explain select * from tbl_name where uid = 1081283900\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: ALL
possible_keys: uid
key: NULL
key_len: NULL
ref: NULL
rows: 10000
Extra: Using where
1 row in set (0.00 sec)

我们在查询值上不加索引,结果索引无法使用,注意安全。

六、前缀索引

有时候我们的表中有varchar(255)这样的字段,而且我们还要对该字段建索引,一般没有必要对整个字段建索引,建立前8~12个字符的索引应该就够了,很少有连续8~12个字符都相等的字段。

为什么?更短的索引意味索引更小、占用CPU时间更少、占用内存更少、占用IO更少和很更好的性能。

七、MySQL索引使用方式

MySQL在一个查询中只能用到一个索引(5.0以后版本引入了index_merge合并索引,对某些特定的查询可以用到多个索引,具体查考[中文] [英文]),所以要根据查询条件建立联合索引,联合索引只有第一位的字段在查询条件中能才能使用到。

如果MySQL认为不用索引比用索引更快的话,那么就不会用索引。

mysql> create index times on tbl_name(times);
Query OK, 10000 rows affected (0.10 sec)
Records: 10000 Duplicates: 0 Warnings: 0

mysql> explain select * from tbl_name where times > 20\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: ALL
possible_keys: times
key: NULL
key_len: NULL
ref: NULL
rows: 10000
Extra: Using where
1 row in set (0.00 sec)

mysql> explain select * from tbl_name where times > 200\G;
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl_name
type: range
possible_keys: times
key: times
key_len: 3
ref: NULL
rows: 1599
Extra: Using where
1 row in set (0.00 sec)

数据表中times字段绝大多数都比20大,所以第一个查询没有用索引,第二个才用到索引.
atime、mtime与ctime

以下内容来自于两个博客的内容合并。
首先是来自于冰山上的博客的关于atime、mtime与ctime的介绍(我估计作者也是COPY来的,因为最后两段明显单词断行了,没有修改):

原文:http://xinsync.xju.edu.cn/index.php/archives/4683

atime 访问时间(access time):访问时间是文件最后一次被读取的时间。因此阅读一个文件会更新它的访问时间,而它的改变时间并没有变化(有关文件状态的信息没有被改变),它的修改时间也同样没有变化(文件内容本身没有被改变);

mtime 修改时间(modification time):文件内容最后被修改的时间。如 echo “Hello” >myfile ,则myfile的mtime被改变,同时ctime和atime也被改变;

ctime 改变时间(change time):文件状态(status)最后被改变的时间。如 chmod a+w myfile ,则myfile的ctime被改变,atime和mtime都不变;

参考:

st_atime
Time when file data was last accessed. Changed by the following functions: creat(), mknod(), pipe(), utime(2), and read(2).

st_mtime
Time when data was last modified. Changed by the fol-lowing functions: creat(), mknod(), pipe(), utime(),and write(2).

st_ctime
Time when file status was last changed. Changed by the following functions: chmod(), chown(), creat(),link(2), mknod(), pipe(), unlink(2), utime(), and write().

然后下面的内容又来自于知道分子的博客:http://hutuworm.blogspot.com/2009/03/blog-post_31.html

Linus 大神最近将一项名为 relatime 的特性设定为内核默认行为。(参阅:Matthew Garrett,Reducing disk use)

UNIX 文件系统中的 ctime、mtime、atime 属性分别记录了文件的创建时戳、修改时戳和访问时戳。每当有进程创建、修改、访问某个文件时,文件系统就会保存相应的时戳。对于一般用户而言,文件系统自 动记录这些时戳所花费的时间根本不值一提,完全可以忽略不计。但对于某些特定用途的生产服务器,比如存储大量小图片文件的服务器(写少读多),若每次读取 一个文件都要修改该文件的 atime——想像中的单纯读取操作,实际上却是一读一写——如果这些服务器访问量还挺大,那么这个过程中的消耗则无疑值得斤斤计较、细细考究了。

以 往我们为了节省不必要的 atime 改写,常常采用的方法,是通过 mount 选项 noatime 挂载文件系统,完全摈弃该属性。但随之而来的问题是,某些依赖于 atime 属性的系统程序无法正常工作。而 relatime 补丁的改进之处在于,仅当 atime 比 ctime 或 mtime 更早,或者早于当前时间 24 小时以上,系统才会去修改 atime,由此就大幅度减少了 atime 改写操作,提升了文件系统性能。该项功能已在 Fedora 和 Ubuntu 去年的新版本中发布。

其 实,可以节省的地方还有很多。上周小算了一笔账,某个页面引用的 js 和 css 文件 Expire 时间为 900 秒,一部分图片的 Expire 时间为 12 小时,另一部分图片的 Expire 时间为 4 天——假设该页面内容不变、访问量不变,那么一年的相关静态文件总下载量为数万 GB;如果把这些静态文件的 Expire 时间统一调整为一个月,那么总下载量可以下降一个数量级,降到几千 GB;如果胆子大一点、步子快一点,统一调整为一年,那么总下载量还可以再降一个数量级,降到几百 GB。阿米豆腐,这样的估算结果真是令人咋舌。

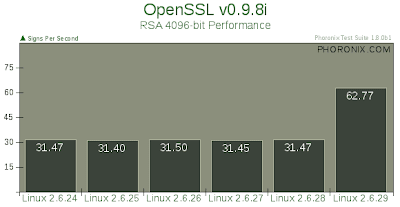
这两天又看了三篇跟性能优化相关的报道。一篇报道是 Linux Magazine 采访 Theodore Ts'o,其中提到 Google 的工程师向 Ext4 文件系统开发者提交了一个取消日志补丁,以获得更高的性能,可以看出,这个功能对于 Google 非常重要。一篇报道是 Red Hat 官方新闻,说 RHEL 5.3 开始支持 Intel 的 QuickPath 内存技术,运行内存密集型的应用可以获得两倍性能提升——显然这得归功于 Nehalem CPU 的崭新架构和超强性能。另一篇报道是 Linux Kernel 2.6.24 到 2.6.29 横向测试,OpenSSL 在 2.6.29 内核上测得性能比前几个版本高出一倍:


无论如何,关注这些信息,稍微算一算,我们就知道随便从其中找一项出来优化,可以提升多少性能、节省多少资源。虽说咱不差钱,但能省干嘛不省呢?

继续使用cyberArticle

继续使用cyberArticle

cyberarticle这款软件一直在用,最近订阅的博客也越来越多,能够想到的就是把一些我认为对我来说是知识点的东西,用它记录下来,以后如果有空可以慢慢翻阅,如果没空,那也可以拿它作为资料库,以后备查。

目前收藏的文章还不多,慢慢来。本来是用Firefox的scrapBook进行收藏的,不料几次收藏都因为格式化机器把存下来的资料都卡嚓了。
伤感啊

8fb3f9507c8a849eeb4273c52428f89a

收藏的东西还是和自己所从事的行业比较相关,以后慢慢收藏一些好文章

张宴:Google 构建大规模信息检索系统中的挑战

张宴:Google 构建大规模信息检索系统中的挑战

原文来自:http://blog.s135.com/post/407/,本来纯粹是转载。
不过,我看到张宴博客里介绍的时候,很是惊讶于google docs的功能,原来,google docs居然也能够象其他那些Webshare网站那样显示PPT或者PDF?点击放大后,还能够下载成PDF或者PPT,而且效果不错,感觉就象FLASH一样。看来什么时候是需要学习一下如何使用了,因为google的速度不错,在与很多人分享资料的时候就比较方便了
不说废话,说原文。。

以下是 Google 检索系统的架构师、Google Mapreduce 的发明者 Jeff Dean 在 WSDM 2009 上的主题演讲:《Challenges in Building Large-Scale Information Retrieval Systems》。在这个主题演讲中,Jeff Dean 讲述了 Google 在10年中,Google 检索系统的演变和发展。

英文原文:http://research.google.com/people/jeff/WSDM09-keynote.pdf
演讲视频:http://videolectures.net/wsdm09_dean_cblirs/

中文译文(由银杏泰克有限公司郝培强翻译):

转:技术骨干做项目经理的优点和缺点

转:技术骨干做项目经理的优点和缺点

看看别人是怎么评价技术骨干做项目经理的,其实任何事都有利弊啦,不过这里说的几乎都是弊。
学工商管理的时候,对于一个职业往往都是讲究内拔外选,其实是和这个道理是一样。
内拔,对于内部的信息、资料都相对比较熟悉,同样,还有对于人员的能力也是相对熟悉,配合起来可能会比较方便,但缺点是眼界可能不会太开阔,比较容易局限于目前的视野
外选,可能技术能力较强,但同样也有缺点,很多人对于空降兵比较排斥,对于人员的能力不熟悉,短时间内不知道如何分配资源。

再看看别人说的吧:http://www.cnblogs.com/laozizhu/archive/2009/04/04/1429640.html

开发骨干,由于主要或全部精力均忙于具体技术工作,各种项目管理任务(如:项目分析/评估、项目计划的制定/检查/调整、上下左右的沟通、专业资源调配、 项目组织调整、项目财务控制、风险分析/对策等)不可避免地疏于顾及,项目管理的事情“没人做”,导致项目控制的问题“积劳成疾”,后悔莫及。

技术骨干担任的项目经理,不可避免地存在着“技术崇拜”,尽可能采用新技术。即使是需求明确的功能,由于实现方式有多种路径,一般都是从技术上采取最优的 路径,而不是从用户操作方便的角度上选择操作最方便、快捷的路径,用户必须严格按开发人员所预设的操作方式进行操作。

说句老实话,用户是不管你用什么技术的,先进或落后的技术都可以,只要能满足用户的需求即可。这种类似闭门造车生产出来的产品,自然就是操作不便,功能差 强人意的。还有一种情况是,这种情况一般发生在项目后期,开发产品的情况较多,随着开发的深入,总会发现缺少某些功能,或者某些功能不够强大。项目经理对 功能的增加、删除、修改,不是通过集体讨论确定或通过从市场前线人员中了解确定,而是通过凭空想象,拍脑袋来作出决定。特别是对于某些功能的添加,由于项 目经理都无法把握用户是否需要这个功能,需要这个功能的程度,因此是很难令开发人员把握此功能的目的。当然,既然大家都无法把握用户是否会用这个功能,那 自然是应付式开发。只要过了测试,过了项目经理这一关就OK拉。

[转]PHP删除cookie的一个小秘密

[转]PHP删除cookie的一个小秘密

首先我们看一下php手册中关于删除cookie的说明

------以下引用php手册内容--------------

bool setcookie ( string name [, string value [, int expire [, string path [, string domain [, bool secure]]]]] )


要删除 cookie 需要确保它的失效期是在过去,才能触发浏览器的删除机制。
下面的例子说明了如何删除刚才设置的 cookie: 例子 2. setcookie() 删除
例子

// 将过期时间设为一小时前

setcookie("TestCookie", "", time() - 3600);
setcookie("TestCookie", "", time() - 3600, "/~rasmus/", ".utoronto.ca", 1);

----------------引用结束--------------------------

删除一个cookie的方法就是把这个cookie的有效期设置为当前时间以前,这
也是几乎所有php程序员都会这么做。

后来一个初接触php的朋友告诉我,他在程序中本想把一个cookie的值设置为
空,结果导致这个cookie直接被删除。我当时的第一反应是不相信,于是测试
了一下

setcookie("testcookie", '');
print_r($_COOKIE);

结果果然是整个$_COOKIE数组都是空的,而非仅仅$_COOKIE['testcookie']为
空.于是用winsock抓包,观察返回的http头,发现http头竟然是

Set-Cookie: testcookie=deleted; expires=Mon, 18-Jun-2007 02:42:33 GMT


这说明setcookie("testcookie", '');的的确确是将testcookie这个cookie直
接删除.而关于这种情况在php手册中完全没有说明.

最后阅读php源码,终于发现真相(这就是开源的好处了,有什么不清楚的内幕
直接查源码)

以下代码可以在php5.20的linux源码包中ext/standard/head.c第99行附近找到.

if (value && value_len == 0) {
/*
* MSIE doesn't delete a cookie when you set it to a null value
* so in order to force cookies to be deleted, even on MSIE, we
* pick an expiry date 1 year and 1 second in the past
*/
time_t t = time(NULL) - 31536001;
dt = php_format_date("D, d-M-Y H:i:s T", sizeof("D, d-M-Y H:i:s T")-1, t, 0 TSRMLS_CC);
sprintf(cookie, "Set-Cookie: %s=deleted; expires=%s", name, dt);
efree(dt);
} else {
sprintf(cookie, "Set-Cookie: %s=%s", name, value ? encoded_value : "");
if (expires > 0) {
strcat(cookie, "; expires=");
dt = php_format_date("D, d-M-Y H:i:s T", sizeof("D, d-M-Y H:i:s T")-1, expires, 0 TSRMLS_CC);
strcat(cookie, dt);
efree(dt);
}
}


源码中清清楚楚的显示,if (value && value_len == 0) ,当value_len为0
时
sprintf(cookie, "Set-Cookie: %s=deleted; expires=%s", name, dt);
会发送删除cookie的http头给浏览器.

最后我们可以得出结论,在php中使用
setcookie($cookiename, '');或者 setcookie($cookiename, NULL);
都会删除cookie,当然这些手册中并没有。

二十件事让身体越来越差

二十件事让身体越来越差

其实本来以前并不关心这些知识啥的,但,身为一名IT工作者,其实我们经常会饮食不规律、作息时间不规律,因此在看到这些从小处就可以进行简单养生的知识时,还是觉得要参考参考的。

原文载自:http://rdc.taobao.com/blog/qa/?p=1401

很多不经意、不正确的行为方式或饮食行为会让你丢失大量的营养素,比如含有合成维生素D的牛奶会夺取人体中的镁;住在充满污烟的都市的人比住在乡下的人获取维生素D的量要少得多,因为空气中的烟把太阳的紫外线都挡住了……

1.多吃纤维,钙质流失!

过多的膳食纤维使食物通过肠道速度增加,使钙的吸收率降低;有研究表明:两个成年人的饮食从每顿纤维含量低的精面包改为每顿纤维含量高的粗面包时,钙(镁、锌和磷)随着出现负平衡。

2. 狂吃肉和蛋,导致铁“滚蛋”!

现在的孩子大都爱吃各种肉类,就是不爱吃蔬菜和水果,家长也认为:只要多吃富含铁锌的肉鱼蛋,蔬菜水果吃不吃无所谓。结果是:不但孩子的体重蹭蹭地往上 “窜”,而且一检查照样患有缺铁性贫血。因为人们膳食中所摄入的瘦肉、动物内脏、蛋黄中的铁多为三价铁,不易被人体吸收,只有在有维生素C和酸味物质(富 含苹果酸、酒石酸、柠檬酸等多种有机酸)存在的情况下,转化成二价铁才能被人体充分地吸收和利用。而维生素C和酸味物质在蔬菜和水果(如猕猴桃、柠檬、鲜 枣、酸枣、橘子、草莓、苹果)中含得最多。如果一味地只吃瘦肉、动物内脏、蛋黄等食物,而不吃或少吃蔬菜和水果,这些食物中的铁质就不能被人体吸收与利 用,造成营养的极大浪费,出现缺铁性贫血。>>>补铁同时还需补维生素C

3. 钙磷失衡“赶走”钙!

钙磷比例失衡是导致目前人们缺钙的元凶。正常情况下,人体内的钙磷比例是2∶1,然而,现实生活中,人们过多地摄入碳酸饮料、可乐、咖啡、汉堡包、比萨 饼、小麦胚芽、动物肝脏、炸薯条等大量含磷的食物,磷的摄入量往往超过了钙10倍以上,使钙∶磷比例高达1:10~20,钙磷的比例严重失衡,这样,饮食 中过多的磷便会拼命地把体内的钙“赶”出体外。

4. 药物导致营养流失!

大多数使用避孕药的女性朋友可能还不知道避孕药有阻碍维生素B6、B12、叶酸及维生素C的作用,避孕药中的黄体素会阻碍维生素B6的功能,妨碍叶酸的吸 收;阿司匹林则会使排出体外的维生素C较正常量增加3倍。大把大把的维生素C补充剂会“赶跑”体内的叶酸。抗癫痫药也会妨碍叶酸吸收。长期服用抗生素者, 会流失维生素B群及维生素K,影响肠胃功能;感冒药及止痛剂会降低血液中维生素A含量;黄胺类药及降胆固醇药会影响叶酸吸收。高血压患者、肾炎患者服用的 利尿剂以及泻药等,都会导致体内的钙质、钾、维生素大量流失;患胃溃疡、失血性贫血的人,服用抗酸剂、碱性药物的病人,会导致微量元素铁的大量流失。

5.抽烟喝酒 营养溜走!

长期抽烟、喝酒破坏了维持良好健康所必需的维生素。抽烟会破坏体内维生素C——这种能预防癌症和心脏病的营养素。每天抽半包烟就会破坏体内25~100毫 克的维生素C;每天喝一杯以上的鸡尾酒,享受飘飘欲仙的代价就是使体内维生素B1、B6和叶酸消耗掉,酗酒者缺乏维生素B1也是相当普遍的。

6 .VitC泡腾,您会用吗?

在公司工作的李小姐,她很讲究营养,每餐后用开水冲一大杯富含维生素C的饮料(如TANG果珍或维生素C泡腾片),可近来不知为什么一刷牙,牙龈总出血, 她很害怕,就跑来咨询,按理说,果珍或维生素C泡腾片是富含维生素C的,为什么还会出现牙龈出血的症状呢?原来,维生素C是一种水溶性维生素,它不很稳 定。用超过80℃以上的水冲服会使维生素C遭到严重破坏,更不用说100℃的开水了。用开水冲富含维生素C的饮料,真正喝到肚子里的维生素C含量已经所剩 无几了。所以,不应用开水,而应用温水冲富含维生素C的饮料。

7.补钙不补镁,吃完就后悔!

人们补钙的时候,只注意补充维生素D,却往往不知道要补充镁。钙与镁似一对双胞胎兄弟,总是要成双成对地出现,而且钙与镁的比例为2:1是最利于钙的吸收 利用的了。所以,在补钙的时候,切记不要忘了补充镁。含镁较多的食物有:坚果(如杏仁、腰果和花生)、黄豆、瓜籽(向日葵籽、南瓜籽)、谷物(特别是黑 麦、小米和大麦)、海产品(金枪鱼、鲑鱼、鲭鱼、小虾、龙虾)。

8.大鱼大肉“吃”掉钙!

高蛋白饮食是引起骨质疏松症的原因所在。有人曾做过这样的实验:A:每天摄入80克的蛋白质,将导致37毫克的钙流失;B:每天摄入240克的蛋白质,额 外另补充1400毫克的钙,将导致137毫克钙的流失。这说明:额外补充钙并不能阻止高蛋白所引起的钙流失。这是因为过多的摄入大鱼大肉这些酸性食物,易 使人们产生酸性体质。而人体无法承受血液中酸碱度激烈的变化,于是,身体就会动用两种主要的碱性物质——钠和钙——加以中和。当体内的钠用光了的时候,就 会启用身体内的钙,所以,过量摄入大鱼大肉而不注意酸碱平衡,将导致钙的大量流失。这也是那些大款、常吃宴席(饮食特点是:肉多酒多油多菜少饭少)的人常 常莫名其妙地感到疲倦、头晕、体力不支的原因所在!紧随其后的是赶上了“代谢综合症”(高血压、高血脂、糖尿病、肥胖、脂肪肝、痛风等等)的时髦病。

9.碳酸饮料,不可多饮!

现在的孩子们吃饭时,都喜欢拿饮料当水喝,什么可乐啦、果汁饮料等,这些碳酸饮料中的碳酸会与体内的钙形成不溶性的碳酸钙,会夺走您所吃进去的食物中的钙质,造成钙流失,引起钙缺乏的症状。

10.鸡蛋吃法多样,吸收不同!

就营养的吸收和消化率来讲,煮蛋为100%,炒蛋为97%,嫩炸为98%,老炸为81.1%,开水、牛奶冲蛋为92.5%,生吃为30%~50%。由此来 说,煮鸡蛋是最佳的吃法,但要注意细嚼慢咽,否则会影响吸收和消化。不过,对儿童和老年人来说,还是蒸蛋羹、蛋花汤最适合,因为这两种做法能使蛋白质分 解,极易被消化吸收。>>>意想不到的鸡蛋壳妙用

11 .化弊为利,提高效率!

如含草酸多的蔬菜(菠菜、苋菜、冬笋、荷兰芹和绿菜花)应在沸水中焯一下再炒,以除去草酸,避免草酸同钙结合成一种不溶性的草酸钙,提高钙的吸收利用率; 存在于大豆、小麦及谷物的外壳中的植酸,易与钙、锌结合成不溶性植酸盐,可采用发芽、发酵、浸泡等方法以激活植酸分解酶活性,使其分解植酸,从而提高钙、 锌在人体内的消化吸收率。另外,因为面粉中含植酸较多,做面食时,尽可能使其发酵。面粉经发酵,植酸分解酶活性增强,可以分解面粉中的植酸,促进面食中 钙、锌的消化吸收。

12 .营养配餐 学问多多!

比如溜肝尖这道菜:主料用肝,辅料有的用黄瓜,有的用柿子椒,相比之下辅料用柿子椒就比用黄瓜要科学的多!因为肝脏中富含微量元素铁和锌,而柿子椒中的维 生素C多于黄瓜,维生素C即可促使肝脏中三价铁转化为二价铁,利于机体更好地吸收铁和锌这两种营养素!再如豆腐炖鱼,鱼肉中含维生素D,豆腐含钙丰富。维 生素D可促进钙的吸收,使豆腐中钙的利用率大大提高。另外,主食讲究谷豆类混食,不仅能使氨基酸互补达到最理想化,还能促进钙的吸收。

13 .睡前应否小餐?

促进成长!有一项研究表明:在睡觉时,人体在不断地排除旧的骨骼组织,这个过程大约在凌晨3点速度最快,所以,睡前加杯酸奶就能及时补充钙源,能确保夜间你的钙指数更稳定。

14 .豆芽并非越长越好!

邻居的张大妈就喜欢买长长的豆芽,她认为这样的豆芽最有营养!其实不然!将大豆发芽后,促进钙、锌、铁吸收的游离氨基酸、总游离氨基酸以及还原型维生素C 明显增加;另外,在大豆发芽过程中植酸酶活性不断升高,不断地水解植酸,致使植酸——这一妨碍钙、锌、铁吸收的主要抑制因子呈现下降趋势,比大豆或豆腐中 植酸含量下降40%,进而大大地提高了发芽大豆中钙、锌、铁的生物利用率,而且以发3~4天(长约4~5厘米)的豆芽营养为最好,并不是人们所想象的芽长 的越长越好、越有营养。>>>长寿不难,从豆芽开始

15 .看似很多,实际很少!

牛奶以其含钙量高且吸收利用率好优点被全世界公认为极佳的天然补钙食物来源。但是喝牛奶是很讲究的!看似吃进去许多牛奶但是真正能吸收的并不多!不少人在 喝完牛奶或吃完乳制品时会出现放屁、胃气胀、腹绞痛和拉肚子等乳糖不耐受的不舒服的现象,最近从国际乳品会议上得知:在亚洲人中有70%不吸收乳糖,中国 人中有75~100%存在乳糖不耐受,如北京为69.4% 、上海为75.8%、哈尔滨为68.9%、广州为70%,为使您能吸收更多的钙质,建议您喝 经过发酵了的酸奶,尤以富含多种乳酸菌的、双歧杆菌的酸奶为佳。

16 .老人饮奶、得不偿失!

牛奶含有5%的乳糖,通过乳酸酶的作用,分解成半乳糖,极易沉积在老年人的晶状体上,导致晶状体透明度降低诱发老年性白内障的发生。老年人可以选用虾皮、 虾米、鱼类、贝类、蛋类、肉骨头、海带及田螺、芹菜、豆制品、芝麻、红枣、黑木耳等含钙高的食物来补钙,以天然食物为最佳。

17 .空腹喝牛奶

有人喜欢清晨空腹喝杯牛奶就当早餐了,殊不知这种做法很不好。食物经过了一晚上的消化吸收,胃肠道里几乎空空的了,如果早晨起来空肚子喝牛奶,就使牛奶还 未等被机体充分的吸收,就顺着空空的胃肠道排了出去,造成营养的极大浪费。所以喝牛奶时最好吃些饼干、面包或花卷、馒头之类的碳水化合物,千万不要空腹喝 牛奶。

18 .牛奶与巧克力同吃 NO!

有人喜欢将巧克力加入牛奶中,以去除牛奶中的怪味。事实上这是不科学的。牛奶含有丰富的钙和蛋白质,而巧克力中含有草酸,牛奶和巧克力一起吃时,牛奶中的 钙易于巧克力中的草酸形成不溶于水沉淀物——草酸钙。人不但无法吸收,时间长了,还会出现头发干枯、腹泻、缺钙和生长发育迟缓等现象。所以,喝牛奶和吃巧 克力的时间要分开。

19 .生吃胡萝卜不吸收!

常见一些老婆婆给孩子吃些生的胡萝卜,她们讲:这样既可磨牙,又可补充“维他命”,这是发生在我们生活中最为典型的营养误区。生吃胡萝卜很不科学。将胡萝 卜分别生食、用微量的油脂烹调、用足量的油脂烹调,测胡萝卜素的消化吸收率分别为10%、30%、90%。可见,胡萝卜素在体内消化吸收率与油脂配比成正 比;胡萝卜用食油烹制后食用比生的食用营养价值高。>>>胡萝卜下酒会中毒

20.“皮”很重要 弃之可惜!

茄子、蓝莓和葡萄的皮中含有大量多酚,这是一种抗氧化剂,具有防止自由基氧化,延缓衰老的作用,去掉皮食用是很可惜的!另外,去掉番茄的皮也会使番茄中的很重要的抗氧化物质——番茄红素容易随汁液流失,不利于维护健康。

向东的工作周报(2月 20 日-4月2日)

向东的工作周报(2月 20 日-4月2日)

从名字可以看出来,这是向东的工作周报。不过,他的这一周,好长啊。。。其实是他每周的工作情况的简报啦。
这个习惯真好,我就没有养成。

他的第一个问题,我在以前与java那边交互的时候就遇到过,开始也是一直判断一直判断。最后发现获取的就是字符串,都跨语言了,还是用的curl来取值的,怎么可能传递布尔值?

最后它说的BOM问题,这就不太应该了。不过他的正则写得不错。我一直用editplus,文件选项里可是有一条:保存时始终去除BOM,就行了啦。用记事本,是会生成BOM的,微软的东西是差呀。。

框架这东西,仁者见仁智者见智,不多分析


原文如下:http://www.xiangdong.org/blog/post/1699/

近半年的工作心得,摘录如下:
( 2月 20 日-- 2月 26 日)
工作心得
一.Ajax通过POST提交给$_POST数组变量问题:
和 js人员一块调试ajax提交一些数据的时候,在ajax调用的时候,js人员通过Post方式传给我一个'allowComment',它为 True\false,刚开始误以为是一个TRUE 或 FALSE是PHP里面的一个布尔值(实际是一个字符串),于是写下如下代码片段:
if(true == $_POST['allowComment'])
{
$this->_par['allow_comment'] = 0;//0为允许评论

}else
{
$this->_par['allow_comment'] = 1;
}
导 致出现无论post过来的数据是true还是false,只走if不走else,当时很奇怪,我通过print_r()来打印看到明明是false,但是 还是不走else这条路,最后听建鑫说它是个字符串,我于是改用var_dump()函数来看:var_dump($_POST)发现它其实就是个 string类型的字符串:string(4) "ture",不是布尔型的一个变量。而修改为:(引号引起来即可)
if(‘true’ == $_POST['allowComment'])
{
$this->_par['allow_comment'] = 0;//0为允许评论

}else
{
$this->_par['allow_comment'] = 1;
}
结论:尽管PHP是弱类型语言,但我们调试时候最好用var_dump(),而不是print_r();
二.DIV模板取高度自动适应的问题:
在 做这次记录套页面的时候,提供的页面是一整张页面,这就需要php工程师去去掉里面的一些没有用的DIV标签和多余的html代码,但是在把最后剩下的一 些HTML代码套好页面后,在放到pengyou里面测试时候,发现页面被遮挡,最后发现是由于刘嵩Js想取到一个DIV的高度没有得到正确的值,而这正 是由于HTML设计人员把一整张页面让PHP开发人员去从里面提取出需要的东西,但是往往会出现某些DIV没有带到Smarty页面里渲染,才导致js在 通过ID或者NAME去取高度时候出错,也就是PHP工程师套页面的时候并不知道UI提供的页面中哪些DIV是JS人员必须要的,而UI人员就把整个页面 给PHP工程师自己去剔掉多余的DIV和HTML,而刚好把JS需要的DIV给干掉了造成的.
结论:切页面得按照产品结构来,而不是仅仅UE,涉及到JS的得事先和PHP工程师和JS人员沟通。
三.接口变动问题:
一 些底层接口的变动往往造成输入(入数据库)和输出(如:页面)出现一些明显的逻辑错误,于是我们首先会想可能是不是程序逻辑出现了问题,进一步去查程序代 码的逻辑是否严密,会发现数据库里面出现一些和现实逻辑不同的情况,而很容易把陈脚搞乱,特别是有其它系统的介入,更让人很难发现其中错误。
结论:尽量少动接口返回的数据结构,保持结口稳定,而一旦改变,及时通知接口使用和开发方。

( 3月 6 日-- 3月 12 日)

工作心得
对重构的一点体会:

1.改进软件的结构:
在开发记录的时候有时由于一个新的需求导致为了更快的满足用户,不故到程序的整体结构,而这种解决方法不能以一个系统的角度来解决问题,如果任其发展会使代码的质量越来越难以维护,而重构能改善这个问题。

2.增加可读性:
以 前的记录的数据层是由外包人员写的,让我觉得有点难懂,而有人说,修改别人的代码不如自己写,但事实上往往自己写的代码比上一个人还难以让别的人读懂,但 是如果这个人有一天离职或者没有上班那就有些耗费时间去读懂对方的代码,而我们的重构可以通过一些命名规范和类的规范和层次结构的规范来尽量防止这类事情 的发生,仅管我也参考了他们的代码。

3.及早地发现错误:
进行重构我们必须对项目的每一行代码的逻辑都了解,明确它的功能和上下程序调用关系,这样的理解我觉得有助于少犯错误和及时发现自己的错误。

4.提高了开发速度:
知道用户80%的需求的情况下,这种情况下重构,可能从一定程度上能提高开发速度。
( 3月 13 日-- 3月 19 日)
遇到一问题
在对记录的项目中进行重构的时候发现需要通过Ajax多提交一个POST变量到PHP那边去,发现不能随意加,而和js开发人员沟通了一下,结果是必须得 修改一下js代码,把多提交的一个加进去才行,但是我个人觉得js的Ajax Post应该做得像表单提交数据那样,只要多加一个数据<input type="text" value="add_value" name="XXX" id="XXX" />加入<form>
</form>表单,就可以对它POST提交到另一个PHP文件,而不是仅仅对一个单独的应用而写一个Ajax Post提交数据 ,不知能否改进成这样?

工作心得
1.
做项目最好先了解需求,然后明确需求,再思考用例,然后画数据流,最后才是数据库的设计,当然最后的数据库设计也是最重要的!
2.
对于一些定义分级和对应级别的少量数据最好放到PHP数组里面,而尽量不要放到数据库里,而对一些不是经常改动而却又是经常频繁查询用到的数据在量不是很在的情况下如放到数据库里面会显得成本太高,放到一个文本里变为一个配置文件来用效率可能会反而更高。
3.
对 大并发和高访问的数据库设计解决方法现目前还是分表,如还不行,再Hash打散分库,但不能无限分,一个库尽量256表,动用4个库来也就分了1000个 表左右,建鑫的经验告诉这样可能性能和稳定性相对高一些,而不能随意乱分。不知按时间或者天数来分表这种情况会有什么样的问题,期待通过人缘项目来尝试一 下。


2009-03-20 ----2009-03-26:
遇到一问题
工作心得
对于上次邮件里面讨论到的PHP BOM问题,我来说来句就当心得吧,其实这个BOM问题一直在我们进行开发的时候经常出现,前些日子在企业邮箱里面第一次遇到这个问题,当时好像是企业的图标LOGO没有办法显示出来,因为<img alt="" src="http://www.xiangdong.org/blog/img.php" />,是img.php去读一个图片的内容然后给img显示,经过长仔细排查出现在输出图片资源前就有输出,那时候用的是notepad+editplus,最后用Zend studio来看这个文件头出现一个锘�字,证明了该问题。

第二次遇到BOM问题,是陈鑫鑫在纸条项目里面输出XML数据到IE浏览器中展现出现XML错误。

第三次也就是我们的记录APP调用外部接口返回用户的昵称出现乱码,经琳琳查也由BOM造成!
为 何经常出现这种类似的问题,我看大家都在按照自己的方式来建立和开发PHP,特别是用Notepad来新建文件,系统默认在是ANSI格式,但我们的 PHP编码是UTF-8的,于是又通过Notepad的另存为修改为UTF-8格式的,这样也就产生了一个BOM,最后,再用现在统一的开发工具Zend for eclipse去编辑这个带BOM的PHP文件,但BOM依然存在文件当中,它一般是表现不出任何问题,但一旦在页面前不能有输出的情况:如上面我遇到的 三种情况它也就显现出来了。

BOM如此讨厌,该如何避免:
建议:
1. 切实统一开发工具:统一用Zend for eclipse 来新建PHP文件,和修改PHP文件编码!
2. 在 项目完成后对目录里面所有的PHP 文件进行遍历驱出有可能出现的BOM。如:用sed批量替换掉bom:(syscore目录和所有下级目录的PHP文件替换) find ./syscore -type f -name "*.php" -exec sed -i '1s/^\xef\xbb\xbf//' {} \;


(3月27日---4月2日)
遇到一问题:
在调试记录的js时发现超过了页数却没有出现翻页导航的页,开始首先以为是数据没有输出程序的问题, 最后查明是由于朋友下面的frame把下面给档住了,Js人员修正了这个问题,这个问题还经常出现,希望js人员也多注意一下!
工作心得:
本周收到老姜发的一点对PHP框架的看法,我也斗胆也说说我自己对这个问题的看法,有些可能说得不太准确或者有些错误,还望包含:
首先,我个人是不反对PHP采用一些轻量级的框架,但极力反对对PHP用一些重型的框架的,为什么呢?因为它的执行方式决定了它的这个特点:php每一 个脚本先全部载入所有资源,执行完毕后全部放弃,所以使用太重的框架,会极耗内存和计算资源,形成调用栈太深占用系统资源,个人觉得轻量框架和简单的分层 还是一定要采用的。
其次,你会说像Java这样的语言它能采用一些的框架,而且还涌现出了一些红红火火的框架了呢:)
个人觉得那是因 为java的执行方式和PHP不一样,对于内存管理也不一样,有很多都是一次装入内存,直到jvm重启才被释放的, 事务性,安全性等等很多基础性的服务,都需要预先装入,何况java是基于工业级应用产生的,php只是个人网站开发才出现的,能一样吗?不能。所以,不 能我们也不要一边倒,看人家采用什么什么了,自己也想把PHP往边上套。
再次,C++和Java强悍的框架不少,但惨不忍睹的框架也更多,为 什么呢?用一个越是尖端的东西越不容易用好,对于重型的编程语言对软件工程功底的要求是相当高的,不是谁说想做个框架就做个框架,更何况各个项目的千差万 别,实际的情况也不尽一样,更不能以一个框架来以逸待劳,放大了框架的作用,它并不是万能的。
最后,我仅对PHP的框架也就领悟到:轻量框架和简单的分层还是PHP在大多数项目开发中还是一定要采用的,但切忌过重,把握好度,适可而止。

从用户体验UE角度设计用户登录系统

很老的一篇文章,可即使是如今看来,也有可取之处。06年的了。现在都09年了
最近,几乎所有的网站都在以改善用户体验为首要目标,所以,更加需要查看这些文章来做参考。

原文:http://www.bloghuman.com/post/196/

内容如下:(图片我也没有下载到本地,直接用的该网站的)

登录界面经常遇到的几个问题:
1、“注册”“找回密码”等这些个非“登录”任务本身的嫡亲应该安排在那里?
我的观点:首先一定要明确“严格来说他们并不属于这个任务”。
放在那里不重要,重要的是我们需要给表现成“相关任务”,不要当作该任务界面的主要元素来处理。(无论在架构还是在交互上都不要让他“喧宾夺主”)
2、“保存cookies”“登录设置”等些个“登录”任务的直系亲属应该如何处理?
我的观点:首先,这些属于任务的一部分。
其次, 如果默认设置能够帮助完成这些信息可以尽量不需要在登录任务里显示,
然后,如果需要 一定要简洁,但简洁的同时要注意文字的表达(如,“自动登录=保存密码+自动登陆”的表达就很不合适)。而且一定要注意默认的备选项设置。
3、表单的排列是横排还是竖排?横排该怎么排,竖排又该怎么排?
我的观点:横排还是竖排要看页面的排版所需,没有什么大的原则问题。具体怎么排只要用心思考一下肯定就知道权衡了,
横排用户的焦点轨迹跨度较大,但空间占用较小;竖排用户的焦点轨迹可以是直线,但空间较大。如果条件允许我建议用竖排,如果规范所限或条件有限我不介意用横排。但大部分情况下我很介意在输入框中默认一些类似"再次输入密码"等傻瓜提示信息的行为。
4、是否需要验证码?
我的观点: 如果安全性没有大问题的话一定不要。
但好像你的技术搭档绝大部分时候都会告诉你“安全性”有大问题,所以很多时候我们不能“为了细节的良好体验而纵容了系统的安全受挫”...
所以这个命题索性可以改成“验证码”应该怎么设计?
我反对一: 中文验证码 (纯弱智的设计)
我反对二: 英文和数字混合的验证码 (给用户输入带来了不少麻烦)
我反对三: 超过4位的验证码 (记忆中好像据说是什么研究结果)
我反对四: 有大写字母的验证码,
特别是大小写混合且实际系统判断时还不区别大小写的 —— 虽然你不区分大小写,但你显示的是大写很多用户就会很费劲的打开大写输入填写大写字母,无形中给用户带来了负担。
5、目前看到的一个我最喜欢的登录任务的设计:
点击在新窗口中浏览此图片
喜欢一: 任务明确,登录任务应该包括“登录信息+登录设置”,“找回密码”不属于登录任务,这些它都交代的很清楚。
喜欢二: 流程清楚,竖排排列用户可以直线思维操作, 用户>密码>保存密码>登录 一气呵成。
喜欢三: 设计精简,类似“保存我的信息”“自动登录”都没有放到这里,这就是我所说的“如果默认设置能够帮助完成,这些信息可以尽量不需要”。因为,大部分情况下如果你真的需要设置 说明你已经不是简单的初级用户,那么你一定有能力自己去找解决方案
喜欢四: 小细节大学问之 —— 错误密码记忆。
看看上图“用户>密码>保存密码>”三个步骤之间都有一个不小的行间距,这个间距空袭乍一看似乎并没有什么作用。
但研究过的人会发现里面的学问不小..
如,
点击在新窗口中浏览此图片
当我第一次输入一个错误的密码时,系统在判断错误后会在提示错误的同时把我的这个输入记忆,当我再次输入这个错误密码时,系统会自动在客户端提示“密码错误”。这样做减少了用户的一次误操作同时也减少了一次提交给服务器端的任务。因为: 密码的输入显示是*并非能直接看到你的确切输入结果,有很多时候你确实是记错了,可以你以为是你自己输入出错了。
喜欢五: 小细节大学问之 —— 验证码
等你输入错误一定次数时才会出现验证码。 (不是一开始就有验证码,也不是你输入错误多了就不让登录)
6、yahoo的登录也很有意思:
点击在新窗口中浏览此图片
优点一: “防密码失窃”功能的设计很有想法,这样的布局基于好的图形设计创新
优点二: 任务足够简单
优点三: 大家好像都具备这些..
缺点一: 任务足够简单,但拖泥带水过多
缺点二: 记忆用户ID的功能很好,但这种显示方式不舒服,给用户的修改增加了步骤
7、细节之 —— 减少用户的填写
我目前为止利用过四次很偶然的机会,观察过五个普通网民用户使用126邮件的过程。
他们在登录时有四个人遇见了同样的问题 —— 输入的时候不知道只要输入 whitecrow_zhu就可以了,而是输入完整的whitecrow_zhu@126.com。
另外一个没有出现这种情况的用户是因为,当他打到"@"符号时,旁边有个人提示他“你SB呀,后面的不用填”,所以他才没有填...

8、总之登录”就是一扇门“

一扇让产品和用户真正互通的门,让产品可以给用户体现出更多价值的门。
所以这个门一定要: 够宽、门槛够低、一直开着、记忆每次进出...

摘:精通php的十大要点

摘:精通php的十大要点

1. 在合适的时候使用PHP - Rasmus Lerdorf
没有谁比PHP的创建者Rasmus Lerdorf明白PHP用在什么地方是更合理的, 他于1995年发布了PHP这门语言,从那时起,PHP就像燎原之火,烧遍了整个开发阵营,改变了互联网的世界。 可是, Rasmus并不是因此而创建PHP的。 PHP是为了解决web开发者的实际问题而诞生的。

和许多开源项目一样,PHP变得流行,流行的动机并不能用正常的哲学来进行解释,甚至流行得有些孤芳自赏。它完全可以作为一个案例,一个解决各种web问题的工具需求所引起的案例,因此当PHP刚出现的时候,这种工具需求全部聚焦到PHP的身上。

但是,你不能奢望PHP可以解决所有问题。Lerdorf是第一个承认PHP只是一种工具的人,并且PHP也有很多力所不能及的情况。

根据工作的不同来选择合适的工具。我跑了很多家公司,为了说服他们部署和使用PHP,但是这并不意味着PHP对所有问题都适用。它只是可以一个解决大部分问题的front-end脚步语言。

作为一个web开发者,尝试用PHP解决所有问题是不科学的,同时也会浪费你的时间。当PHP玩不转的时候,不要犹豫,试用一下其他的语言吧。

2. 使用多表存储提高规模伸缩性 - Matt Mullenweg

没有人愿意质疑Matt Mullenweg在PHP方面的权威性,他开发了这个星球上最流行的blog系统,(依靠一个强大的社区力量支持): Wordpress. 创建Wordpress以后,Matt和他的团队启动了Wordpress.com平台,一个基于Wordpress MU的免费blog站点。现在,Wordpress.com已经拥有大约400万用户, 这些用户每天提供超过 140,000篇的日志。 (要查看更多Wordpress.com的统计情况,请点击这里.)

如果有人知道如何让网站的规模伸缩自如,这个人一定是Matt Mullenweg。2006年的时候 Matt对Wordpress的数据结构进行了前瞻性的改进,并且解释了为什么Wordpress MU对每个blog使用独立的MYSQL表格, 而不是把所有的blog数据都塞进一个巨大的表格。

我们测试过这个方法,但是发现如果要扩展它的伸缩性,代价太高。如果用一个整体的数据结构,在大流量面前,你将会面临服务 器硬件的问题。在MU里面。用户们都被分布到独立的表格当中,并且可以轻易地组织起来。举个例子,WordPress.com把用户的数据分散存储到 4096个数据库中,这些数据库可以分散大规模的数据访问,实现流量和压力分流。

数据表的可迁移性让代码(blog)可以运行得更快,并且让系统具备更强的伸缩性。依靠强大的缓存策略和灵活的数据库运用策略, Matt向人们展示了时下最流行的Facebook和Wordpress.com都可以在PHP下稳定运行,并且处理惊人的访问量。

3. 千万不要相信用户 - Dave Child

Dave Child是 Added Bytes (previously ilovejackdaniels.com) 网站的核心人物,这个网站以他出色的《cheat sheets for many programming languages》而闻名。 Dave为很多英国的公司服务,并且已经在编程世界里树立起相当的权威。

Dave为PHP开发者提供了很多深谋远虑的建议,并总结成了《writing secure code in PHP》:千万不要相信你的用户,他们甚至可能会伤害你。

有一条web开发的基本原则,我重复多少遍都觉得不够,那就是:千万不要相信你的用户,同时要假设你网站中的每个数据单元 都是从用户那里收集来的恶意代码。很多时候,你必须用javascript在客户端检验表单提交过来的内容, 如果你习惯了如此,那么,这是一个好习惯。如果安全性对你来说很重要,这就是最重要最需要学习的原则。

Dave目前正致力于为它的《Writing Secure PHP》系列书籍整理实例,书的最后他说:

最后,变得偏执一点吧。除非你认为你的站点永远不会受到攻击,否则就正视所有的问题,当问题真正发生的时候,你的情况会变得很糟。你需要把每个用户都看成会带来一场攻防站的黑客,想尽一切办法来保护站点的安全,同时想好相应问题的解决方案。

4. 多使用PHP缓存 - Ben Balbo

Ben Balbo开发了Site Point,一个为developers和designers提供指导的网站。他是墨尔本PHP开发和开源俱乐部的成员, 因此他对PHP有一定的了解,同时对PHP caching有一定的想法和经验。

如果你拥有一个访问量很大,但更新并不频繁的站点(比如blog,基于某种CMS),或许它需要进行一些改造,这些改造不会花费太多的时间,但是对性能有突出的贡献。 如果要为一个复杂/更新频率很快的站点建立缓存机制,过程可能会很曲折,但是好处也是显而易见的。

PHP缓存技术有很多种,Ben为我们推荐了如下一些:

缓存函数的运行结果
设置过期时间
缓存IE下载的文件
模板缓存技术
Cache_Lite

由于PHP作为动态语言的特性,缓存机制对于更新频率并不快的站点来说非常重要。

5. 使用IDE, Templates和Snippets加速PHP开发 - Chad Kieffer

当Chad Kieffer从UI设计和数据库优化的工作中抽身出来的时候,他会在他的博客2 tablespoons上分享很多技术经验。由于Chad多方面的全面发展,他经常可以发现其他程序员不能发现的问题,并形成相关经验,尤其是他开发网站的方法。他参与了网站开发的各个环节,因此他的建议对于提高网站开发的大局观非常有用。

Chad认为使用Eclipse PDT
(Eclipse’s PHP development package) 这样的IDE,同时使用一些模板技术和开源项目可以有效地提高PHP的开发速度。

紧凑的计划,长长的to do lists以及deadlines让开发人员非常苦闷。不过有些功能,比如Eclipse Templates,可以有效减少编码的时间和出错的几率。

通常来说,任何项目都可以自动化,自动化程度越高, 你完成项目的时间就越短。花时间来开发使用频率很高的框架和模板,将会节省你以后更多时间。同时,使用像Eclipse and the PDT package这样的IDE,你会发现效率得到明显提高,IDE可以自动闭合,补全分号并且可以在本地debug。

6. 利用好PHP的过滤函数 - Joey Sochacki

或许Joey Sochacki并不像Matt Mullenweg那样有名 ,但他也是一个经验丰富的开发者,并且通过他的博客Devolio分享了很多技术经验

Joey发现在编写php代码的过程中有很多地方需要进行过滤,但却并没有太多的coder关注php的内置过滤函数。

过滤数据是我们经常需要做的事情,但是很多功能丰富的PHP内置过滤函数却不为人知。使用类似filter_* 的PHP内置函数,我们几乎可以处理所有的过滤任务,包括数据类型验证/URL/email和IP地址验证/特殊字符处理等等。

过滤是一件复杂的事情,但是我相信joey的发现会给你很多启发,让你认识到PHP强大的过滤功能。
7. 使用PHP框架 - Josh Sharp

对于是否应该使用Zend, CakePHP, Code Igniter, 或者 其他PHP框架,一直存在着很多争议,但是在web开发者的心中,他们有自己衡量的标准。

Josh Sharp自己创建了一家提供面包和黄油服务的网站,因此他对于使用PHP框架来开发网站有一定的经验。他认为使用一个PHP框架来进行项目开发(use a PHP framework ),可以有效地节省时间,并且减少出错的几率。为什么?因为他觉得PHP实在是太好上手了。

PHP的易于使用有时候也有缺陷,因为并不严格的语法,经常会导致很多错误代码的诞生。但如果使用一个PHP框架,出错的几率就会大大减少。

PHP框架可以让你的代码结构更加规范,并且节省大量时间,你可以阅读《 benefit of using a PHP framework 》来获得更多相关信息。

8. 不要使用PHP框架 - Rasmus Lerdorf

与Josh的观点恰恰相反, PHP的鼻祖Rasmus Lerdorf却认为最好不要使用PHP框架,为什么?因为不基于框架的PHP性能更好。

Rasmus在Drupalcon 2008的演讲上,用“Hello World”的例子来对比了一些框架PHP和简单PHP之间的性能,结果显示框架PHP的性能要远远落后。

9. 使用批处理 - Jack D. Herrington

Jack Herrington对PHP世界并不陌生, 并且为大名鼎鼎的IBM developerWorks贡献过超过30篇的专搞, 同时出版过《PHP Hacks》的书,因此他是一个真正的专家。

Herrington 推荐使用批处理和Cron来代替那些可以运行在后台的程序脚步,web用户并不愿意在线等待你的处理过程,所以有些事情更适合放到后台来处理。

诚然,在某些情况下,这有点大材小用了,但是你可以清楚地看到,使用Cron, MySQL, PHP面向对象的方法以及Pear::DB这些便捷的工具来创建一个批处理工具并不是一件复杂的事情。

Jack认为使用cron, PHP和MySQL在后台处理一些任务,比起多进程的业务逻辑要划算得多。

两种方法我都尝试过,我认为Cron非常符合”Keep It Simple, Stupid” (KISS) 的原则,它让后台处理变得简单。与多进程的业务逻辑相比,它没有内存溢出的风险。你可以创建一个简单的批处理脚本,并且在cron中运行,这个脚本会定时 检查是否有任务需要处理,处理完之后就会自动退出,因此你不用担心是否有进程卡壳,或者陷入死循环。

10. 及时启用错误报告 - David Cummings

David Cummings有一个专门提供CMS软件服务的公司 ,并且获得过几次奖 ,他有非常丰富的PHP开发经验。

David曾经写过《two PHP tips he wished he’d learned in the beginning》,其中一点就是:及时启用错误报告,这会节省大量的时间。

我告诉人们,最重要的事情就是最大程度地开启PHP的错误报告,为什么?因为PHP可能会隐藏很多小问题:

  • 变量没有预定义
  • 在代码片段中引用了不可用的变量
  • 使用了未定义的常量
  • 这些因素看起来并不是什么大事,除非你在使用面向对象的方法编写一些类库。通常,关闭错误报告将可能使你付出更大的成本来维护你的代码。

错误报告可以帮你轻易地找到代码的问题所在,如果错误报告的等级够高,细微的错误都能被立即发现,帮助你节省整体debug的时间。
原文地址:http://nettuts.com/tutorials/php/10-principles-of-the-php-masters/
翻译整理:Andrew