易栈网-膘叔

浏览模式: 标准 | 列表 | 图文
关于PR的好消息

关于PR的好消息

做网站的人关心的是怎么样能够被更多的收录,毕竟收录的越多,被搜索的机会也就越大,被搜索的机会越大,被收录的也就会更多,这是一个良性循环。

对于这一点google的PAGERANK也算是一个门槛,相比较而言,PR值越高的网站,GOOGLE等爬虫就会越关注这个网站,如果上面的资料多,那么被收录的机会就会大大增加。

SEO做的就是这些功能。。

今天pr大更新,欣慰的是neatstudio.com的PR终于升到5了,neatcn.com的PR升到3,然而,52cd.net的PR降为1了,原来是3啊。心痛中。。。

不过,升到5也算是一个好消息了。52cd.net的,我以后会慢慢补回来的。。哼

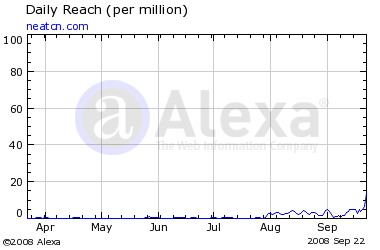
neatcn.com的alexa rank是342050了,一切在向好的方面发展

谨以此文纪念一下这些数值,OHYEAH.

精通MYSQL数据库——连载十

本来觉得二进制字段没有什么好介绍的,本来嘛,二进制字段,不就是xxxtext变成了xxxblob?长度,大小都没有变化,只是存储的类型变成了二进制,如果把那些xxxtext字段的属性加一个binary,那就和xxxblob差不多了。
只是在没有加上binary属性的时候,xxxText字段的排序和比较是按字符串类型处理,而xxxBlob是按二进制处理的。加了BINARY属性自然是一样的。
关于在数据库里存在BLOB信息,历来就是一个有争议的话题。最早的VBB论坛就是把附件存在数据库里的,后来还有人单独做HACK把附件剥出来。很多人认为数据库就应该存储一些文本信息,对于二进制数据(图像、附件等)就只应该存储链接,而把文件单独存储出去。这样可以更加有效的利用数据库的空间。
但支持把附件存储在数据库的人却认为,二进制数据存储在数据库内,有利于数据的迁移、备份,提高了数据的集成程度,而且在程序里也能够使用统一的形式访问数据。把常用的数据和这些二进制数据存储在同一个表内,一般被DBA们所痛恨,因为这会导致所有的数据记录的存取速度变慢,而且BLOB数据在正常操作情况下只能作为一个整体来读出。也就是说如果一个BLOB数据长度是1024KB,如果你仅仅想读最后那24KB的内容,没有直接的办法,只能先读出来,然后再定位到最后,BLOB数据只能以一个整体来读写和传输。
从5.0.3开始,原来的BIT型字段正式变形,成为二进制字段了,它的最大宽度达到了64,为了这个BIT型字段,MYSQL还特地增加了一条用来写出二进制数据的新语法:b'0101',SELECT查询的时候,遇到BIT型,将返回二进制数据。(我没有5.0.3的版本,没有测试过怎么读取,书上介绍,可以先使用 seelct bit_field + 0 命令把二进制转为整数,再使用select bin(bit_field + 0 ) 将这些整数显示为二进制)
对于二进制来说,数据会有溢出现象,它分为上溢出和下溢出,但不管是如何的溢出,只要是溢出了,所有的二进制位都将被设置为1。例如将-1,0,1,7,8五个数字依次存入BIT(3)数据列的时候,实际存放的是b'111',b'000',b'001',b'111',b'111'。
除开这些二进制字段,剩下的就是具有MYSQL特色的字段了,如果没有什么必要,确实不太建议使用,因为其他的数据库都不支持这两种类型,一旦在数据迁移的时候,很有可能会造成丢失或增大工作量,是什么字段呢?他们就是ENUM和SET(枚举和集合)。
对于MYSQL来说,这两种字段对于涉及字符的操作,有很高的效率,表面上存储的可能是文本,但在实际处理的时候,是按设置的下标来进行操作,即按INT类型操作,所以效率极高。
ENUM是一个字符串集合,它的成员最多可以有65535个,ENUM字 取值只能是这个集合中的某一个成员(不允许是不同成员的一个组合 ),相当于数学意义上的“排列”。
而SET虽然采用了类似的思路,但允许数据表中的SET字段的取值是集合成员的任意组合(组合数量不得超过64个),相当于数学意义上的“组合”。在内部,这些字符串分别与2的幂(1,2,4,8等)相对应,所以字符串的组合就相当于二进制位的组合 。因为每个安符串分别对应一个二进制位,所以SET类型的空间战胜比ENUM大。
虽然这两种类型的效率相对较高,但由于和其他数据库的不兼容性,因此多创建一个关联数据表来关联这些数据才是更有实用价值。


介绍完MYSQL所支持的所有字段的属性,也该介绍一些在创建数据列的时候涉及到的属性,注意,有一些属性只能用于特定的数据类型

属性名 含义
NULL 数据列可以NULL值(一般是默认设置)
NOT NULL 不允许包含NULL值(因为bTree索引不支持NULL)
DEFAULT xxx 如果输入时没有指定值,则默认以xxx为值
DEFAULT CURRENT_TIMESTAMP 这个在介绍日期时间类型的时候介绍过,默认插入当前时间
ON UPDATE CURRENT_TIMESTAMP 在数据更新的时候,自动更新为当前时间
PRIMARY KEY 定义为主键
AUTO_INCREMENT 自动输入一个序列编号,只能用于整数类型的数据列,一般与主键对应使用,必须与NOT NULL,或UNIQUE 属性同时使用
UNSIGNED 无符号整数,值得注意的是,无论怎么计算,即使是1-2,返回的也是无符号的整数
CHARACTER SET name 仅适用于字符串列,指定一种字符集和一种可选排序方式


虽然MYSQL有DEFAULT XXX这种属性,但实际上,MYSQL并不允许使用函数来设定默认值,比如DEFAULT rand()就不被允许了。

介绍完这些,以后就该介绍数据库的设计技巧了。之所以在介绍设计技巧之前连载了这么长时间的数据类型,是因为在设计中,使用合适的类型可以适当的增加效率,具体的还是看设计吧。

wubi惊魂

wubi...这个wubi不是传统意义上的五笔哦。
wubi是一个小软件,可以让你在windows下面安装ubuntu而不需要改分区表等信息,说白了就象一个dos启动+liveCD那样的应用,只是内容可以被更改而己。
关于wubi,我就不详细说了。可以到wubu-installer.org上面找个仔细。

我说说我的使用过程吧。
我在笔记本上装的时候,很痛苦,因为,我是intel core duo的芯片,默认就帮我下载了amd64(经朋友指点,amd64不是说为amd64位芯片用的,而是说是64位的版本),结果很多软件装不上,因为那些都是for i386的。确实有点郁闷。可是好象在安装的时候并不能选择。。。(我也没有看到有ini文件配置啥的,这点让人很不舒服,不知道amd64X2的芯片会下载哪个,装了这个版本,qq for linux就不能使用deb包的,而只能使用tar.gz的版本[这个版本,居然不支持打中文???或许是我太笨])
凄凉的事情,咱不多讲。
讲点在单位机器上折腾的事情吧。

单位的机器用的是DELL,显卡是nvidia的,安装完,第一次启动后进行部分设置后会自动重启,然后才算是开启了ubuntu之旅。
建议步骤:
1、进系统后,先更改网络设置,改成能上网先
2、使用新立得软件安装器,先更新所有补丁
3、直接到system菜单找到language support,把环境改成汉语
4、下载好所有的语言包后,再找到 软件的添加删除 ,找到scim,看看有没有选项可以配置,默认的scim在没有装汉语语言时,是没有中文输入法的。
5、由于我的机器是nvidia显卡,初进去时没认出来,需要到hardware test里找到它,打上勾,会自动安装驱动,装完会提示你重启
6、常用的都更新完后,建议安装wine或者通过fushiion安装虚拟机,毕竟大多数情况下,我们还是会用到windows程序。
7、普通的配置没有什么好讲的,firefox还是照常使用,不过好象多了一些插件。伤心的是alipay不支持linux下的firefox,还是慢慢等吧。
8、安装wubi会在启动的时候多一个菜单,所以如果想一启用就进入ubuntu,可以考虑改菜单跳转时间
9、如果觉得ubuntu好用,可以看我博客上的另外一篇文章:把wubi版的改为正式版的

废话不多说了。。开启你们的ubuntu之旅吧

服务器正式启用ImagIck组件

服务器正式启用ImagIck组件

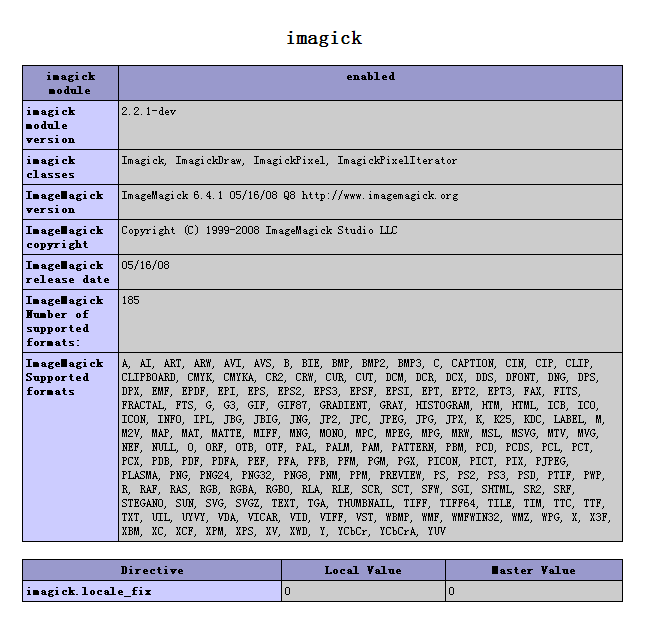
Imagick的DLL在windows上本来无法装上,前面一篇博客里介绍说团队好友hihiyou帮忙找了一个DLL,可以用在PHP 5.2.X上面的,今天一大早COPY到服务器上,并扩展出来。。

看图说话,OH YEAH。可惜。。。sablog不支持Imagick,它还是用GD的,不知道新版本会不会采用。

好象小图看不太清楚。还是点击一下看大图吧。。。

bf5f25320761a63689623a9837d29c0f

精通MYSQL数据库——连载九

字符串,恐怕应该算是MYSQL里面最复杂的类型了吧?几乎目前所有的问题,都是出在与字符有关的数据列上,大致有几种
1、字符串的查询(以下如果不特指,都是指中文),搜索一个中文的时候,不管是模糊还是精确,往往结果都会有与搜索内容不一致的数据在里面
2、编码,现在大家都知道MYSQL连接上后,先执行一下mysql_query('set names GBK',$conn)这类的语句,从MYSQL4.0升级到4.1及以上版本的朋友在这上面吃的苦不少了。网上关于这类的提问也是最多的
3、索引、效率,varchar是MYSQL所特有的字段,而且长度可变,char则是固定长度的字符串。
在MYSQL所支持的几个字符串格式里面,char和varchar是用的最多的,char是定长字段,,也就是说,不管字符串的实际长度有多少,CHAR(10)将永远占用10个字节。字符串如果前端有空格,那么在存储的时候会自动被数据库去掉,相当于先执行trim($string),再进行存储,如果不满10个字节,将会采用空格填满,读取数据时,MYSQL会自动将这些空格去掉。看到这里,恐怕它的缺点之一就明显的暴露了,CHAR不能存储那些结尾确实有空格的字符串(因为读取时会被MYSQL自动去掉)。


数据类型 含义
char(n) 固定长度的字符串,最多255个字符
varchar(n) 可变长度字符串,最多255个字符(MYSQL<5.0.3,n<=255 , mysql>=5.0.3,n<=65535)
tinytext 可变长度字符串,最多255
text 可变长度字符串,最多65535-1
medinumtext 可变长度字符串,最多16,777,216-1
longtext 可变长度字符串,最多4,294,967,296-1

除了char类型外,其余类型均为可变长度,实际所占空间由该字段所存的内容决定。虽然varchar与tinytext一样都是255个字节,但不同的是varchar可以指定存储的长度,而tinytext只能由存储的时候数据长度而定。
在数据表被创建的时候,MYSQL 把数据列的定义改成一种对MYSQL来说更有效率的形式。这种自动方式的修改称为默许的数据列修改(client column changes)。一般来说是对CHAR和VARCHAR数据列都有影响:如果n<4,varchar(n)将被修改为char(n),而如果n>3并且在同一个数据表里还有其他的可变长度的字段,char将被修改成varchar格式。如果数据表里只有固定长度的数据列,char列将不发生变化。也就是说,你在数据表里的字段如果有多种格式,那么你通过alter table 是无法进行修改的。
上表提到,varchar在新版本里变成了65535个字节,但最大字符个数还是要取决于具体的字符集(GBK中文占两个字节,而UTF8中文则占三个字节)。上面这些所有的数据类型都有一个BINARY属性,一旦该字段添加了这个属性,那么MYSQL就会将他们视同BLOB字段来处理。BINARY的好处是在排序时把字符视为二进制,这样就可以把字母的大小写分开,而且由于是二进制字符串,所耗费的时间也会更短。可惜,在实陆应用中我们存储的大多是中文,所以这一点对我们来说并没有太大的区别。中文,本来就没有大小写之分,再怎么二进制,还是那样。呵呵。
在MYSQL4.0及以前的版本里,各种文本字段的字符集和排序方式都由MYSQL服务器决定,默认值是latin1字符集和瑞典排序方式。虽然允许在MYSQL配置文件里指定一种字符集和排序方式,但这会导致所有的数据库受到影响,还有,对字符集和排序方式做了任何修改都必须重启数据库服务器方能生效,更可恨的是,重启后,还必须重新创建所有的索引,同时,MYSQL4.0之前的版本并不支持UNICODE字符集。
4.1后,这些问题得到了很大的改状况,可以单独为某一个数据列指定一种字符集和排序方式,而且字符集和排序方式的选择范围也大了很多,因为从4.1开始支持了UNICODE和UCS-2等。与字符集及相关排序方式相关的命令是:SHOW COLLATION(必须要注意的是,字符集和排序方式不是随意组合的,每种字符集都有该字符集对应的一些排序方式,而不能混用)。如果没有为某个数据列指定一个字符集和排序方式,它将使用数据表、数据库或MYSQL数据库的默认字符集。至于数据库应该使用哪种字符类型,还是由你的项目所决定,如果你的项目采用了GBK编码,那数据库也同样使用这种编码比较好。如果你在项目初始时对于采用哪种编码未知,那么UTF8应该算是比较好的一种解决方法,数据迁移以及对于JAVA、.net等程序的支持也是最好的,唯一的缺点就是占用数据库空间太大。
说到现在,一直在说latin1和unicode字符集,这代表了什么意思呢?
latin1:在最初的MYSQL版本里都是默认采用了这种字符集,它是符合ISO-8859-1的规范的,收录了西欧国家的常用字符,在那个年代,国内还没有多少人使用MYSQL,而真正使用这些的大多是欧美国家,所以这个字符集主要就是用于收集这些国家常用的字符。随后latin的标准 在不停的变化,有latin2,latin9等,但它们当中并没有一个能够把所有欧洲语言里所有的字符都收录齐全,也就是说latin库里并没有一个可以适用于整个欧洲。
UNICODE:正由于latin不能解决这个问题,所以人们开发出了双字节的UNICODE字符集,两个字集意味着是2的16次方,可以存储65535个字符,所以UNICODE字符集不仅涵盖了所有的欧洲语言,还覆盖了绝大多数的亚洲语言。然而UNICODE只定义了每个字符的编码,没有定义如何存储这些编码。
在这个基础上,也同样发展出了好多变体。最重要的是UCS-2和UTF8,UCS-2又称UTF-16,即每种字符都用两个字节表示,所以几乎所有的字符都被涵盖了。但是这种也是有弊端的:存储空间大了一倍,即使是ASCII字符也是这样;字节编码0会出现在字符串中(比如ASCII写出来的文本里,每一个的第2个字节都是0),可是一些程序会把0当成结束标志,而导致出错。
UTF8是UTF16的替代品,在这里所有的ASCII(7位)仍然象以前一样用第一位是0的单字节表示,所有其他的UNICODE字符用2~4个字节表示。它的缺点也同样明显:同一份文档的字节数和字符数没有任何显而易见的关系,但由于它与现有的程序高度兼容,所以UTF8几乎已经成为了一种事实上的标准,而且大多数软件都把它作为自己的默认字符集。
可惜,PHP发展到现在对于UNICODE的支持还是一般性,并没有内置,处理的时候,不是用ICONV就是mb_string库(PHP6是说内置支持了),但并不能妨碍我们使用UTF8来开发网页。

字符串就介绍到这里。太累了。。。。。这个方面的问题太多了,在以后的连载中遇到再详细说明吧。
关于Imagick的使用

关于Imagick的使用

ImagIck这个控件应该算是最近两年来,各个WEB程序员都比较推荐的一个编辑图片的软件。
其实这也是一个分支吧?如果我没有记错,都是从XXX(忘了是哪个了)分出来的,一个是MagickWand,另一个就是这个Imagick了,只是MagicWand好象比较难以控制,并不如这个Imagick方便,再加上Imagick的类及使用方法也集成在PHP手册里了。

本来我是安装了ImageMagick-6.2.5-4-Q16-windows-dll.exe的,然而,愿望总是美好的,结果在Apache下运行的时候,总是提示挂接不上某个动态链接库,装回5.5.7后一切正常,但却无法使用PHP手册里所提供的函数。

本来都想放弃了,可是同事在单位里的Linux上装上了这个软件,但由于我们的PHP版本太低,在大多数的情况下都是直接使用命令行进行操作的。

为了适应将来的PHP版本升级,所以不得不学习这个软件,在我以前的贴子里,也贴过了Imagick官网和一些例子的实现网站。
今后我也会重新拾起代码,尽量、争取把官网的例子也逐步一一实现,或者大部分常用的实现一下。

感谢团队好友hihiyou(http://www.hihiyou.com)为我找了一个可以在windows下使用的Imagick的DLL,可以让我开始学习它。

先来个例子,黑黑。。。

<?php
header('Content-type: image/gif');

$image = new Imagick('google_logo.gif');
$image->adaptiveResizeImage(400,NULL);

echo $image;
?>

原图:

8a492ca623e502fdb5f1f2c670b762bc

重生成:

100c82ece1001fa013ac8de7fe0ae4b4

PHP 中执行排序与 MySQL 中排序

在DBA Notes网站上发现这篇文章,也到InfoQ去看了一下,再加上这个问题确实一直是一个让人头疼的问题,由谁来处理排序更合适。利用MYSQL排序,如果数据很大,一个order by就很有可能会让数据表锁死在那里,可是让PHP来处理,却是让数据被进行二次处理。所以看到本文的时候,就先复制过来,一来自己也可以做点备份,二来也可以给其他人留点资料。


此文首发在 InfoQ 中文站。作者:明灵(dragon) , Fenng . Note:要转载的朋友请注意注明这篇文章的第一作者!
这篇文章是dragon 朋友来邮探讨后他做的一个总结。在 DB 中排序还是在 应用程序中排序是个很有趣的话题,dragon 第一份邮件中其实已经总结的很好了,我添加了一点建议而已。现在放上来,与大家共享。这篇文章也投稿到了 InfoQ 中文站 。

Q:列出在 PHP 中执行排序要优于在 MYSQL 中排序的原因?给一些必须在MYSQL中排序的实例?

A:通常来说,执行效率需要考虑 CPU、内存和硬盘等的负载情况,假定 MYSQL 服务器和 PHP 的服务器都已经按照最适合的方式来配置,那么系统的可伸缩性(Scalability)和用户感知性能(User-perceived Performance)是我们追求的主要目标。在实际运行中,MYSQL 中数据往往以 HASH tables、BTREE 等方式存贮于内存,操作速度很快;同时 INDEX 已经进行了一些预排序;很多应用中,MYSQL 排序是首选。而在应用层(PHP)中排序,也必然在内存中进行,与 MYSQL 相比具有如下优势:

  • 1、 考虑整个网站的可伸缩性和整体性能,在应用层(PHP)中排序明显会降低数据库的负载,从而提升整个网站的扩展能力。而数据库的排序,实际上成本是非常高的,消耗内存、CPU,如果并发的排序很多,DB 很容易到瓶颈。
  • 2、 如果在应用层(PHP)和MYSQL之间还存在数据中间层,合理利用,PHP会有更好的收益。
  • 3、 PHP在内存中的数据结构专门针对具体应用来设计,比数据库更为简洁、高效;
  • 4、 PHP不用考虑数据灾难恢复问题,可以减少这部分的操作损耗;
  • 5、 PHP不存在表的锁定问题;
  • 6、 MYSQL中排序,请求和结果返回还需要通过网络连接来进行,而PHP中排序之后就可以直接返回了,减少了网络IO。

至于执行速度,差异应该不会很大,除非应用设计有问题,造成大量不必要的网络IO。另外,应用层要注意PHP 的 Cache 设置,如果超出会报告内部错误;此时要根据应用做好评估,或者调整Cache。具体选择,将取决于具体的应用。

列出一些 PHP 中执行排序更优的情况:

  • 1、 数据源不在 MYSQL 中,存在硬盘、内存或者来自网络的请求等;
  • 2、 数据存在 MYSQL 中,量不大,而且没有相应的索引,此时把数据取出来用PHP排序更快;
  • 3、 数据源来自于多个 MYSQL 服务器,此时从多个 MYSQL 中取出数据,然后在PHP中排序更快;
  • 4、 除了 MYSQL 之外,存在其他数据源,比如硬盘、内存或者来自网络的请求等,此时不适合把这些数据存入 MYSQL 后再排序;

列出一些必须在 MYSQL 中排序的实例:

  • 1、 MYSQL 中已经存在这个排序的索引;
  • 2、 MYSQL 中数据量较大,而结果集需要其中很小的一个子集;比如 1000000 行数据,取TOP 10;
  • 3、 对于一次排序、多次调用的情况,比如统计聚合的情形,可以提供给不同的服务使用,那么在 MYSQL 中排序是首选的。另外,对于数据深度挖掘,通常做法是在应用层做完排序等复杂操作,把结果存入MYSQL即可,便于多次使用。
  • 4、 不论数据源来自哪里,当数据量大到一定的规模后,由于占用内存/Cache 的关系,不再适合 PHP 中排序了;此时把数据复制、导入或者存在 MYSQL ,并用 INDEX 优化,是优于 PHP 的。不过,用 Java,甚至 C++ 来处理这类操作会更好。 [有些类似大数据集聚合或者汇总的数据,在客户端排序得不偿失。当然,也有用类似搜索引擎的思路来解决类似应用的情况。]

从网站整体考虑,就必须加入人力和成本的考虑。假如网站规模和负载较小,而人力有限(人数和能力都可能有限),此时在应用层(PHP)做排序要做不 少开发和调试工作,耗费时间,得不偿失;不如在 DB 中处理,简单快速。对于大规模的网站,电力、服务器的费用很高,在系统架构上精打细算,可以节约大量的费用,是公司持续发展之必要;此时如果能在应用层(PHP) 进行排序并满足业务需求,尽量在应用层进行。

小家伙最新的一些照片

小家伙最新的一些照片

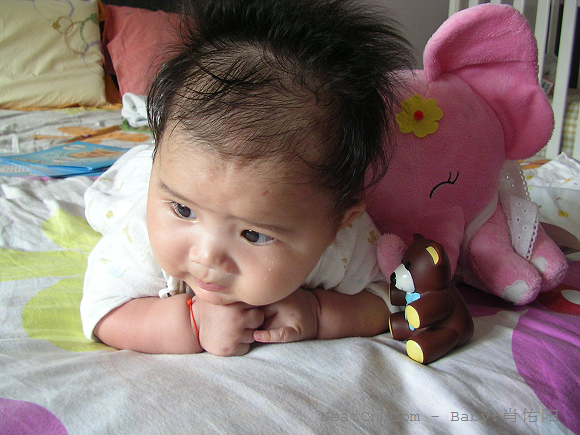
最近为小家伙买了一辆推车,因为我家和我丈人家都在6楼,所以买了个最轻便的。否则以后我老婆一个人可扛不动(我是指我不在家的时候)。

拍了点照片,好象小家伙很兴奋的样子。。

先贴一点老照片:

4b91f7fabde5cb553f4cf048ddff0133

c7533343acbed05db13bc8a24f938736

2406d7508b0745d96f630dd97c4f12df

5342c82cfba59b4e8e7e032cc5b1c5d3

在上传这次刚拍的,呵呵:

6c0916a7db3708597e32a5e5f3719a6b

3898bb6cde72ecb3f7fb9162fc4023fe

5b4799fd9ddc2a2ee736725476e3f241

27d839fc791b22df580311db52bb76e3

6fe0d4681aeb4d33eb9702b5fc618dac

cac2a4c2b30b5cf5f7154c9b0df442fb

d8c9241dfe8da510c6ab2a632c73f6c1

8da7e7fab2bb07c8a5027aa13ec93afe

f199796c05a1643fecbf3d2607451c0c

3865f2b14d4557c77e11e7ab1783fb10

730041755e93243b684ff048199af21f

0221e4bc70ebe714e758971291d0e1f8

c89a4e372a597c5c6183a665fb44df28

98943409822cc6ba23396784642f304e

1ac61602458f03e18cbb8313e9032c0f

9453c1c7ab9a68c1b4390cb0651c5539

42b8c2c7541acde1fec868e4843dc2a2

6d855ab0fb29502756a494b88a08f575

惊心动魄的几小时

惊心动魄的几小时

前两天,我终于使用wubi,在我的笔记本上装上了UBUNTU,然而问题随之而来:
1、部分软件装不上,比如wine
2、QQ无法使用,自带的piddig中的QQ协议是不支持群功能的,下载了qq for linux,结果DEB版本的无法安装,因为只支持i386,这时才发现,我INTEL的CPU,装的居然是for AMD64的UBUNTU(?不理解为什么,这个AMD64是指FOR AMD的芯片吗?),最后只能下载压缩包,解开后里面只有三个文件,运行QQ后,无法使用中文输入法。
3、SCIM输入法,默认没有中文输入,直到我把中文语言包安装好才行。
4、安装和卸载功能、新立得软件安装器,居然是分开的,而且却又互相关联,太郁闷了

虽然有这些缺点,但还是有很大的优点的:
1、硬件全部认出来了,一个驱动也不需要装:无线、SD读卡器,windows分区、蓝牙等等
2、显示器的刷新率终于上了60HZ,看网页再也没有烦恼了
3、很多软件安装还是比较方便的,比如zendstudio for eclipse 6.1等
4、重要操作和vista差不多,需要UNLOCK才能操作(命令行除外,sudo -s就行了)
5、界面友好,漂亮,性能也不错

在使用过程中,发生了一件事情,让我惊心动魄几小时。
我把佑阳的照片从SD卡读出来,放进mount后的windows D盘中,因为担心无法写入,于是,chmod -R 777了一下,然后建立了一个目录,cp 移动硬盘里所有的照片到该目录下。操作完毕,SD卡能够顺利认出确实很方便。自动mount到/media/mobile/目录下,因为我的盘符是mobile。

问题就这样产生了,我切换到windows系统的时候,居然间提示我D盘无法访问,很吃惊的回到了linux下,重新挂载D盘,chmod -R 777,再回去,还是无法访问(但在linux下面可以正常访问)

使用windows进入管理界面,发现该盘符所对应的文件系统不再是NTFS,而是不可识别的RAW,找了一些相关资料,也找了一些分区信息更改软件,发现均无效。(在此之前,回到linux里把D盘内容备份到了移动硬盘里。)
不得己,格式化D盘,把移动硬盘里的东西全部恢复到D盘。
折腾了两天的问题终于解决。

QQ不能输中文确实是遗憾。不过我会尽量到ubuntu下面使用。过两天就该是我安装apache+mysql+php的时候了。

PS:团队好友hihiyou传了个imagick for windows的DLL给我,终于可以在windows下面写imagick的代码了。我也会象我同事那样,逐步把imagick官网例子用imagick实现一下。