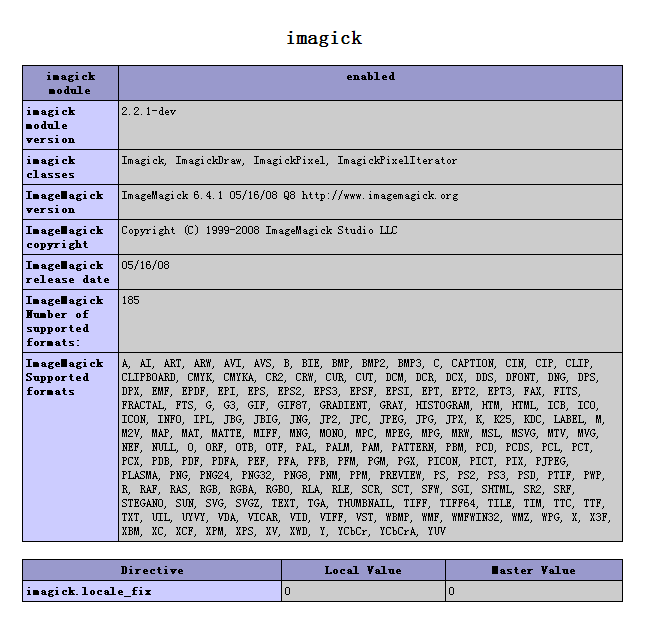
Imagick的DLL在windows上本来无法装上,前面一篇博客里介绍说团队好友hihiyou帮忙找了一个DLL,可以用在PHP 5.2.X上面的,今天一大早COPY到服务器上,并扩展出来。。
看图说话,OH YEAH。可惜。。。sablog不支持Imagick,它还是用GD的,不知道新版本会不会采用。
好象小图看不太清楚。还是点击一下看大图吧。。。
膘叔的简单人生
Imagick的DLL在windows上本来无法装上,前面一篇博客里介绍说团队好友hihiyou帮忙找了一个DLL,可以用在PHP 5.2.X上面的,今天一大早COPY到服务器上,并扩展出来。。
看图说话,OH YEAH。可惜。。。sablog不支持Imagick,它还是用GD的,不知道新版本会不会采用。
好象小图看不太清楚。还是点击一下看大图吧。。。
字符串,恐怕应该算是MYSQL里面最复杂的类型了吧?几乎目前所有的问题,都是出在与字符有关的数据列上,大致有几种
1、字符串的查询(以下如果不特指,都是指中文),搜索一个中文的时候,不管是模糊还是精确,往往结果都会有与搜索内容不一致的数据在里面
2、编码,现在大家都知道MYSQL连接上后,先执行一下mysql_query('set names GBK',$conn)这类的语句,从MYSQL4.0升级到4.1及以上版本的朋友在这上面吃的苦不少了。网上关于这类的提问也是最多的
3、索引、效率,varchar是MYSQL所特有的字段,而且长度可变,char则是固定长度的字符串。
在MYSQL所支持的几个字符串格式里面,char和varchar是用的最多的,char是定长字段,,也就是说,不管字符串的实际长度有多少,CHAR(10)将永远占用10个字节。字符串如果前端有空格,那么在存储的时候会自动被数据库去掉,相当于先执行trim($string),再进行存储,如果不满10个字节,将会采用空格填满,读取数据时,MYSQL会自动将这些空格去掉。看到这里,恐怕它的缺点之一就明显的暴露了,CHAR不能存储那些结尾确实有空格的字符串(因为读取时会被MYSQL自动去掉)。
| 数据类型 | 含义 |
| char(n) | 固定长度的字符串,最多255个字符 |
| varchar(n) | 可变长度字符串,最多255个字符(MYSQL<5.0.3,n<=255 , mysql>=5.0.3,n<=65535) |
| tinytext | 可变长度字符串,最多255 |
| text | 可变长度字符串,最多65535-1 |
| medinumtext | 可变长度字符串,最多16,777,216-1 |
| longtext | 可变长度字符串,最多4,294,967,296-1 |
ImagIck这个控件应该算是最近两年来,各个WEB程序员都比较推荐的一个编辑图片的软件。
其实这也是一个分支吧?如果我没有记错,都是从XXX(忘了是哪个了)分出来的,一个是MagickWand,另一个就是这个Imagick了,只是MagicWand好象比较难以控制,并不如这个Imagick方便,再加上Imagick的类及使用方法也集成在PHP手册里了。
本来我是安装了ImageMagick-6.2.5-4-Q16-windows-dll.exe的,然而,愿望总是美好的,结果在Apache下运行的时候,总是提示挂接不上某个动态链接库,装回5.5.7后一切正常,但却无法使用PHP手册里所提供的函数。
本来都想放弃了,可是同事在单位里的Linux上装上了这个软件,但由于我们的PHP版本太低,在大多数的情况下都是直接使用命令行进行操作的。
为了适应将来的PHP版本升级,所以不得不学习这个软件,在我以前的贴子里,也贴过了Imagick官网和一些例子的实现网站。
今后我也会重新拾起代码,尽量、争取把官网的例子也逐步一一实现,或者大部分常用的实现一下。
感谢团队好友hihiyou(http://www.hihiyou.com)为我找了一个可以在windows下使用的Imagick的DLL,可以让我开始学习它。
先来个例子,黑黑。。。
<?php
header('Content-type: image/gif');

$image = new Imagick('google_logo.gif');
$image->adaptiveResizeImage(400,NULL);

echo $image;
?>
原图:
重生成:
在DBA Notes网站上发现这篇文章,也到InfoQ去看了一下,再加上这个问题确实一直是一个让人头疼的问题,由谁来处理排序更合适。利用MYSQL排序,如果数据很大,一个order by就很有可能会让数据表锁死在那里,可是让PHP来处理,却是让数据被进行二次处理。所以看到本文的时候,就先复制过来,一来自己也可以做点备份,二来也可以给其他人留点资料。
此文首发在 InfoQ 中文站。作者:明灵(dragon) , Fenng . Note:要转载的朋友请注意注明这篇文章的第一作者!
这篇文章是dragon 朋友来邮探讨后他做的一个总结。在 DB 中排序还是在 应用程序中排序是个很有趣的话题,dragon 第一份邮件中其实已经总结的很好了,我添加了一点建议而已。现在放上来,与大家共享。这篇文章也投稿到了 InfoQ 中文站 。
A:通常来说,执行效率需要考虑 CPU、内存和硬盘等的负载情况,假定 MYSQL 服务器和 PHP 的服务器都已经按照最适合的方式来配置,那么系统的可伸缩性(Scalability)和用户感知性能(User-perceived Performance)是我们追求的主要目标。在实际运行中,MYSQL 中数据往往以 HASH tables、BTREE 等方式存贮于内存,操作速度很快;同时 INDEX 已经进行了一些预排序;很多应用中,MYSQL 排序是首选。而在应用层(PHP)中排序,也必然在内存中进行,与 MYSQL 相比具有如下优势:
至于执行速度,差异应该不会很大,除非应用设计有问题,造成大量不必要的网络IO。另外,应用层要注意PHP 的 Cache 设置,如果超出会报告内部错误;此时要根据应用做好评估,或者调整Cache。具体选择,将取决于具体的应用。
从网站整体考虑,就必须加入人力和成本的考虑。假如网站规模和负载较小,而人力有限(人数和能力都可能有限),此时在应用层(PHP)做排序要做不 少开发和调试工作,耗费时间,得不偿失;不如在 DB 中处理,简单快速。对于大规模的网站,电力、服务器的费用很高,在系统架构上精打细算,可以节约大量的费用,是公司持续发展之必要;此时如果能在应用层(PHP) 进行排序并满足业务需求,尽量在应用层进行。
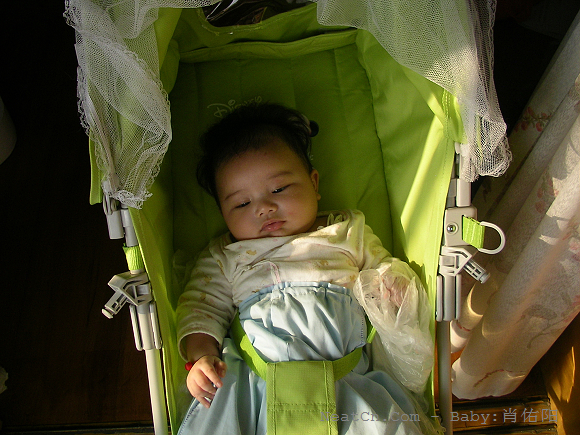
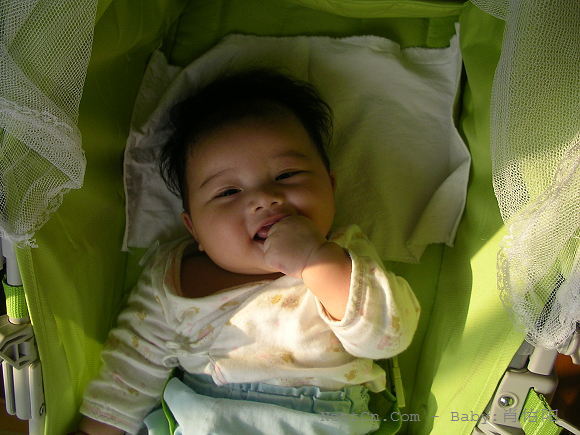
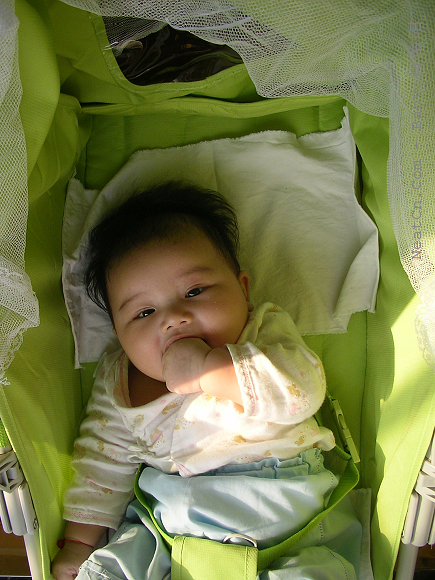
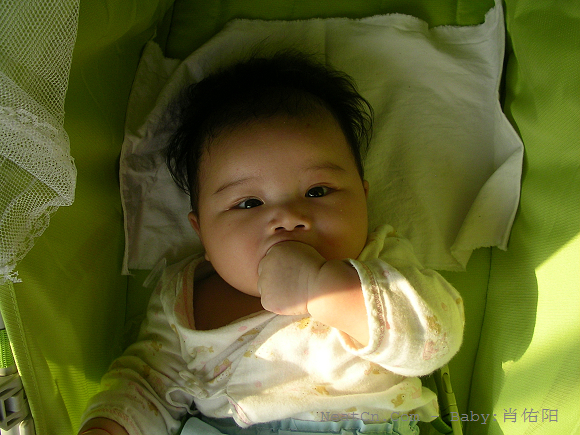
最近为小家伙买了一辆推车,因为我家和我丈人家都在6楼,所以买了个最轻便的。否则以后我老婆一个人可扛不动(我是指我不在家的时候)。
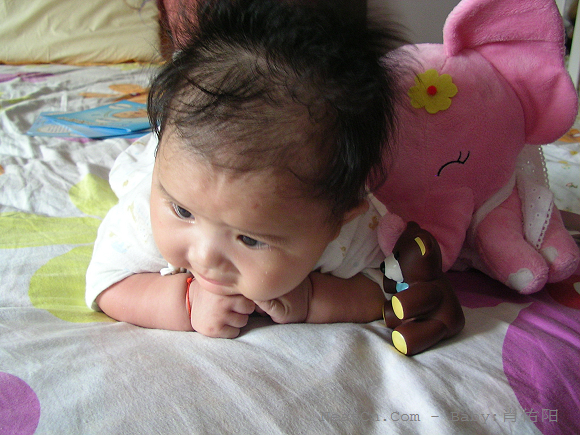
拍了点照片,好象小家伙很兴奋的样子。。
先贴一点老照片:
在上传这次刚拍的,呵呵:
前两天,我终于使用wubi,在我的笔记本上装上了UBUNTU,然而问题随之而来:
1、部分软件装不上,比如wine
2、QQ无法使用,自带的piddig中的QQ协议是不支持群功能的,下载了qq for linux,结果DEB版本的无法安装,因为只支持i386,这时才发现,我INTEL的CPU,装的居然是for AMD64的UBUNTU(?不理解为什么,这个AMD64是指FOR AMD的芯片吗?),最后只能下载压缩包,解开后里面只有三个文件,运行QQ后,无法使用中文输入法。
3、SCIM输入法,默认没有中文输入,直到我把中文语言包安装好才行。
4、安装和卸载功能、新立得软件安装器,居然是分开的,而且却又互相关联,太郁闷了
虽然有这些缺点,但还是有很大的优点的:
1、硬件全部认出来了,一个驱动也不需要装:无线、SD读卡器,windows分区、蓝牙等等
2、显示器的刷新率终于上了60HZ,看网页再也没有烦恼了
3、很多软件安装还是比较方便的,比如zendstudio for eclipse 6.1等
4、重要操作和vista差不多,需要UNLOCK才能操作(命令行除外,sudo -s就行了)
5、界面友好,漂亮,性能也不错
在使用过程中,发生了一件事情,让我惊心动魄几小时。
我把佑阳的照片从SD卡读出来,放进mount后的windows D盘中,因为担心无法写入,于是,chmod -R 777了一下,然后建立了一个目录,cp 移动硬盘里所有的照片到该目录下。操作完毕,SD卡能够顺利认出确实很方便。自动mount到/media/mobile/目录下,因为我的盘符是mobile。
问题就这样产生了,我切换到windows系统的时候,居然间提示我D盘无法访问,很吃惊的回到了linux下,重新挂载D盘,chmod -R 777,再回去,还是无法访问(但在linux下面可以正常访问)
使用windows进入管理界面,发现该盘符所对应的文件系统不再是NTFS,而是不可识别的RAW,找了一些相关资料,也找了一些分区信息更改软件,发现均无效。(在此之前,回到linux里把D盘内容备份到了移动硬盘里。)
不得己,格式化D盘,把移动硬盘里的东西全部恢复到D盘。
折腾了两天的问题终于解决。
QQ不能输中文确实是遗憾。不过我会尽量到ubuntu下面使用。过两天就该是我安装apache+mysql+php的时候了。
PS:团队好友hihiyou传了个imagick for windows的DLL给我,终于可以在windows下面写imagick的代码了。我也会象我同事那样,逐步把imagick官网例子用imagick实现一下。
http://news.sina.com.cn/c/2008-09-19/074516317802.shtml
http://news.sina.com.cn/c/2008-09-17/131714460852s.shtml
不多说,看这两个页面源码,再联系XX门事件。
忘了提了,是懂SEO的人看。普通人看了也白看。不截图,不留把柄
Sorry.
Now i am using ubuntu,and i couldn't configure scim,so i can't input Chinese.
The contents of <Be good at using Mysql> maybe late.
English is very poor,please dont laugh at me.thanks
1931年9月18日,日本帝国主义对我国沈阳北大营的中国驻军发动武装进攻,接着对我国东北地区进行大规模武装侵略。这就是震惊中外的“九一八”事变。 1931年9月18日晚,驻扎在我国东北的日本关东军按照精心策划的阴谋,由铁道“守备队”炸毁了沈阳柳条湖附近的南满铁路路轨,并嫁祸于中国军队。这就是所谓的“柳条湖事件”。日军以此为借口,突然向驻守在沈阳北大营的中国军队发动进攻。当时,蒋介石正集中力量进行反共反人民的内战,执行“攘外必先安内”的反动政策,对日本侵略 者妥协退让。东北军执行蒋介石“不抵抗主义”的命令,未进行有组织的抵抗。当晚,日军攻占北大营,19日占领了整个沈阳城。接着,日军向辽宁、吉林和黑龙 江的广大地区进攻,东北军基本上不战自溃。1932年1月3日,日军占领锦州;2月5日,占领了北满最大城市哈尔滨。至此东北三省全部沦陷。1932年3 月,在日本帝国主义卵翼下,在长春建立起傀儡政权——伪满洲国。从此,日本帝国主义把东北变成它的殖民地,全面加强政治压迫、经济掠夺、文化奴役,使我国 东北3000多万同胞,惨遭涂炭,陷于水深火热之中。 刚刚在新浪新闻中看到:
今年是“九·一八”事变72周年,同时也是沈阳市定于9月18日晚上鸣响防空警报的第八个年头。据介绍,起初沈阳市鸣警报的时间定在9月18日晚10时20分,后考虑到市民的生活习惯等原因,于3年前将鸣响警报时间提前到晚上9时18分。 明晚9时18分,在市区道路上行驶的机动车辆要在行驶中鸣笛,当地广播电台和电视台中断正常节目,插播“勿忘国耻,振兴中华”画面和警报声音。警报解除后,节目恢复正常播出。
日期与时间型理论上应该是用的最多的,不管是什么时候,都需要使用时间,用户登录,文章编辑,甚至LOG,哪个不需要时间?然而在真正的应用中,却没有多少人在使用日期与时间型字段,大多数人都是使用int的时间戳来替代了日期型字段。那么,究竟应该怎样正确使用呢?日期型字段的优劣是什么?今天稍微介绍一下。
在MYSQL数据库中,关于日期和时间型字段有四种,date,time,datetime,year,还有一种比较特殊的timestamp字段。下面将一一介绍。
| 类型 | 含义 |
| DATE | Y-m-d的时间格式,取值范围1000-01-01~9999-12-31,占用3个字节 |
| TIME | H:i:s的时间格式,取值范围-838:59:59~+838:59:59,占用3个字节(说实话,我没有理解这个取值范围) |
| DATETIME | Y-m-d H:i:s的时间格式,是DATE+TIME的组合 |
| YEAR | 年份,取组范围1901~2155和0000,占用一个字节,YEAR有2位和4位之分,4位的就是前面的取值范围,2位的取值范围为70~69,代表了1970~2069 |
| TIMESTAMP | 虽然这个TIMESTAMP并非传统意义上的时间戳,但它的取值范围还是符合时间戳的标准,即从1970~2037,基本格式为:Y-m-d H:i:s,在以前的版本里,日期与时间之间并没有空格,如果为了兼容老的数据,在查询的时候则需要使用:select ts+0 from table来获取正确的时间 |
MYSQL在早期版本里对于时间类型的缺乏严格的判断,而只是仅仅判断数值是否在一个区间,却并不判断它是否合法:月份值允许0~12,日期值允许1~31,所有的数据验证都是由客户端判断好而数据库这边仅仅是一个存储作用。但这在5.0.2版本的时候,一切有了很大的改观,MYSQL开始对日期与时间型数据的判断非常严格,只有它认为合法的数据才存储到数据库,当然它认为0000-00-00仍然是合法数据。
不过,这仍然需要对MYSQL的系统变量sql_mode进行设置,大致有以下三个设置值:
1、ALLOW_INVALID_DATES 即不对数据有效性进行判断,仍然允许存入有明显错误的时间,比如:2001-02-31
2、NO_ZERO_DATE 在这种模式下,0000-00-00不再认为是合法日期
3、NO_ZERO_IN_DATE 不允许使用0作为月份值或者日期值
对于DATE,TIME,DATETIME,YEAR这四种格式,大家都可以从名字上能够看出来格式或者规范是什么样的,真正特殊的是TIMESTAMP格式。
对于TIMESTAMP格式,我想,用PHP开发的人应该是非常熟悉,时间戳嘛。在PHP里面直接使用time()函数,返回的就是当前时间的时间戳。可是,在MYSQL里,TIMESTAMP的存储值和PHP里的TIMESTAMP并不一样,就象上文说的,它存储的格式和DATETIME是一样的,只是它是自动存入的。
当你的表存在TIMESTAMP字段时,如果你对其他字段的内容进行修改,这个字段的值也会随之更新,几乎可以这么理解,这个字段就是MYSQL给你提供的数据记录的最后一次更新时间,正因为这个原因,所以TIMESTAMP字段大多数时候都是被用来管理和检查数据使用,而不会用来存储实际数据(因为一旦其他数据有更新,它就会自动更新)。
有一些需要与客户端程序或者函数进行交互的数据库操作,只有在数据表里存在一列TIMESTAMP字段才能正常工作,如Connector/ODBC,事实上就连MYSQL在对数据进行内部管理的时候,也需要知道它们的最后一次修改时间。虽然说该字段会被自动更新,但如果你在INSERT、UPDATE的时候,如果你指定了该字段的值,默认就会使用该值插入数据表。如果一个表里面有多个字段有TIMESTAMP属性,那么默认MYSQL是更新第一个有此属性的字段。
TIMESTAMP并没有想象中的那么不可控制,从mysql4.1.3开始,MYSQL为TIMESTAMP增加了两个属性,它们可以让用户更好的调控对TIMESTAMP列的刷新行为,使得这个字段可以更加好的为我们服务。
| 设置类型 | 含义 |
| TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP | 在创建新记录或者修改现有记录的时候对这个数据列进行刷新 |
| TIMESTAMP | 行为同上 |
| TIMESTAMP DEFAULT CURRENT_TIMESTAMP | 只在创建新记录的时候才刷新这个值,以后更新等操作时不会进行修改 |
| TIMESTAMP ON UPDATE CURRENT_TIMESTAMP | 在创建新记录的时候设置值为0,在修改的时候才会更新它。 |
| TIMESTAMP DEFAULT 'YYYY-mm-dd hh:mm:ss' ON UPDATE CURRENT_TIMESTAMP | 在创建新记录的时候设置值为指定值,以后在修改的时候刷新它。 |
