如题。唉。。。
身体越来越差了,看看新闻,每天都有人过劳死,或者猝死。
不知道自己啥时候会变成这样。
膘叔的简单人生
如题。唉。。。
身体越来越差了,看看新闻,每天都有人过劳死,或者猝死。
不知道自己啥时候会变成这样。
前段时间放了一篇张宴关于GOOGLE架构的文章,张宴文中引用了google docs分享的一个PDF,然后我就全文复制过来了。
结果N个人和我抱怨说IE打开就死了。
因为在看完文章后,我去GOOGLE docs进行一下试用,它会把pdf,ppt都会搞类类似于幻灯片的方式共享,而且引用方法是采用了iframe
当朋友们和我抱怨时,我就在猜测,是不是这个iframe导致的。
于是,把内容放到文章页后,正常了。oh yeah...
这是一个比较老的分词程序,原文中的一些链接现在不是地址不正确就是打不开了。由此可以证明它是多老了。
再加上PHP直接进行分词的性能本来就不咋地,因此,建议仅仅用在很小的地方,比如自动添加TAG之类的。
原文如下:http://blog.sina.com.cn/s/blog_5677bc54010000i5.html
用PHP去做中文分词并不是一个太明智的举动, :p
下面是我根据网上找的一个字典档, 简易实现的一个分词程序.
(注: 字典档是gdbm格式, key是词 value是词频, 约4万个常用词)
代码请参见http://www.shi8.com/out/support/art_316.txt
<?php
//中文分词系统简易实现办法
//切句单位:凡是ascii值<128的字符
//常见双字节符号:《》,。、?“”;:!¥…… %$#@^&*()[]{}|\/"'
//可以考虑加入超常见中文字: 的 和 是 不 了 啊 (不过有特殊字比如 "打的" "郑和" .. :p)

//计算时间
function getmicrotime(){
list($usec, $sec) = explode(" ",microtime());
return ((float)$usec + (float)$sec);
}
$time_start = getmicrotime();


//词典类
class ch_dictionary {
var $_id;

function ch_dictionary($fname = "") {
if ($fname != "") {
$this->load($fname);
}
}

// 根据文件名载入字典 (gdbm数据档案)
function load($fname) {
$this->_id = dba_popen($fname, "r", "gdbm");
if (!$this->_id) {
echo "failed to open the dictionary.($fname)<br>\n";
exit;
}
}

// 根据词语返回频率, 不存在返回-1
function find($word) {
$freq = dba_fetch($word, $this->_id);
if (is_bool($freq)) $freq = -1;
return $freq;
}
}

// 分词类: (逆向)
// 先将输入的字串正向切成句子, 然后一句一句的分词, 返回由词组成的数组.
class ch_word_split {
var $_mb_mark_list; // 常见切分句子的全角标点
var $_word_maxlen; // 单个词最大可能长度(汉字字数)
var $_dic; // 词典...
var $_ignore_mark; // true or false

function ch_word_split () {
$this->_mb_mark_list = array(","," ","。","!","?",":","……","、","“","”","《","》","(",")");
$this->_word_maxlen = 12; // 12个汉字
$this->_dic = NULL;
$this->_ignore_mark = true;
}

// 设定字典
function set_dic($fname) {
$this->_dic = new ch_dictionary($fname);
}

function set_ignore_mark($set) {
if (is_bool($set)) $this->_ignore_mark = $set;
}

// 将字串切成句子再加以切分成词
function string_split($str, $func = "") {
$ret = array();

if ($func == "" || !function_exists($func)) $func = "";

$len = strlen($str);
$qtr = "";

for ($i = 0; $i < $len; $i++) {
$char = $str[$i];

if (ord($char) < 0xa1) {
// 读取到一个半角字符
if (!emptyempty($qtr)) {
$tmp = $this->_sen_split($qtr);
$qtr = "";

if ($func != "") call_user_func($func, $tmp);
else $ret = array_merge($ret, $tmp);
}

// 如果是单词或数字. 根据 char 将数据读取到 >= 0xa1为止
if ($this->_is_alnum($char)) {
do {
if (($i+1) >= $len) break;
$char2 = substr($str, $i + 1, 1);
if (!$this->_is_alnum($char2)) break;

$char .= $char2;
$i++;
} while (1);

if ($func != "") call_user_func($func, array($char));
else $ret[] = $char;
}
elseif ($char == ' ' || $char == "\t") {
// nothing.
continue;
}
elseif (!$this->_ignore_mark) {
if ($func != "") call_user_func($func, array($char));
else $ret[] = $char;
}
}
else {
// 双字节字符.
$i++;
$char .= $str[$i];

if (in_array($char, $this->_mb_mark_list)) {
if (!emptyempty($qtr)) {
$tmp = $this->_sen_split($qtr);
$qtr = "";

if ($func != "") call_user_func($func, $tmp);
else $ret = array_merge($ret, $tmp);
}

if (!$this->_ignore_mark) {
if ($func != "") call_user_func($func, array($char));
else $ret[] = $char;
}
}
else {
$qtr .= $char;
}
}
}

if (strlen($qtr) > 0) {
$tmp = $this->_sen_split($qtr);

if ($func != "") call_user_func($func, $tmp);
else $ret = array_merge($ret, $tmp);
}

// return value
if ($func == "") {
return $ret;
}
else {
return true;
}
}

// 将句子切成词, 逆向
function _sen_split($sen) {
$len = strlen($sen) / 2;
$ret = array();

for ($i = $len - 1; $i >= 0; $i--) {
// 如: 这是一个分词程序

// 先取得最后一个字
$w = substr($sen, $i * 2, 2);

// 最终的词长
$wlen = 1;

// 开始逆向匹配到最大长度.
$lf = 0; // last freq
for ($j = 1; $j <= $this->_word_maxlen; $j++) {
$o = $i - $j;
if ($o < 0) break;
$w2 = substr($sen, $o * 2, ($j + 1) * 2);

$tmp_f = $this->_dic->find($w2);
//echo "{$i}.{$j}: $w2 (f: $tmp_f)\n";
if ($tmp_f > $lf) {
$lf = $tmp_f;
$wlen = $j + 1;
$w = $w2;
}
}
// 根据 $wlen 将 $i 偏移了
$i = $i - $wlen + 1;
array_push($ret, $w);
}

$ret = array_reverse($ret);
return $ret;
}

// 判断字符是不是 字母数字_- [0-9a-z_-]
function _is_alnum($char) {
$ord = ord($char);
if ($ord == 45 || $ord == 95 || ($ord >= 48 && $ord <= 57))
return true;
if (($ord >= 97 && $ord <= 122) || ($ord >= 65 && $ord <= 90))
return true;
return false;
}
}


// 分词后的回调函数
function call_back($ar) {
foreach ($ar as $tmp) {
echo $tmp . " ";
//flush();
}
}

// 实例(如果没有输入就从 sample.txt中读取):
$wp = new ch_word_split();
$wp->set_dic("dic.db");

if (!isset($_REQUEST['testdat']) || emptyempty($_REQUEST['testdat'])) {
$data = file_get_contents("sample.txt");
}
else {
$data = & $_REQUEST['testdat'];
}

// output
echo "<h3>简易分词演示</h3>\n";
echo "<hr>\n";
echo "分词结果(" . strlen($data) . " chars): <br>\n<textarea cols=100 rows=10>\n";

// 设定是否忽略不返回分词符号(标点,常用字)
$wp->set_ignore_mark(false);

// 执行切分, 如果没有设置 callback 函数, 则返回由词组成的array
$wp->string_split($data, "call_back");

$time_end = getmicrotime();
$time = $time_end - $time_start;

echo "</textarea><br>\n本次分词耗时: $time seconds <br>\n";
?>
<hr>
<form method=post>
您也可以在下面文本框中输入文字,提交后试验分词效果:<br>
<textarea name=testdat cols=100 rows=10></textarea><br>
<input type=submit>
</form>
<hr>
冰山上的博客,更新速度之快,令我乍叹不已,我以为我算是勤劳的,想不到,他更是属于勤劳中的勤劳分子。。
以下内容又是COPY于他的网站,看来,他关注的部分内容还是比我高档,我仍然沉迷于一些小技巧,而忽略了一些大的东西。
心有多大,舞台有多大,其实这对技术人员来说非常重要,如果你只注重于一小块技术,那么在大的方面,你永远不会有进步。
扯远了。。不过以下一些小技巧我真的大部分都没有用过,所以我才会贴出来,让大家一起学习一下,如果知道的就直接跳过,当我没说。
内容如下:http://xinsync.xju.edu.cn/index.php/archives/4719
前言:
实验的数据表如下定义:
mysql> desc tbl_name;
+-------+--------------+------+-----+---------+-------+
| Field | Type         | Null | Key | Default | Extra |
+-------+--------------+------+-----+---------+-------+
| uid   | int(11)      | NO   |     | NULL    |       |
| sid   | mediumint(9) | NO   |     | NULL    |       |
| times | mediumint(9) | NO   |     | NULL    |       |
+-------+--------------+------+-----+---------+-------+
3 rows in set (0.00 sec)
存储引擎是MyISAM,里面有10,000条数据。
一、”\G”的作用
mysql> select * from tbl_name limit 1;
+--------+--------+-------+
| uid    | sid    | times |
+--------+--------+-------+
| 104460 | 291250 |    29 |
+--------+--------+-------+
1 row in set (0.00 sec)

mysql> select * from tbl_name limit 1\G;
*************************** 1. row ***************************
  uid: 104460
  sid: 291250
times: 29
1 row in set (0.00 sec)
有时候,操作返回的列数非常多,屏幕不能一行显示完,显示折行,试试”\G”,把列数据逐行显示(”\G”挽救了我,以前看explain语句横向显示不全折行看起来巨费劲,还要把数据和列对应起来)。
二、”Group by”的”隐形杀手”
mysql> explain select uid,sum(times) from tbl_name group by uid\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 10000
        Extra: Using temporary; Using filesort
1 row in set (0.00 sec)

mysql> explain select uid,sum(times) from tbl_name group by uid order by null\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: ALL
possible_keys: NULL
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 10000
        Extra: Using temporary
1 row in set (0.00 sec)
默认情况下,Group by col会对col字段进行排序,这就是为什么第一语句里面有Using filesort的原因,如果你不需要对col字段进行排序,加上order by null吧,要快很多,因为filesort很慢的。
三、大批量数据插入
最高效的大批量插入数据的方法:
load data infile ‘/path/to/file’ into table tbl_name;
如果没有办法先生成文本文件或者不想生成文本文件,可以一次插入多行:
insert into tbl_name values (1,2,3),(4,5,6),(7,8,9)…
注意一条sql语句的最大长度是有限制的。如果还不想这样,可以试试MySQL的prepare,应该都会比硬生生的逐条插入要快许多。
如果数据表有索引,建议先暂时禁用索引:
alter table tbl_name disable keys;
插入完毕之后再激活索引:
alter table tbl_name enable keys;
对MyISAM表尤其有用。避免每插入一条记录系统更新一下索引。
四、最快复制表结构方法
mysql> create table clone_tbl select * from tbl_name limit 0;
Query OK, 0 rows affected (0.08 sec)
只会复制表结构,索引不会复制,如果还要复制数据,把limit 0去掉即可。
五、加引号和不加引号区别
给数据表tbl_name添加索引:
mysql> create index uid on tbl_name(uid);
测试如下查询:
mysql> explain select * from tbl_name where uid = '1081283900'\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: ref
possible_keys: uid
          key: uid
      key_len: 4
          ref: const
         rows: 143
        Extra:
1 row in set (0.00 sec)
我们在整型字段的值上加索引,是可以用到索引的,网上不少人误传在整型字段上加引号无法使用索引。修改uid字段类型为varchar(12):
mysql> alter table tbl_name change uid uid varchar(12) not null;
测试如下查询:
mysql> explain select * from tbl_name where uid = 1081283900\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: ALL
possible_keys: uid
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 10000
        Extra: Using where
1 row in set (0.00 sec)
我们在查询值上不加索引,结果索引无法使用,注意安全。
六、前缀索引
有时候我们的表中有varchar(255)这样的字段,而且我们还要对该字段建索引,一般没有必要对整个字段建索引,建立前8~12个字符的索引应该就够了,很少有连续8~12个字符都相等的字段。
为什么?更短的索引意味索引更小、占用CPU时间更少、占用内存更少、占用IO更少和很更好的性能。
七、MySQL索引使用方式
MySQL在一个查询中只能用到一个索引(5.0以后版本引入了index_merge合并索引,对某些特定的查询可以用到多个索引,具体查考[中文] [英文]),所以要根据查询条件建立联合索引,联合索引只有第一位的字段在查询条件中能才能使用到。
如果MySQL认为不用索引比用索引更快的话,那么就不会用索引。
mysql> create index times on tbl_name(times);
Query OK, 10000 rows affected (0.10 sec)
Records: 10000  Duplicates: 0  Warnings: 0

mysql> explain select * from tbl_name where times > 20\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: ALL
possible_keys: times
          key: NULL
      key_len: NULL
          ref: NULL
         rows: 10000
        Extra: Using where
1 row in set (0.00 sec)

mysql> explain select * from tbl_name where times > 200\G;
*************************** 1. row ***************************
           id: 1
  select_type: SIMPLE
        table: tbl_name
         type: range
possible_keys: times
          key: times
      key_len: 3
          ref: NULL
         rows: 1599
        Extra: Using where
1 row in set (0.00 sec)
数据表中times字段绝大多数都比20大,所以第一个查询没有用索引,第二个才用到索引.
以下内容来自于两个博客的内容合并。
首先是来自于冰山上的博客的关于atime、mtime与ctime的介绍(我估计作者也是COPY来的,因为最后两段明显单词断行了,没有修改):
原文:http://xinsync.xju.edu.cn/index.php/archives/4683
atime 访问时间(access time):访问时间是文件最后一次被读取的时间。因此阅读一个文件会更新它的访问时间,而它的改变时间并没有变化(有关文件状态的信息没有被改变),它的修改时间也同样没有变化(文件内容本身没有被改变);
mtime 修改时间(modification time):文件内容最后被修改的时间。如 echo “Hello” >myfile ,则myfile的mtime被改变,同时ctime和atime也被改变;
ctime 改变时间(change time):文件状态(status)最后被改变的时间。如 chmod a+w myfile ,则myfile的ctime被改变,atime和mtime都不变;
参考:
st_atime
Time when file data was last accessed. Changed by the following functions: creat(), mknod(), pipe(), utime(2), and read(2).
st_mtime
Time when data was last modified. Changed by the fol-lowing functions: creat(), mknod(), pipe(), utime(),and write(2).
st_ctime
Time when file status was last changed. Changed by the following functions: chmod(), chown(), creat(),link(2), mknod(), pipe(), unlink(2), utime(), and write().
然后下面的内容又来自于知道分子的博客:http://hutuworm.blogspot.com/2009/03/blog-post_31.html
Linus 大神最近将一项名为 relatime 的特性设定为内核默认行为。(参阅:Matthew Garrett,Reducing disk use)
UNIX 文件系统中的 ctime、mtime、atime 属性分别记录了文件的创建时戳、修改时戳和访问时戳。每当有进程创建、修改、访问某个文件时,文件系统就会保存相应的时戳。对于一般用户而言,文件系统自 动记录这些时戳所花费的时间根本不值一提,完全可以忽略不计。但对于某些特定用途的生产服务器,比如存储大量小图片文件的服务器(写少读多),若每次读取 一个文件都要修改该文件的 atime——想像中的单纯读取操作,实际上却是一读一写——如果这些服务器访问量还挺大,那么这个过程中的消耗则无疑值得斤斤计较、细细考究了。
以 往我们为了节省不必要的 atime 改写,常常采用的方法,是通过 mount 选项 noatime 挂载文件系统,完全摈弃该属性。但随之而来的问题是,某些依赖于 atime 属性的系统程序无法正常工作。而 relatime 补丁的改进之处在于,仅当 atime 比 ctime 或 mtime 更早,或者早于当前时间 24 小时以上,系统才会去修改 atime,由此就大幅度减少了 atime 改写操作,提升了文件系统性能。该项功能已在 Fedora 和 Ubuntu 去年的新版本中发布。
其 实,可以节省的地方还有很多。上周小算了一笔账,某个页面引用的 js 和 css 文件 Expire 时间为 900 秒,一部分图片的 Expire 时间为 12 小时,另一部分图片的 Expire 时间为 4 天——假设该页面内容不变、访问量不变,那么一年的相关静态文件总下载量为数万 GB;如果把这些静态文件的 Expire 时间统一调整为一个月,那么总下载量可以下降一个数量级,降到几千 GB;如果胆子大一点、步子快一点,统一调整为一年,那么总下载量还可以再降一个数量级,降到几百 GB。阿米豆腐,这样的估算结果真是令人咋舌。
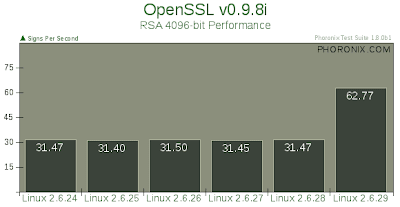
这两天又看了三篇跟性能优化相关的报道。一篇报道是 Linux Magazine 采访 Theodore Ts'o,其中提到 Google 的工程师向 Ext4 文件系统开发者提交了一个取消日志补丁,以获得更高的性能,可以看出,这个功能对于 Google 非常重要。一篇报道是 Red Hat 官方新闻,说 RHEL 5.3 开始支持 Intel 的 QuickPath 内存技术,运行内存密集型的应用可以获得两倍性能提升——显然这得归功于 Nehalem CPU 的崭新架构和超强性能。另一篇报道是 Linux Kernel 2.6.24 到 2.6.29 横向测试,OpenSSL 在 2.6.29 内核上测得性能比前几个版本高出一倍:
无论如何,关注这些信息,稍微算一算,我们就知道随便从其中找一项出来优化,可以提升多少性能、节省多少资源。虽说咱不差钱,但能省干嘛不省呢?
cyberarticle这款软件一直在用,最近订阅的博客也越来越多,能够想到的就是把一些我认为对我来说是知识点的东西,用它记录下来,以后如果有空可以慢慢翻阅,如果没空,那也可以拿它作为资料库,以后备查。
目前收藏的文章还不多,慢慢来。本来是用Firefox的scrapBook进行收藏的,不料几次收藏都因为格式化机器把存下来的资料都卡嚓了。
伤感啊
收藏的东西还是和自己所从事的行业比较相关,以后慢慢收藏一些好文章
原文来自:http://blog.s135.com/post/407/,本来纯粹是转载。
不过,我看到张宴博客里介绍的时候,很是惊讶于google docs的功能,原来,google docs居然也能够象其他那些Webshare网站那样显示PPT或者PDF?点击放大后,还能够下载成PDF或者PPT,而且效果不错,感觉就象FLASH一样。看来什么时候是需要学习一下如何使用了,因为google的速度不错,在与很多人分享资料的时候就比较方便了
不说废话,说原文。。
以下是 Google 检索系统的架构师、Google Mapreduce 的发明者 Jeff Dean 在 WSDM 2009 上的主题演讲:《Challenges in Building Large-Scale Information Retrieval Systems》。在这个主题演讲中,Jeff Dean 讲述了 Google 在10年中,Google 检索系统的演变和发展。
英文原文:http://research.google.com/people/jeff/WSDM09-keynote.pdf
演讲视频:http://videolectures.net/wsdm09_dean_cblirs/
中文译文(由银杏泰克有限公司郝培强翻译):
看看别人是怎么评价技术骨干做项目经理的,其实任何事都有利弊啦,不过这里说的几乎都是弊。
学工商管理的时候,对于一个职业往往都是讲究内拔外选,其实是和这个道理是一样。
内拔,对于内部的信息、资料都相对比较熟悉,同样,还有对于人员的能力也是相对熟悉,配合起来可能会比较方便,但缺点是眼界可能不会太开阔,比较容易局限于目前的视野
外选,可能技术能力较强,但同样也有缺点,很多人对于空降兵比较排斥,对于人员的能力不熟悉,短时间内不知道如何分配资源。
再看看别人说的吧:http://www.cnblogs.com/laozizhu/archive/2009/04/04/1429640.html
开发骨干,由于主要或全部精力均忙于具体技术工作,各种项目管理任务(如:项目分析/评估、项目计划的制定/检查/调整、上下左右的沟通、专业资源调配、 项目组织调整、项目财务控制、风险分析/对策等)不可避免地疏于顾及,项目管理的事情“没人做”,导致项目控制的问题“积劳成疾”,后悔莫及。
技术骨干担任的项目经理,不可避免地存在着“技术崇拜”,尽可能采用新技术。即使是需求明确的功能,由于实现方式有多种路径,一般都是从技术上采取最优的 路径,而不是从用户操作方便的角度上选择操作最方便、快捷的路径,用户必须严格按开发人员所预设的操作方式进行操作。
说句老实话,用户是不管你用什么技术的,先进或落后的技术都可以,只要能满足用户的需求即可。这种类似闭门造车生产出来的产品,自然就是操作不便,功能差 强人意的。还有一种情况是,这种情况一般发生在项目后期,开发产品的情况较多,随着开发的深入,总会发现缺少某些功能,或者某些功能不够强大。项目经理对 功能的增加、删除、修改,不是通过集体讨论确定或通过从市场前线人员中了解确定,而是通过凭空想象,拍脑袋来作出决定。特别是对于某些功能的添加,由于项 目经理都无法把握用户是否需要这个功能,需要这个功能的程度,因此是很难令开发人员把握此功能的目的。当然,既然大家都无法把握用户是否会用这个功能,那 自然是应付式开发。只要过了测试,过了项目经理这一关就OK拉。
首先我们看一下php手册中关于删除cookie的说明
------以下引用php手册内容--------------
要删除 cookie 需要确保它的失效期是在过去,才能触发浏览器的删除机制。
下面的例子说明了如何删除刚才设置的 cookie: 例子 2. setcookie() 删除
例子
// 将过期时间设为一小时前
----------------引用结束--------------------------
删除一个cookie的方法就是把这个cookie的有效期设置为当前时间以前,这
也是几乎所有php程序员都会这么做。
后来一个初接触php的朋友告诉我,他在程序中本想把一个cookie的值设置为
空,结果导致这个cookie直接被删除。我当时的第一反应是不相信,于是测试
了一下
结果果然是整个$_COOKIE数组都是空的,而非仅仅$_COOKIE['testcookie']为
空.于是用winsock抓包,观察返回的http头,发现http头竟然是
这说明setcookie("testcookie", '');的的确确是将testcookie这个cookie直
接删除.而关于这种情况在php手册中完全没有说明.
最后阅读php源码,终于发现真相(这就是开源的好处了,有什么不清楚的内幕
直接查源码)
以下代码可以在php5.20的linux源码包中ext/standard/head.c第99行附近找到.
if (value && value_len == 0) {
/*
* MSIE doesn't delete a cookie when you set it to a null value
* so in order to force cookies to be deleted, even on MSIE, we
* pick an expiry date 1 year and 1 second in the past
*/
time_t t = time(NULL) - 31536001;
dt = php_format_date("D, d-M-Y H:i:s T", sizeof("D, d-M-Y H:i:s T")-1, t, 0 TSRMLS_CC);
sprintf(cookie, "Set-Cookie: %s=deleted; expires=%s", name, dt);
efree(dt);
} else {
sprintf(cookie, "Set-Cookie: %s=%s", name, value ? encoded_value : "");
if (expires > 0) {
strcat(cookie, "; expires=");
dt = php_format_date("D, d-M-Y H:i:s T", sizeof("D, d-M-Y H:i:s T")-1, expires, 0 TSRMLS_CC);
strcat(cookie, dt);
efree(dt);
}
}
源码中清清楚楚的显示,if (value && value_len == 0) ,当value_len为0
时
sprintf(cookie, "Set-Cookie: %s=deleted; expires=%s", name, dt);
会发送删除cookie的http头给浏览器.
最后我们可以得出结论,在php中使用
setcookie($cookiename, '');或者 setcookie($cookiename, NULL);
都会删除cookie,当然这些手册中并没有。
其实本来以前并不关心这些知识啥的,但,身为一名IT工作者,其实我们经常会饮食不规律、作息时间不规律,因此在看到这些从小处就可以进行简单养生的知识时,还是觉得要参考参考的。
原文载自:http://rdc.taobao.com/blog/qa/?p=1401
很多不经意、不正确的行为方式或饮食行为会让你丢失大量的营养素,比如含有合成维生素D的牛奶会夺取人体中的镁;住在充满污烟的都市的人比住在乡下的人获取维生素D的量要少得多,因为空气中的烟把太阳的紫外线都挡住了……
1.多吃纤维,钙质流失!
过多的膳食纤维使食物通过肠道速度增加,使钙的吸收率降低;有研究表明:两个成年人的饮食从每顿纤维含量低的精面包改为每顿纤维含量高的粗面包时,钙(镁、锌和磷)随着出现负平衡。
2. 狂吃肉和蛋,导致铁“滚蛋”!
现在的孩子大都爱吃各种肉类,就是不爱吃蔬菜和水果,家长也认为:只要多吃富含铁锌的肉鱼蛋,蔬菜水果吃不吃无所谓。结果是:不但孩子的体重蹭蹭地往上 “窜”,而且一检查照样患有缺铁性贫血。因为人们膳食中所摄入的瘦肉、动物内脏、蛋黄中的铁多为三价铁,不易被人体吸收,只有在有维生素C和酸味物质(富 含苹果酸、酒石酸、柠檬酸等多种有机酸)存在的情况下,转化成二价铁才能被人体充分地吸收和利用。而维生素C和酸味物质在蔬菜和水果(如猕猴桃、柠檬、鲜 枣、酸枣、橘子、草莓、苹果)中含得最多。如果一味地只吃瘦肉、动物内脏、蛋黄等食物,而不吃或少吃蔬菜和水果,这些食物中的铁质就不能被人体吸收与利 用,造成营养的极大浪费,出现缺铁性贫血。>>>补铁同时还需补维生素C
3. 钙磷失衡“赶走”钙!
钙磷比例失衡是导致目前人们缺钙的元凶。正常情况下,人体内的钙磷比例是2∶1,然而,现实生活中,人们过多地摄入碳酸饮料、可乐、咖啡、汉堡包、比萨 饼、小麦胚芽、动物肝脏、炸薯条等大量含磷的食物,磷的摄入量往往超过了钙10倍以上,使钙∶磷比例高达1:10~20,钙磷的比例严重失衡,这样,饮食 中过多的磷便会拼命地把体内的钙“赶”出体外。
4. 药物导致营养流失!
大多数使用避孕药的女性朋友可能还不知道避孕药有阻碍维生素B6、B12、叶酸及维生素C的作用,避孕药中的黄体素会阻碍维生素B6的功能,妨碍叶酸的吸 收;阿司匹林则会使排出体外的维生素C较正常量增加3倍。大把大把的维生素C补充剂会“赶跑”体内的叶酸。抗癫痫药也会妨碍叶酸吸收。长期服用抗生素者, 会流失维生素B群及维生素K,影响肠胃功能;感冒药及止痛剂会降低血液中维生素A含量;黄胺类药及降胆固醇药会影响叶酸吸收。高血压患者、肾炎患者服用的 利尿剂以及泻药等,都会导致体内的钙质、钾、维生素大量流失;患胃溃疡、失血性贫血的人,服用抗酸剂、碱性药物的病人,会导致微量元素铁的大量流失。
5.抽烟喝酒 营养溜走!
长期抽烟、喝酒破坏了维持良好健康所必需的维生素。抽烟会破坏体内维生素C——这种能预防癌症和心脏病的营养素。每天抽半包烟就会破坏体内25~100毫 克的维生素C;每天喝一杯以上的鸡尾酒,享受飘飘欲仙的代价就是使体内维生素B1、B6和叶酸消耗掉,酗酒者缺乏维生素B1也是相当普遍的。
6 .VitC泡腾,您会用吗?
在公司工作的李小姐,她很讲究营养,每餐后用开水冲一大杯富含维生素C的饮料(如TANG果珍或维生素C泡腾片),可近来不知为什么一刷牙,牙龈总出血, 她很害怕,就跑来咨询,按理说,果珍或维生素C泡腾片是富含维生素C的,为什么还会出现牙龈出血的症状呢?原来,维生素C是一种水溶性维生素,它不很稳 定。用超过80℃以上的水冲服会使维生素C遭到严重破坏,更不用说100℃的开水了。用开水冲富含维生素C的饮料,真正喝到肚子里的维生素C含量已经所剩 无几了。所以,不应用开水,而应用温水冲富含维生素C的饮料。
7.补钙不补镁,吃完就后悔!
人们补钙的时候,只注意补充维生素D,却往往不知道要补充镁。钙与镁似一对双胞胎兄弟,总是要成双成对地出现,而且钙与镁的比例为2:1是最利于钙的吸收 利用的了。所以,在补钙的时候,切记不要忘了补充镁。含镁较多的食物有:坚果(如杏仁、腰果和花生)、黄豆、瓜籽(向日葵籽、南瓜籽)、谷物(特别是黑 麦、小米和大麦)、海产品(金枪鱼、鲑鱼、鲭鱼、小虾、龙虾)。
8.大鱼大肉“吃”掉钙!
高蛋白饮食是引起骨质疏松症的原因所在。有人曾做过这样的实验:A:每天摄入80克的蛋白质,将导致37毫克的钙流失;B:每天摄入240克的蛋白质,额 外另补充1400毫克的钙,将导致137毫克钙的流失。这说明:额外补充钙并不能阻止高蛋白所引起的钙流失。这是因为过多的摄入大鱼大肉这些酸性食物,易 使人们产生酸性体质。而人体无法承受血液中酸碱度激烈的变化,于是,身体就会动用两种主要的碱性物质——钠和钙——加以中和。当体内的钠用光了的时候,就 会启用身体内的钙,所以,过量摄入大鱼大肉而不注意酸碱平衡,将导致钙的大量流失。这也是那些大款、常吃宴席(饮食特点是:肉多酒多油多菜少饭少)的人常 常莫名其妙地感到疲倦、头晕、体力不支的原因所在!紧随其后的是赶上了“代谢综合症”(高血压、高血脂、糖尿病、肥胖、脂肪肝、痛风等等)的时髦病。
9.碳酸饮料,不可多饮!
现在的孩子们吃饭时,都喜欢拿饮料当水喝,什么可乐啦、果汁饮料等,这些碳酸饮料中的碳酸会与体内的钙形成不溶性的碳酸钙,会夺走您所吃进去的食物中的钙质,造成钙流失,引起钙缺乏的症状。
10.鸡蛋吃法多样,吸收不同!
就营养的吸收和消化率来讲,煮蛋为100%,炒蛋为97%,嫩炸为98%,老炸为81.1%,开水、牛奶冲蛋为92.5%,生吃为30%~50%。由此来 说,煮鸡蛋是最佳的吃法,但要注意细嚼慢咽,否则会影响吸收和消化。不过,对儿童和老年人来说,还是蒸蛋羹、蛋花汤最适合,因为这两种做法能使蛋白质分 解,极易被消化吸收。>>>意想不到的鸡蛋壳妙用
11 .化弊为利,提高效率!
如含草酸多的蔬菜(菠菜、苋菜、冬笋、荷兰芹和绿菜花)应在沸水中焯一下再炒,以除去草酸,避免草酸同钙结合成一种不溶性的草酸钙,提高钙的吸收利用率; 存在于大豆、小麦及谷物的外壳中的植酸,易与钙、锌结合成不溶性植酸盐,可采用发芽、发酵、浸泡等方法以激活植酸分解酶活性,使其分解植酸,从而提高钙、 锌在人体内的消化吸收率。另外,因为面粉中含植酸较多,做面食时,尽可能使其发酵。面粉经发酵,植酸分解酶活性增强,可以分解面粉中的植酸,促进面食中 钙、锌的消化吸收。
12 .营养配餐 学问多多!
比如溜肝尖这道菜:主料用肝,辅料有的用黄瓜,有的用柿子椒,相比之下辅料用柿子椒就比用黄瓜要科学的多!因为肝脏中富含微量元素铁和锌,而柿子椒中的维 生素C多于黄瓜,维生素C即可促使肝脏中三价铁转化为二价铁,利于机体更好地吸收铁和锌这两种营养素!再如豆腐炖鱼,鱼肉中含维生素D,豆腐含钙丰富。维 生素D可促进钙的吸收,使豆腐中钙的利用率大大提高。另外,主食讲究谷豆类混食,不仅能使氨基酸互补达到最理想化,还能促进钙的吸收。
13 .睡前应否小餐?
促进成长!有一项研究表明:在睡觉时,人体在不断地排除旧的骨骼组织,这个过程大约在凌晨3点速度最快,所以,睡前加杯酸奶就能及时补充钙源,能确保夜间你的钙指数更稳定。
14 .豆芽并非越长越好!
邻居的张大妈就喜欢买长长的豆芽,她认为这样的豆芽最有营养!其实不然!将大豆发芽后,促进钙、锌、铁吸收的游离氨基酸、总游离氨基酸以及还原型维生素C 明显增加;另外,在大豆发芽过程中植酸酶活性不断升高,不断地水解植酸,致使植酸——这一妨碍钙、锌、铁吸收的主要抑制因子呈现下降趋势,比大豆或豆腐中 植酸含量下降40%,进而大大地提高了发芽大豆中钙、锌、铁的生物利用率,而且以发3~4天(长约4~5厘米)的豆芽营养为最好,并不是人们所想象的芽长 的越长越好、越有营养。>>>长寿不难,从豆芽开始
15 .看似很多,实际很少!
牛奶以其含钙量高且吸收利用率好优点被全世界公认为极佳的天然补钙食物来源。但是喝牛奶是很讲究的!看似吃进去许多牛奶但是真正能吸收的并不多!不少人在 喝完牛奶或吃完乳制品时会出现放屁、胃气胀、腹绞痛和拉肚子等乳糖不耐受的不舒服的现象,最近从国际乳品会议上得知:在亚洲人中有70%不吸收乳糖,中国 人中有75~100%存在乳糖不耐受,如北京为69.4% 、上海为75.8%、哈尔滨为68.9%、广州为70%,为使您能吸收更多的钙质,建议您喝 经过发酵了的酸奶,尤以富含多种乳酸菌的、双歧杆菌的酸奶为佳。
16 .老人饮奶、得不偿失!
牛奶含有5%的乳糖,通过乳酸酶的作用,分解成半乳糖,极易沉积在老年人的晶状体上,导致晶状体透明度降低诱发老年性白内障的发生。老年人可以选用虾皮、 虾米、鱼类、贝类、蛋类、肉骨头、海带及田螺、芹菜、豆制品、芝麻、红枣、黑木耳等含钙高的食物来补钙,以天然食物为最佳。
17 .空腹喝牛奶
有人喜欢清晨空腹喝杯牛奶就当早餐了,殊不知这种做法很不好。食物经过了一晚上的消化吸收,胃肠道里几乎空空的了,如果早晨起来空肚子喝牛奶,就使牛奶还 未等被机体充分的吸收,就顺着空空的胃肠道排了出去,造成营养的极大浪费。所以喝牛奶时最好吃些饼干、面包或花卷、馒头之类的碳水化合物,千万不要空腹喝 牛奶。
18 .牛奶与巧克力同吃 NO!
有人喜欢将巧克力加入牛奶中,以去除牛奶中的怪味。事实上这是不科学的。牛奶含有丰富的钙和蛋白质,而巧克力中含有草酸,牛奶和巧克力一起吃时,牛奶中的 钙易于巧克力中的草酸形成不溶于水沉淀物——草酸钙。人不但无法吸收,时间长了,还会出现头发干枯、腹泻、缺钙和生长发育迟缓等现象。所以,喝牛奶和吃巧 克力的时间要分开。
19 .生吃胡萝卜不吸收!
常见一些老婆婆给孩子吃些生的胡萝卜,她们讲:这样既可磨牙,又可补充“维他命”,这是发生在我们生活中最为典型的营养误区。生吃胡萝卜很不科学。将胡萝 卜分别生食、用微量的油脂烹调、用足量的油脂烹调,测胡萝卜素的消化吸收率分别为10%、30%、90%。可见,胡萝卜素在体内消化吸收率与油脂配比成正 比;胡萝卜用食油烹制后食用比生的食用营养价值高。>>>胡萝卜下酒会中毒
20.“皮”很重要 弃之可惜!
茄子、蓝莓和葡萄的皮中含有大量多酚,这是一种抗氧化剂,具有防止自由基氧化,延缓衰老的作用,去掉皮食用是很可惜的!另外,去掉番茄的皮也会使番茄中的很重要的抗氧化物质——番茄红素容易随汁液流失,不利于维护健康。
