标签:架构

浏览模式: 标准 | 列表 | 图文
Facebook图片管理架构(转帖学习一下)

Facebook图片管理架构(转帖学习一下)

Facebook 的照片分享很受欢迎,迄今,Facebook 用户已经上传了150亿张照片,加上缩略图,总容量超过1.5PB,而每周新增的照片为2亿2000万张,约25TB,高峰期,Facebook 每秒处理55万张照片,这些数字让如何管理这些数据成为一个巨大的挑战。本文由 Facebook 工程师撰写,讲述了他们是如何管理这些照片的。

旧的 NFS 照片架构
老的照片系统架构分以下几个层:
# 上传层接收用户上传的照片并保存在 NFS 存储层。
# 照片服务层接收 HTTP 请求并从 NFS 存储层输出照片。
# NFS存储层建立在商业存储系统之上。

因为每张照片都以文件形式单独存储,这样庞大的照片量导致非常庞大的元数据规模,超过了 NFS 存储层的缓存上限,导致每次招聘请求会上传都包含多次I/O操作。庞大的元数据成为整个照片架构的瓶颈。这就是为什么 Facebook 主要依赖 CDN 的原因。为了解决这些问题,他们做了两项优化:
# Cachr: 一个缓存服务器,缓存 Facebook 的小尺寸用户资料照片。
# NFS文件句柄缓存:部署在照片输出层,以降低 NFS 存储层的元数据开销。

新的 Haystack 照片架构
新的照片架构将输出层和存储层合并为一个物理层,建立在一个基于 HTTP 的照片服务器上,照片存储在一个叫做 haystack 的对象库,以消除照片读取操作中不必要的元数据开销。新架构中,I/O 操作只针对真正的照片数据(而不是文件系统元数据)。haystack 可以细分为以下几个功能层:
# HTTP 服务器
# 照片存储
# Haystack 对象存储
# 文件系统
# 存储空间

存储
Haystack 部署在商业存储刀片服务器上,典型配置为一个2U的服务器,包含:
# 两个4核CPU
# 16GB – 32GB 内存
# 硬件 RAID,含256-512M NVRAM 高速缓存
# 超过12个1TB SATA 硬盘

每个刀片服务器提供大约10TB的存储能力,使用了硬件 RAID-6, RAID 6在保持低成本的基础上实现了很好的性能和冗余。不佳的写性能可以通过高速缓存解决,硬盘缓存被禁用以防止断电损失。
文件系统
Haystack 对象库是建立在10TB容量的单一文件系统之上。文件系统中的每个文件都在一张区块表中对应具体的物理位置,目前使用的文件系统为 XFS。
Haystack 对象库
Haystack 是一个简单的日志结构,存储着其内部数据对象的指针。一个 Haystack 包括两个文件,包括指针和索引文件:
32083941cbd686a90e93fddd3ac80c8c

Haystack 对象存储结构

48e61ae54908465dff3af2ad6af39f17

f283625af14fa7f8aaff01e9693c10d5

指针和索引文件结构

Haystack 写操作
Haystack 写操作同步将指针追加到 haystack 存储文件,当指针积累到一定程度,就会生成索引写到索引文件。为了降低硬件故障带来的损失,索引文件还会定期写道存储空间中。

Haystack 读操作
传到 haystack 读操作的参数包括指针的偏移量,key,代用Key,Cookie 以及数据尺寸。Haystack 于是根据数据尺寸从文件中读取整个指针。

Haystack 删除操作
删除比较简单,只是在 Haystack 存储的指针上设置一个已删除标志。已经删除的指针和索引的空间并不回收。

照片存储服务器
照片存储服务器负责接受 HTTP 请求,并转换成相应的 Haystack 操作。为了降低I/O操作,该服务器维护着全部 Haystack 中文件索引的缓存。服务器启动时,系统就会将这些索引读到缓存中。由于每个节点都有数百万张照片,必须保证索引的容量不会超过服务器的物理内存。

对于用户上传的图片,系统分配一个64位的独立ID,照片接着被缩放成4种不同尺寸,每种尺寸的图拥有相同的随机 Cookie 和 ID,图片尺寸描述(大,中,小,缩略图)被存在代用key 中。接着上传服务器通知照片存储服务器将这些资料联通图片存储到 haystack 中。

每张图片的索引缓存包含以下数据
6e338a0b8bbafeeb71ed769024d5a6fb

Haystack 使用 Google 的开源 sparse hash data 结构以保证内存中的索引缓存尽可能小。
照片存储的写/修改操作
写操作将照片数据写到 Haystack 存储并更新内存中的索引。如果索引中已经包含相同的 Key,说明是修改操作。

照片存储的读操作
传递到 Haystack 的参数包括 Haystack ID,照片的 Key, 尺寸以及 Cookie,服务器从缓存中查找并到 Haystack 中读取真正的数据。

照片存储的删除操作
通知 Haystack 执行删除操作之后,内存中的索引缓存会被更新,将便宜量设置为0,表示照片已被删除。

重新捆扎
重新捆扎会复制并建立新的 Haystack,期间,略过那些已经删除的照片的数据,并重新建立内存中的索引缓存。

HTTP 服务器
Http 框架使用的是简单的 evhttp 服务器。使用多线程,每个线程都可以单独处理一个 HTTP 请求。

结束语
Haystack 是一个基于 HTTP 的对象存储,包含指向实体数据的指针,该架构消除了文件系统元数据的开销,并实现将全部索引直接存储到缓存,以最小的 I/O 操作实现对照片的存储和读取。

本文国际来源:http://www.facebook.com/FacebookEngineering#/note.php?note_id=76191543919&ref=mf

中文翻译来源:COMSHARP CMS 官方网站

我的来源:http://zys.8800.org/index.php/archives/334
又拍网架构-又一个用到python的网站

又拍网架构-又一个用到python的网站

原文在这里:http://www.bopor.com/?p=652,我只是做个简单的转述。主要是因为这种架构在单台服务器上也可以做个参考,比如队列,当我一台服务器承受不了太大的访问时,我可以先把很多东西扔到队列里去,交由后台执行(当然是指一些比较重要而又不需要即时显示的。比如图片处理等 )

OK,不多说了,直接上原文的重点为:

分库设计,数据库拆分

最初是由一台主库和一台从库组成,当时从库只用作备份和容灾,当主库出现故障时,从库就手动变成主库,一般情况下,从库不作读写操作(同步除外)。随着压力的增加,我们加上了memcached,当时只用其缓存单行数据。但是,单行数据的缓存并不能很好地解决压力问题,因为单行数据的查询通常很快。所以我们把一些实时性要求不高的Query放到从库去执行。后面又通过添加多个从库来分流查询压力,不过随着数据量的增加,主库的写压力也越来越大。
怎么样对应用户和数据库呢?
· 按算法对应
· 按索引/映射表对应

分库会给你在应用的开发和部署上都带来很多麻烦。
· 不能执行跨库的关联查询
· 不能保证数据的一致/完整性
· 所有查询必须提供数据库线索
· 自增ID

如果要在节点数据库上使用自增字段,那么我们就不能保证全局唯一。这倒不是很严重的问题,但是当节点之间的数据发生关系时,就会使得问题变得比较麻烦。我们可以再来看看上面提到的评论的例子。如果photo_comments表中的comment_id的自增字段,当我们在DB- 2.photo_comments表插入新的评论时,得到一个新的comment_id,假如值为101,而User-A的ID为1,那么我们还需要在DB-1.user_comments表中插入(1, 101 …)。 User-A是个很活跃的用户,他又评论了User-C的照片,而User-C的数据库是DB-3。很巧的是这条新评论的ID也是101,这种情况很用可能发生。那么我们又在DB-1.user_comments表中插入一行像这样(1, 101 …)的数据。那么我们要怎么设置user_comments表的主键呢(标识一行数据)?可以不设啊,不幸的是有的时候(框架、缓存等原因)必需设置。那么可以以 user_id、 comment_id和photo_id为组合主键,但是photo_id也有可能一样(的确很巧)。看来只能再加上photo_owner_id了,但是这个结果又让我们实在有点无法接受,太复杂的组合键在写入时会带来一定的性能影响,这样的自然键看起来也很不自然。所以,我们放弃了在节点上使用自增字段,想办法让这些ID变成全局唯一。为此增加了一个专门用来生成ID的数据库,这个库中的表结构都很简单,只有一个自增字段id。当我们要插入新的评论时,我们先在ID库的photo_comments表里插入一条空的记录,以获得一个唯一的评论ID。当然这些逻辑都已经封装在我们的框架里了,对于开发人员是透明的。为什么不用其它方案呢,比如一些支持incr操作的Key-Value数据库。我们还是比较放心把数据放在MySQL里。另外,我们会定期清理ID库的数据,以保证获取新ID的效率。

我这里只有一个小纲要,更多还是看原文吧。

最后介绍一下Yupoo的资料:

作为国内最大的图片服务提供商之一,Yupoo! 的 Alexa 排名大约在 5300 左右。同时收集到的一些数据如下:
带宽:4000M/S (参考)
服务器数量:60 台左右
Web服务器:Lighttpd, Apache, nginx
应用服务器:Tomcat
其他:Python, Java, MogileFS 、ImageMagick 等

关于 Squid 与 Tomcat
Squid 与 Tomcat 似乎在 Web 2.0 站点的架构中较少看到。我首先是对 Squid 有点疑问,对此阿华的解释是”目前暂时还没找到效率比 Squid 高的缓存系统,原来命中率的确很差,后来在 Squid 前又装了层 Lighttpd, 基于 url 做 hash, 同一个图片始终会到同一台 squid 去,所以命中率彻底提高了”
对于应用服务器层的 Tomcat,现在 Yupoo! 技术人员也在逐渐用其他轻量级的东西替代,而 YPWS/YPFS 现在已经用 Python 进行开发了。

名词解释:
YPWS–Yupoo Web Server YPWS 是用 Python开发的一个小型 Web 服务器,提供基本的 Web 服务外,可以增加针对用户、图片、外链网站显示的逻辑判断,可以安装于任何有空闲资源的服务器中,遇到性能瓶颈时方便横向扩展。
YPFS–Yupoo File System 与 YPWS 类似,YPFS 也是基于这个 Web 服务器上开发的图片上传服务器。

【Updated: 有网友留言质疑 Python 的效率,Yupoo 老大刘平阳在 del.icio.us 上写到 “YPWS用Python自己写的,每台机器每秒可以处理294个请求, 现在压力几乎都在10%以下”】

图片处理层
接下来的 Image Process Server 负责处理用户上传的图片。使用的软件包也是 ImageMagick,在上次存储升级的同时,对于锐化的比率也调整过了(我个人感觉,效果的确好了很多)。”Magickd“ 是图像处理的一个远程接口服务,可以安装在任何有空闲 CPU资源的机器上,类似 Memcached的服务方式。
我们知道 Flickr 的缩略图功能原来是用 ImageMagick 软件包的,后来被雅虎收购后出于版权原因而不用了(?);EXIF 与 IPTC Flicke 是用 Perl 抽取的,我是非常建议 Yupoo! 针对 EXIF 做些文章,这也是潜在产生受益的一个重点。
图片存储层
原来 Yupoo! 的存储采用了磁盘阵列柜,基于 NFS 方式的,随着数据量的增大,”Yupoo! 开发部从07年6月份就开始着手研究一套大容量的、能满足 Yupoo! 今后发展需要的、安全可靠的存储系统“,看来 Yupoo! 系统比较有信心,也是满怀期待的,毕竟这要支撑以 TB 计算的海量图片的存储和管理。我们知道,一张图片除了原图外,还有不同尺寸的,这些图片统一存储在 MogileFS 中。
对于其他部分,常见的 Web 2.0 网站必须软件都能看到,如 MySQL、Memcached 、Lighttpd 等。Yupoo! 一方面采用不少相对比较成熟的开源软件,一方面也在自行开发定制适合自己的架构组件。这也是一个 Web 2.0 公司所必需要走的一个途径。

优化网站信息架构

优化网站信息架构

信息架构的定义

根据维基百科的定义,信息架构(Information Architecture, 简称IA)是在信息环境中,影响系统组织、导览、及分类标签的组合结构。它是基于信息架构方法论,并运用计算机技术 管 理和组织信息的一个专门学科。信息架构并非一开始就应用于网站设计,其起源于情报科学,最初应该是用于图书馆等地方的信息组织和信息检索的。

《用户体验的要素——以用户为中心的WEB设计》这本书中对信息架构的定义基于网站设计:信息架构着重于设计组织分类和导航的结构,从而让用户可以 提高效率、有效地浏览网站的内容。

具体的就不再多说的,可能各有各的理解,这里直接来看一个实例——Wordpress的信息架构模式:

a0e0fb463072d00b5ef538198623f077

当然,上面这个图只能展示一个大体的网站信息架构,中间的类目层也许不止一层,会有大类、子类、子子类……底层可以是文章也可能是页面或者一些其他 的具体内容。而网站的内部关系也往往因为全局或局部导航、网站内链和内容关联等功能的存在而复杂的多,图上的箭头也会密集很多,但我们无需罗列所有内容间 的关系,关键是在理清基本的结构。

信息架构的类型

还是参考《用户体验的要素——以用户为中心的WEB设计》中对信息架构的几个分类:

层次结构(Hierarchical Structure)

也叫树形结构,是最常见的网站信息架构模式,上面举例的Wordpress的信息架构就是典型的层次结构。树形结构中箭头的方向不一定是自上而下 的,也可能是自下而上或者是双向的,而内容层之间也会因为一些关联链接的存在而存在同层次间的指向箭头。

矩阵结构(Matrix Structure)

矩阵结构比较注重“维”的概念,即从多维的角度来检索信息,如时间、地域、内容分类等,典型的应用就是内容管理系统(CMS)网站或者电子商务类网 站,比如你浏览豆瓣的电影时可以筛选:2010年—美国—科幻,也许这个时候《钢铁侠2》就呈现在你面前了。

线性结构(Sequential Structure)

看到线性结构也许你马上会想到面包屑,它将网站中最重要的一个信息架构路线展现了出来,即使它无法为你提供你在网站上的平面坐标,但至少它显示了你 现在正处于关键线路的哪个点上;当然,网站的一些关键路径一般也是按照线性结构涉及的,比如用户注册流程或电子商务网站的购买流程等。

网站分析与信息架构

根据网站业务模式的不同,可以选择适合自己网站的信息架构的模式,无论是上面的哪种信息架构模式,只要设计和运用合理,用户便能够在你的网站上以最 方便的形式、最快的速度找到他们需要的信息。

但当我浏览某些网站时,有时真的会让我感觉到“找不到北”,结果就是直接关闭该页面,如果不希望让已经进入了你的网站的用户轻易地离开,网站信息架 构的好坏将直接影响网站的用户体验。所以我们需要通过一些方法来检验网站的信息架构是否满足用户的信息检索的需求。

1.尝试整理出类似上面例子中的网站信息架构图

这个是最简单最直观的方法,如果你的网站信息架构足够清晰,那么画出这样的图对你来说也绝非难事;而当网站的应用比较复杂、内容比较宽泛,那么可能 要整理出网站的整体信息架构就会相对困难,但我相信一个设计优秀的网站只要稍加整理,大体的信息架构图还是画得出来的;而当你绞尽脑汁就是理不清你的网站 的信息架构的头绪的时候,那么说明你的网站需要优化了。

2.通过网站分析的方法验证信息架构的合理性

本文的副标题是“让用户更容易地找到需要的信息”,所以我们需要分析用户是否能够在你的网站上方便快捷地找到他们需要的信息,这里推荐一种方法—— 寻找网站中的迷失用户(Lost Visits)。

在一个合理的信息架构下,大多数的用户是不会在你的网站上迷路的;反之,混乱的信息架构会导致大量的用户迷失方向,就像是进入了一个巨大的迷宫。那 么如何寻找这些迷失用户?我们可以先分析下这类用户的行为,最明显特征的就是:连续点击好几个页面,每个页面都只是初步浏览(因为没有找到他们需要的信 息)就转到另外的页面或直接离开了。所以我们可以借助网站分析中的两个度量:

浏览页面数(Depth of Visit):一次访问中用户总的浏览页面数;

页面平均停留时间(Avg. Time on Page):一次浏览中用户在每个页面的平均停留时间,即该次访 问总停留时间(Time on Site)/该次访问页面数(Depth of Visit)。

我们可以用户细分的方法把那些浏览页面数较多,但页面平均停留时间较短的用户浏览看作是迷失用户,具体的数值可 以根据网站自身的特点进行定义,比如我定义我的博客中浏览页面数大于等于4,而页面平均停留时间小于等于15秒的Visits为迷失用户的浏览行为,我们 可以借助Google Analytics中的高级群组(Advanced Segment)来 区分出这类用户,关于如何使用Google Analytics的高级群组功能,可以参考蓝鲸的文章——Google Analytics功能篇—高级群组,如下图:

07a7a0347dfc199008e48ec904f47ca3

当然,你可能会说这种用户区分的方法不准确,这类用户不一定就是迷失用户,也有可能他们确实找到并浏览了具体内容,但因为内容不够吸引人或者其他原 因而马上离开了该页面。所以这里用高级群组划分出来的这类Visits的数量不能看作是迷失用户的一个绝对数值,我们只能认为里面的大部分Visits都 是迷失用户,而不排除存在某些另类。所以更合理的方法是通过计算这类Visits占网站总Visits的比例情况来分析网站的信息架构到底是否合理,我们 可以在Google Analytics上面选取网站的All Visits和Lost Visits进行比例和趋势的比较,如下图:

7957f0c5378d0dd4b591d1737525f3c5

6565bf8f5f2a447fc9b28e749c29cf39

网站中迷失用户浏览的所占比例只需通过Lost Visits/All Visits就可以计算得到,但这个时候你还是无法根据这个计算结果来评判网站的信息架构到底是好是坏,因为还缺少一个基准线(Benchmark)或 者说是评判标准。在Google Analytics上面的Visitors标签下,提供了“Sites of similar size”的基 准比较(Benchmarking),你可以选择与你的网站相似类型的网站作为基准线进行数据比 较,这的确是个很好的参考,因为通过比较能够更加明确你的网站在同类型网站中的优势和劣势,为网站优化指明方向。GA借助其强大的数据平台可以为我们提供 基准线,但也许对于上面这个例子会显得无能为力,这个时候需要我们理性地自己去选择一个合适的基准线,比如我的博客目前类目和内容都还比较少,那么我可能 会定义我的网站的迷失用户比例应该控制在1%以下;但如果对于一个应用和内容比较复杂的网站,那么基准线显然会需要定得更高一点。一旦某段时间的数据越过 了基准线,就需要关注一下网站的信息架构是不是在趋于混乱了,是不是该进行一下整理和优化了。

总之,一个好的信息架构能够帮助用户更容易地找到他们需要的信息,从而有效地提升网站的用户体验,所以,尝试着去优化下你的网站的信息架构。如果你 有更好的方法能够有效地检验网站的信息架构的优劣,或者能够明确地分析得到网站信息架构的哪些细节上存在缺陷,希望能与我交流,我期待网站分析方法在优化 网站信息架构方面的更多的应用。

原文来自:《优 化网站信息架构》。

不过,如果你看过《胜于言传》这本书,其实就会发现,上面的内容和该书有一点雷同,只是胜一书中讲的更多的是如何改善用户体验,让用户看到更多的东西(指有效内容),如果你没有读过,还真是推荐看一下的。点击进入当当书店选购该书。

该书在当当中可是没有差评的,书的简介也真的很简单:

无论是居家还是办公,只要是在网上,我们通常都想快速地获取和使用信息。我们上网不是为了寻求某些问题的答案,就是为了完成某些任务——搜集信息、只阅读 我们需要的内容。我们都很忙.根本没有时间阅读网站中的太多内容。
本书会帮你为网站用户成功地撰写内容。它为网站内容的创建和修改提供了相应的策略、流程和方法。它有助于你对网站内容进行规划,组织、撰写、设计和测试, 从而吸引用户不断地光顾你的网站。
Ginny Redish大师介绍了如何创建有用、可用的网站内容。Ginny大师曾指导过许多写作人员、信息设计人员和内容负责人员,向他们传授过编写网站的原则和 秘诀。帮助他们创建了易于浏览、易于阅读且易于使用的网站信息。
这本具有实践性和教育性的书籍可以帮助所有创建网站内容的人更出色地完成他们的工作。
本书特色:
·全书用全彩图和来自真实网站的例子 清晰地阐述了内容编写原则。
·实例中带有改进前后的对比效果,写作的风格简明易读。
·包含针对网络版新闻稿、网络版法律声明和网 络版其他文档的具体原则。
·为了让有特殊需求的人们也可以使用网站,介绍了相关的编写技巧。

如果真想把内容当成主打对象,这本书还是值得购买的。

来自PHP研究室的:大型高性能网站的十项规则

来自PHP研究室的:大型高性能网站的十项规则

本文来自PHP5研究室,里面用【】包含的内容是我的个人见解,并非一定就是正确,如果有不同意见,或者忽略,或者请给我点建议。

原文地址是http://www.phpv.net/html/1710.html

在我们公司ChinaNetCloud,见 过多种不同类型的网站和系统,有好也有差。其中有些系统拥有良好的服务器/网络架构,并且进行了合理的调整和监控 ;然而一般的系统都会有安全和性能上的问题,不能良好运行,也无法变得更流行。

在中国,开源的LAMP栈是最流行的网络架构,它使用PHP开发,运行在Apache服务器上,以MySQL作为数据库,所有这些都运行在Linux上。它是个可靠的平台,运行良好,是现在全球最流行的Internet系统架构。然而,我们很难对其规模进行正确的扩展并保持安全性,因为每个应用层都有其自身的问题、缺陷和最佳实践。我们的工作就是帮助企业用最低的操作成本来创建并运行高性能的、可伸缩的、安全的系统,因此对于这类问题我们有很丰富的经验。

当前的实际情况是,很多网站都是由开发人员快速而廉价地创建【说实话还真没有办法,上面催下面逼,还能怎么做?】,通常没有任何IT人员或者经理,只是由程序员来管理系统。造成的结果是,虽然花费很低的成本网站就可以开始运行,但是当拥有大量用户、需要扩展规模的时候,通常就会面临真正的问题。毕竟,中国拥有三亿八千万的Internet用户,如果其中的0.01%访问这个站点,就很容易引发25 万~50万的页面访问量。这些问题在各个级别上都会产生,下面总结的规则是对最一般的问题进行概述,并且说明为什么这些规则如此重要,以及最好采用什么方法来修正它们。遵循这些建议的站点会提高它的可伸缩性、安全性以及操作上的稳定性。

1、使用合适的会话管理

第一个想到的扩展系统的方法就是添加更多硬件。例如,使用两台服务器而不是一台。这听着合理,但会产生潜在问题:会话管理。这对Java程序来说是很严重的问题,在PHP中也会产生可延展性问题, 对于数据库的负载尤其如此。

会话被定义为单独的最终用户登录或者连接一段时间,其中通常会包含多个TCP/IP的HTTP连接、几个Web页面,通常还包括几十个甚至上百个页面元素,如框架、菜单、Ajax更新等。所有这些 HTTP请求都需要知道用户是谁,才能满足安全的要求,并向用户传送适当的内容,因为这些都是会话的组成部分。通常每个会话都会包括相互关联的会话数据,如用户名、用户ID、历史、购物车、统计资料等等信息。

问题在于,在有两台Web服务器和多个HTTP连接的情况下,用户流量会在两台服务器之间分配和移动,服务器很难知道用户是谁,并对所有数据进行跟踪,因为每个页面或者页面的组成部分都可能来自不同的服务器。在PHP中,通常是这样解决的,在第一次连接或登录的时候就创建一个会话ID并将其放在Cookie中,然后这个Cookie会和每个 HTTP请求一起发送。

这样做带来一个问题,接下来每段PHP脚本都需要基于ID来查找会话数据。由于PHP无法在执行过程之间保持状态(这与Java不同),这个会话数据需要存储在某个地方,通常是在数据库中。但是,如果复杂的页面需要在每个页面载入过程中对其进行十次查找(这是经常要做的),那就意味着每个页面都要执行10次SQL查询,这会导致数据库上很大的负载。

在前面所举的中国 Internet用户 0.01%的例子中,可能很容易在每秒内仅仅为了管理会话就生成上百个查询。解决方法是一直使用位于Cookie中的会话ID,并且使用像 Memcached之类的服务来缓存会话数据以获得高性能。

还要注意其中存在安全性的问题,因为黑客可以伪造另一个用户的会话ID,这是很容易找到或看到的,特别是在公用的Wi-Fi中。解决方法是对会话ID进行恰当的加密或者签名,并将其与时间区间、 IP地址以及其他关键信息 像浏览器或者其他细节相绑定。在Internet上有很多不错的关于良好的会话管理的例子,你可以根据需要找到最适合的。

2、总是要考虑安全性
尽管编写像防止SQL注入和登录安全之类的代码涉及很多安全问题,但不幸的是,几乎没有人考虑过安全性,而那些考虑到的人也没有对其进行很好地理解。而本文要关注的是操作性的系统安全。对于这类安全,我们的焦点集中在三个安全领域:防火墙、运行的用户以及文件访问权限。

除了配置专门的硬件防火墙(像Cisco的ASA)之外,所有服务器都还应该运行像Iptables之类的防火墙,它会保护服务器免受其他威胁和攻击。这些威胁和攻击可能来自公共的 Internet、其他服务器或本地服务器,也包括使用VPN或者SSH通道的开发和操作人员。我们仅对指定的IP开放确实需要的端口。Iptables 可能会很复杂,但是有很多不错的模板,我们通常可以使用它们来帮助客户创建Iptables。例如,默认的RedHat或者CentOS防火墙的配置说明只有10行,显然并不实用。我们最佳实践的Iptables配置大概有5页,这其中包含了Linux所能提供的最高级的安全防范。

所有公用的服务,都应该运行在专门的用户下,如Apache。切记永远都不要使用Root用户运行,因为这会让任何闯入到Apache的用户接管整个服务器。如果Apache只是运行在 Apache用户下或者运行在Nobody下,那么闯入Apache就不是一件容易的事情了。

Web服务器运行或者服务的文件(像.php和.html文件)对于Web服务器的用户应该是不可写的。这意味着Apache或者Nginx用户不应该拥有Web目录的写权限。有很多方法都可以做到这一点,而最简单的就是将这些文件为其他用户所有,然后让Apache/Nginx等用户归属于能够使用640权限读取文件的组中。这会防范几乎所有的黑客和针对页面的攻击。

此外,永远不要使用Ftp来上传文件,特别是在公用的Wi-Fi环境中,因为在其中黑客很容易盗取用户名和密码。取而代之的是使用Sftp会更加安全。另外,每个雇员都应该拥有自己的用户ID和随机密码。【其实并非是所谓的SFTP安全,我倒是认为,多开通一个功能,相应的就会多一个漏洞】

3、使用标准的路径和安装配置

一个令人讨厌的部署问题是,开发者很少考虑他们的软件会被部署到生产Web服务器的什么位置,以及如何部署。我们看到过许多大型的系统将它们的PHP代码部署在/home/xiaofeng或者 /web/code路径下。事实上,这两个路径都是非常不标准的,并且会带来操作和安全性的问题。当这些系统从开发环境转移到测试环境再到生产环境中时,因为每个安装配置都是非标准的,所以经常会出现问题,这时就需要开发者调整才能够正常工作。

你应该总是使用标准的安装包和二进制文件来 安装像Apache之类的服务器。不要从源代码编译或者安装Tarball,因为这会导致长期稳定性和管理上的问题,另外在服务器上安装多个不同的版本也 会造成混淆。

Web站点应该总是在指定的平台和 Linux发布的标准路径下进行测试和部署,像RedHat 或者CentOS下的/var/www/html路径。这有助于对系统进行有效的权限管理、备份、配置、监控以及其他操作。

Web 服务器的日志应该存放在/var/logs或者/var/logs/app_name下,而不应该位于主代码区域。这样做的原因不仅仅是因为这些标准的路径很重要,更应该关注的是,恰当地配置服务器会将/var配置为分离的文件系统。如果应用程序突然写入了大量日志并占用所有磁盘空间,由于我们做了以上的配置就不会导致系统崩溃,或者其他严重的问题。如果日志位于其他位置,就可能会产生问题。【分区真的很重要,不管是因为网站还是因为日志,单独的分区真的很有用,哪怕是重装系统还不会影响这个分区】

4、总是使用日志

在Web系统中做多少日志都不为过。所有系统都应该将重要的数据写入到日志中,不管是它们自己的日志还是系统的Syslog。Cron的Job以及其他Shell脚本或者C语言的程序,对日志都有相应标准以及简单的函数。在Shell脚本中,只需要使用 Logger命令就可以实现日志的写入。在脚本启动/停止、重要的脚本执行以及实时数据产生的情况下都要执行写入日志操作。这样出现问题的时候,查看主要的系统日志就可以很容易地看到发生了什么。

大型系统经常会使用专门的工具如 Local5来记录日志,并配置Syslog或者Syslog-ng来将其存放在单独的文件中,这样会更容易使用。需要注意的是,Syslog工具和 Logger(以及任何Syslog调用)默认优先使用user.notice,如有必要,你可以对其进行调整。

一个好的系统会对程序进行配置,用来打开或者关闭日志,并可以选择在每模块或者功能的级别上应用不同级别的日志。这使得我们可以记录非常详细和强大的日志,用来分析和调试在生产操作中所发生的问题。【日志这玩意让人爱让人恨,爱是因为他可以让我们查出很多潜在问题,恨是因为,访问量过大的网站LOG几天就可以把磁盘撑满】

highlightsearchkeywords.rar
大型高性能网站的十项规则


5、使用良好的数据库设计和SQL

在任何系统中,数据库通常是最大的性能瓶颈。而影响数据库性能的最大两个问题是数据库设计和SQL代码质量。很多系统都拥有良好的或者至少是可用的数据库设计,但由于没有经过适当的性能测试,SQL代码质量通常都会很差。这样的SQL代码在开发环境中可能运行很快,因为其中只有小数据集和最小的负载。但是当成千上万的用户同时读取数据库中上百万条记录的时候,它就很可能会崩溃。

不幸的是,这些问题一开始并不明显,直到系统增大、突然开始崩溃的时候才会显现出来。在增大的过程中,数据库系统看起来运行得很快(因为数据都位于内存中,而且很少有并发的查询),并且对用户的响应也很快,但实际上它的内部运行效率很低。这并不重要,我们关注的是在系统增大并遇到性能问题之前找到这些问题并加以解决。

关于这个问题有很多不错的书和站点进行了解析,其中的关键工具包括慢查询日志、INNODB状态系统,以及描述当前性能的MySQL统计信息。我们见到过很多系统每秒会读取500,000条数据,这是出现SQL问题的明显预兆,但公司往往对其一无所知直到服务器开始崩溃。

MySQL系统应该对所有数据使用 INNODB存储引擎,因为INNODB与之前的MyISAM相比,运行得更快、更稳定,并且管理性能和备份工作也更加容易和快捷。在主配置文件中,INNODB应该被设置为默认的数据库引擎,并且系统应该不时地进行检查,看是否意外创建了MyISAM的表。【这点好象和很多人的想法是相反的吧?很多人都认为应该是创建MYISAM表,而不是INNODB,妖了。。。】

6、总要拥有良好的DB配置和备份

很多公司都没有良好的备份机制,也不知道如何恰当地完成这项工作。MySQL的Dump是不够的,因为最好的备份方法是使用LVM快照和INNODB对系统进行热备份,从而得到超快的速度和超高的可靠性。

另外,在将所有备份文件从服务器上转移出来之前要进行压缩和加密。另外还要确保拥有设计合理的MySQL配置。MySQL默认安装使用说明中只有5~10行关于配置的说明,这根本不适合开发使用。而我们提供给客户的最佳实践文档足足有10页那么长。文档中大约有100种有用的关于安全、性能和稳定性问题的设定,包括防止数据败坏,其中很多设定都是非常重要的。【很验难配,真的,想配置的好真的很难】

7、使用读/写数据库分离

随着系统变得越来越庞大,特别是当它们拥有很差的SQL时,一台数据库服务器通常不足以处理负载。但是多个数据库意味着重复,除非你对数据进行了分离。更一般地,这意味着建立主/从副本系统,其中程序会对主库编写所有的Update、Insert和Delete变更语句,而所有Select的数据都读取自从数据库(或者多个从数据库)。

尽管概念上很简单,但是想要合理、精确地实现并不容易,这可能需要大量的代码工作。因此,即便在开始时使用同一台数据库服务器,也要尽早计划在PHP中使用分离的DB连接来进行读写操作。如果正确地完成该项工作,那么系统就可以扩展到2台、3台甚至12台服务器,并具备高可用性和稳定性。【我不知道这篇文章是几年前的,我相信,目前所谓的读写分离好象用的不多了,更多的会采用前置处理,然后由数据库自动分发,以及采用更好的缓存功能。读写其实并不能增强多少性能。当然如果是电子商务网站,或许可以。但对于PHP来说,真的没多大意义 ,因为PHP没有连接池功能,读和写发生交互的时候,相当于连接了两个数据库,还不能互相同时使用】

8、使用类似Memcached之类的数据库缓存


即便有了好的数据库设计、SQL和读写分离,大型的系统仍然需要更快的性能,特别是对会话状态、好友列表以及BBS文字之类的东西。为了达到这个目的,我们可以使用像MemCached之类的数据缓存,它是一个高性能的简单数据缓存,已经被所有最大型的站点使用。但是要小心的是,不要100%依赖于一台Memcache服务器来提高性能,因为如果那台服务器崩溃了,就会破坏整个系统的性能。在这种情况下,应该使用2~3台Memcache服务器形成簇集架构,并且有选择地包含一个缓存准备过程,如果缓存服务器重启,需要重新载入数据,它能够快速地载入缓存。【推荐】

9、构建测试和开发环境

很多公司只有开发者的桌面系统和他们的生产服务器。当系统变得越来越大、越来越复杂时,测试和管理代码就会导致严重的问题。最佳的实践是拥有两个测试系统,一个用于开发者的代码和功能的整合测试,另一个要与生产环境完全一致,从而更容易向生产环境平滑地过渡。幸运的是,现在使用云计算(或者私有云)可以轻松达到这一点。一个5~10台服务器的生产环境,可以很容易地在办公室或者IDC中使用一台服务器来复制,从而用于测试,而这台服务器我们可以用于多个客户的项目。【正如文章开头所说的,哪有空来做这事啊。。。】

10、使用版本控制

最后,要对一切使用版本控制,包括测试和生产环境的部署。很多开发者都使用SVN或者类似的方法。在理想状态下,这些方法可以被用于所有代码、脚本、HTML、图片、配置、文档和测试。版本控制应该是代码转移到测试环境的必经之路,而不是简单地复制或者使用tar文件,因为这二者都是不可靠的。开发者应该将所有一切都签入,打上标签,然后将它们签出到测试系统。如果所有都没问题,那么它们会将该版本签出到生产环境。【多人开发的时候非常有必要。从最初CVS到SVN到现在的GIT,经历了很多了,好象linus推荐是采用GIT,好象是可以直接在本地就可以创建版本库】

总 结:
不管是在开发还是在运营过程中,创建可靠的 高性能Web系统都有很多应该注意的事项。本文试图从可操作性和可靠性的角度讨论最重要的几点。当你构建和管理站点的时候,请不要忘了这些重要的问题。遵 循这些规则会有助于确保系统长久、良好地运行。

作者简介:
Steve Mushero,ChinaNetCloud 公司联合创始人、CEO兼CTO,拥有全球20多年的技术管理经验。曾担任土豆网、Intermind和 Advanced Management Systems等多家企业CTO

译者简介:
侯伯薇,生于凤城,学在春城,做过国内和对 日项目,现在大连某保险公司工作。乐于钻研技术,同时注重业务知识,勤于思考,愿意与人交流和分享。

有点意思:QQ 我的好友想到的信息架构

有点意思:QQ 我的好友想到的信息架构

这篇文章有点意思,不过我更多的想的不是他所说的这种分类,一般来说,在电子商务里面这方面,这方面其实是最难界定的。产品A既可能属于B分类,也可能是属于C分类。但是在促销的时候,B分类产品不打折,C分类可以打折,这时你把A产品怎么处理?打折还是不打折?

QQ好友列表:

+太原(9/39)
+运城老乡(9/49)
+西安(9)
+学校(19)

问题:
QQ
好友上新建了一个女孩组和一个西安组,上面的整理方式,发现经常 弄错,比如“XX“同学,是我女友介绍认识的,我将她顺便放在太原组里面,后来知道她不在太原,山西运城人士,当我和她聊天时候,连我自己都很吃惊经常 问,太原的一些情况,很是影响人家心情,搞的自己也很尴尬。
很长一段时间,渐渐习惯这种分类,突然间觉得这样的分类很不科 学,很明显,这涉及SNS的经典问题,以及信息架构的经典问题:如何做一个有效分类?

我的需求:
1. 新添加一个朋友的时候固定存放
2.
常联系的人立马可以找到
3.
和我趣味相投的统统放在一起,玩到一起的,闲来没事可以出去一起 疯狂的
4.
能够表达出我的职业规划,定位明确,可以清楚的阐述我的社会活动 能力与人际关系

详细说明:

要做到:
1. 清楚地表现好友信息:一看这个分类,就知道这一类型的人是干什么 的,和他们应该在那些方面可以顺利沟通清楚问题。
2.
层次结构清晰:一看这个分类,就知道什么人在这个分类下面,分类 下面涉及到什么朋友

不应该是:
1. 这个分类给人一种距离感,陌生
2.
我想找的是分类A, 但你却出现在分类B中?NND
3.
这个分类做出来不能让我自己都犯晕!

问题的表象是如何找到一个合理的好友分类方式,深入问题的本 质,其实是不满足我的需求,而QQ体现的核心是我的二字,因此人际关系、社会活动能力、我的职业规 划就是该信息架构问题的关键!这样就有了看似简单但能立刻解决问题的分类方式:

QQ好友列表:

6e6225c2da047e6a66a1f1a24766e0af

+熟人(9/19)
+一家人(9/19)
+一帮子(9/14)
+光屁股长大(9/100)
+
刚认识(2/10)
+xxx
公司
+xxx
公司

一切就这么简单,采用这个分类以后,立 即心旷神怡!

--EOF--

原文来自:http://www.cnblogs.com/u_xiaomo/archive/2010/04/18/1714953.html

不过话说回来,抛开电子商务的因素,wordpress的分类设计的就是挺不错的。一篇文章在你迷惘的时候,可以放到多个分类里,分类又只是相当于一个标签。这样的设计让使用者也很爽。只是开发的时候累一点,SQL的性能差一点点而己。

SEO与网站架构

SEO和网站架构或许真的搭不上边,但是否真的如此呢?由此引发了我的一些猜测
很多网站目前都采用了类静态文件(rewrite),使得路径都很长,而且每一层都是由拼音或者相应的英文来组成。

对于PHP的CMS来说,dede CMS是目前这样应用最明显的,他在生成静态的时候,默认就是按分类名称自动创建英文目录的。而相应的,dedeCMS的收录也相对会较其他 CMS明显。(这里我们不谈内容,如果谈内容,早期的BBS程序在回复的时候,都主动加上标题RE:xxxx,如果回复100条,那就是10页每页的title都会显示10遍,这样的关键词堆积,怎么不让收录上升?)

其实,仔细看使用量最高的wordpress吧。看后台对于固定链接的设定,都是偏向于日期结构和archive等。这样也是有相当的结构设定。再加上wordpress的文章也支持自定义标题,所以,wordpress几乎都是以全静态的方式在出现。(这一段没写好,不知道如何表达它的结构。)

PHP的CMS如果只谈DEDE,那么对于其他的就不太公司平了,从最早的iwps到现在phpcms等,中间有集成版的php168,还有那夫妻店phome的ecms,当然也还得提一下被disucz收购的supesite。这些程序都是经历了多版,帝国是唯一纯自己写的代码,supesite在被收购后也变味了,Discuz的味道很浓,phpcms呢,大量核心代码都是仿照了discuz,由此可见DZ影响了多少人。在这里面帝国的目录结构最乱,但是生成静态后也还是比较好的。

为什么把中文分类生成拼音目录(rewrite也这样操作了)?其实有历史原因也有现在的发展趋势。最早的时候,很多人不知道如何根据中文分类名称来设定相应的英文分类,后面就改用拼音了。现在的趋势呢是因为搜索引擎已经能够自动把中文翻译成拼音进行搜索,也会根据相应的拼音进行模拟搜索,甚至把拼音模糊成中文进行搜索,由此可见,拼音型的目录结构相当于又给搜索引擎一次收录的机会。【这些都是我的猜测】

上面讲的都是从生成静态,或者rewrite的方面来谈的所谓系统架构,其实这样当然是不对的。SEO除了这些静态、伪静态的目录结构外,还有一些真正的所谓的系统架构,当然这要留到后面去讲,因为我还没有彻底想好。

带你深入了解Web站点数据库的分布存储【转帖】

带你深入了解Web站点数据库的分布存储【转帖】

我是从SA Notes转载的,因此,虽然本文属于他转载的内容,但我仍然感谢 Sa Notes的转载,否则我也看不到此内容。

原文如下:

转自:http://database.csdn.net/page/b12503e6-9f14-4cc1-90dd-88632444a46e

在Web 2.0时代,网站将会经常面临着快速增加的访问量,但是我们的应用如何满足用户的访问需求,而且基本上我们看到的情况都是性能瓶颈都是在数据库上,这个不 怪数据库,毕竟要满足很大访问量确实对于任何一款数据库都是很大的压力,不论是商业数据库Oracle、MS sql Server、DB2之类,还是开源的MySQL、PostgreSQL,都是很大的挑战,解决的方法很简单,就是把数据分散在不同的数据库上(可以是硬 件上的,也可以是逻辑上的),本文就是主要讨论如何数据库分散存储的的问题。

目前主要分布存储的方式都是按照一定的方式进行切分,主要是垂直切分(纵向)和水平切分(横向)两种方式,当然,也有两种结合的方式,达到更贴切的切分粒度。

1. 垂直切分(纵向)数据是数据库切分按照网站业务、产品进行切分,比如用户数据、博客文章数据、照片数据、标签数据、群组数据等等每个业务一个独立的数据库或者数据库服务器。

2. 水平切分(横向)数据是把所有数据当作一个大产品,但是把所有的平面数据按照某些Key(比如用户名)分散在不同数据库或者数据库服务器上,分散对数据访问的压力,这种方式也是本文主要要探讨的。

本文主要针对的的 MySQL/PostgreSQL 类的开源数据库,同时平台是在 linux/FreeBSD,使用 php/Perl/Ruby/Python 等脚本语言,搭配 Apache/Lighttpd 等Web服务器 的平台下面的Web应用,不讨论静态文件的存储,比如视频、图片、CSS、JS,那是另外一个话题。

说明:下面将会反复提到的一个名次“节点”(Node),指的是一个数据库节点,可能是物理的一台数据库服务器,也可能是一个数据库,一般情况是指一台数据库服务器,并且是具有 Master/Slave 结构的数据库服务器,我们查看一下图片,了解这样节点的架构:

一、基于散列的分布方式

1. 散列方式介绍

基于散列(Hash)的分布存储方式,主要是依赖主要Key和散列算法,比如以用户为主的应用主要的角色就是用户,那么做Key的就可以是用户ID 或者是用 户名、邮件地址之类(该值必须在站点中随处传递),使用这个唯一值作为Key,通过对这个Key进行散列算法,把不同的用户数据分散在不同的数据库节点 (Node)上。

我们通过简单的实例来描述这个问题:比如有一个应用,Key是用户ID,拥有10个数据库节点,最简单的散列算法是我们 用户ID数模以我们所有节点数,余数就是对应的节点机器,算法:所在节点 = 用户ID % 总节点数,那么,用户ID为125的用户所在节点:125 % 10 = 5,那么应该在名字为5的节点上。同样的,可以构造更为强大合理的Hash算法来更均匀的分配用户到不同的节点上。

2. 散列分布存储方式的扩容

我们知道既然定义了一个散列算法,那么这些Key就会按部就班的分散到指定节点上,但是如果目前的所有节点不够满足要求怎么办?这就存在一个扩容的问题,扩容首当其冲的就是要修改散列算法,同时数据也要根据散列算法进修迁移或者修改。

(1) 迁移方式扩容:修 改散列算法以后,比如之前是10个节点,现在增加到20个节点,那么Hash算法就是[模20],相应的存在一个以前的节点被分配的数据会比较多,但是新 加入的节点数据少的不平衡的状态,那么可以考虑使用把以前数据中的数据按照Key使用新的Hash算法进行运算出新节点,把数据迁移到新节点,缺点但是这 个成本相应比较大,不稳定性增加;好处是数据比较均匀,并且能够充分利用新旧节点。

(2) 充分利用新节点:增 加新节点以后,Hash算法把新加入的数据全部Hash到新节点上,不再往旧节点上分配数据,这样不存在迁移数据的成本。优点是只需要修改Hash算法, 无须迁移数据就能够简单的增加节点,但是在查询数据的时候,必须使用考虑到旧Key使用旧Hash算法,新增加的Key使用新的Hash算法,不然无法查 找到数据所在节点。缺点很明显,一个是Hash算法复杂度增加,如果频繁的增加新节点,算法将非常复杂,无法维护,另外一个方面是旧节点无法充分利用资源 了,因为旧节点只是单纯的保留旧Key数据,当然了,这个也有合适的解决方案。

总结来说,散列方式分布数据,要新增节点比较困难和繁琐,但是也有很多适合的场合,特别适合能够预计到未来数据量大小的应用,但是普遍 Web2.0 网站都无法预计到数据量。

二、基于全局节点分配方式

1. 全局节点分配方式介绍

就是把所有Key信息与数据库节点之间的映射关系记录下来,保存到全局表中,当需要访问某个节点的时候,首先去全局表中查找,找到以后再定位到相应节点。全局表的存储方式一般两种:

(1) 采用节点数据库本身(MySQL/PostgreSQL)存储节点信息,能够远程访问,为了保证性能,同时配合使用 Heap(MEMORY) 内存表,或者是使用 Memcached 缓存方式来缓存,加速节点查找

(2) 采用 BDB(BerkeleyDB)、DBM/GDBM/NDBM 这类本地文件数据库,基于 key=>value 哈希数据库,查找性能比较高,同时结合 APC、Memcached 之类的缓存加速。

第 一种存储方式是容易查询(包括远程查询),缺点是性能不太好(这个是所有关系型数据库的通病);第二种方式的有点是本地查询速度很快(特别是hash型数 据库,时间复杂度是O(1),比较快),缺点是无法远程使用,并且无法在多台机器中间同步共享数据,存在数据一致的情况。

我们来描述实施 大概结构:假如我们有10个数据库节点,一个全局数据库用于存储Key到节点的映射信息,假设全局数据库有一个表叫做 AllNode ,包含两个字段,Key 和 NodeID,假设我们继续按照上面的案例,用户ID是Key,并且有一个用户ID为125的用户,它对应的节点,我们查询表获得:

Key NodeID
13 2
148 5
22 9
125 6

可以确认这个用户ID为125的用户,所在的节点是6,那么就可以迅速定位到该节点,进行数据的处理。

我们来查看一下分布存储结构图:

2. 全局节点分布方式的扩容

全局节点分配方式同样存在扩容的问题,不过它早就考虑到这个问题,并且这么设计就是为了便于扩容,主要的扩容方式是两种:

(1) 通过节点自然增加来分配Key到节点的映射扩容

这 种是最典型、最简单、最节约机器资源的扩容方式,大致就是按照每个节点分配指定的数据量,比如一个节点存储10万用户数据,第一个节点存储0-10w用户 数据,第二个节点存储10w-20w用户数据,第三个节点存储20w-30w用户信息,依此类推,用户增加到一定数据量就增加节点服务器,同时把Key分 配到新增加的节点上,映射关系记录到全局表中,这样可以无限的增加节点。存在的问题是,如果早期的节点用户访问频率比较低,而后期增加的节点用户访问频率 比较高,则存在节点服务器负载不均衡的现象,这个也是可以想方案解决的。

(2) 通过概率算法来映射Key到节点的的扩容

这种方式是在既然有的节点基础上,给每个节点设定一个被分配到Key的概率,然后分配Key的时候,按照每个节点被指定的概率进行分配,如果每个节点平均的数据容量超过了指定的百分比,比如50%,那么这时候就考虑增加新节点,那么新节点增加Key的概率要大于旧节点。

一般情况下,对于节点的被分配的概率也是记录在数据库中的,比如我们把所有的概率为100,共有10个节点,那么设定每个节点被分配的数据的概率为10,我们查看数据表结构:

NodeID Weight
1 10
2 10
3 10

现在新加入了一个 节点,新加入的节点,被分配Key的几率要大于旧节点,那么就必须对这个新加入的节点进行概率计算,计算公式:10х+у=100, у>х,得出:у{10...90},х{1...9},x是单个旧节点的概率,旧节点的每个节点的概率是一样的,y是新节点的概率,按照这个计算 公式,推算出新节点y的概率的范围,具体按照具体不同应用的概率公式进行计算。

三、存在的问题

现在我们来分析和解决一下我们上面两种分布存储方式的存在的问题,便于在实际考虑架构的时候能够避免或者是融合一些问题和缺点。

1. 散列和全局分配方式都存在问题

(1) 散列方式扩容不是很方便,必须修改散列算法,同时可能还需要对数据进行迁移,它的优点是从Key定位一个节点非常快,O(1)的时间复杂度,而且基本不需要查询数据库,节约响应时间。

(2) 全局分配方式存在的问题最明显的是单点故障,全局数据库down掉将影响所有应用。另外一个问题是查询量大,对每个Key节点的操作都必须经过全局数据库,压力很大,优点是扩容方便,增加节点简单。

2. 分布存储带来的搜索和统计问题

(1) 一般搜索或统计都是对所有数据进行处理,但因为拆分以后,数据分散在不同节点机器上,无法进行全局查找和统计。解决方案一是对主要的基础数据存储在全局表中,便于查找和统计,但这类数据不宜太多,部分核心数据。

(2) 采用站内搜索引擎来索引和记录全部数据,比如采用 Lucene 等开源索引系统进行所有数据的索引,便于搜索。 对于统计操作可以采用后台非实时统计,可采用遍历所有节点的方式,但效率低下。

3. 性能优化问题

(1) 散列算法,节点概率和分配等为了提高性能都可以使用编译语言开发,做成lib或者是所有php扩展形式。

(2) 对于采用 MySQL 的情况,可以采用自定义的数据库连接池,采用 Apache Module 形式加载,能够自由定制的采用各种连接方式。

(3) 对于全局数据或都频繁访问的数据,可以采用APC、Memcache、DBM、BDB、共享内存、文件系统等各种方式进行缓存,减少数据库的访问压力。

(4) 采用数据本身的强大处理机制,比如 MySQL5 的表分区或者是 MySQL5 的Cluster 。另外建议在实际架构中采用InnoDB表引擎作为主要存储引擎,MyISAM作为一些日志、统计数据等场合,不论在安全、可靠性、速度都有保障。

仍是架构:关于呼叫中心业务系统构架方面的设想

仍是架构:关于呼叫中心业务系统构架方面的设想

我也来个前言,架构这东西,研究的人越多,我能够做参考的也就越多,哇哈哈哈。不多说,贴copy来的文章,原文见博客园:http://www.cnblogs.com/micronet-lukey/archive/2009/04/14/1435520.html。

当然这个架构和我们传统意义上的WEB架构不太一样,但我想说的是这些问题还是可以作为一定的参考。比如我们在开发的时候,是直接上SVN还是采用传统的目录共享式开发。现在SVN已经成为很多项目开发所必备工具了,但如果我们在部署的时候采用SVN进行分发代码呢?审核关如何过?

程序员->发送到SVN服务器->SVN分发到测试组->测试组分发到正式机

这是一种解决方法,其实也有点象下文的图片。但实际操作中,当然不太会这样操作。不过也差不多是类似的方法。

让我注意的其实是文章的最后一句话。。。

前言:

目前,公司的呼叫中心程序已经在中国的很多城市运行着。由于受到技术和网络环境的限制,这些呼叫中心程序安装实施完毕后,我们都是采取客户先反映问题,然后我们再安排人员时间进行维护。这种被动的维护机制带了很多问题。

目前存在的问题:

一:客户在描述问题的时候,并不能深入到系统的内部,往往只是描述了一个系统报错的现象。由于公司里已经没有当时的运行环境,在公司内很难做到故障重现,也就很难定位到故障的原因。系统维护和bug修补难度很大。

二:呼叫中心的程序日志都是分散存放的。哪台计算机中的程序报错,就到那台电脑中找出错日志。这个过程必须人工干预。有时候,有些报错内容非常致命,但由于公司不能及时获取到这些信息,导致很多问题就像一颗定时炸弹一样无法及时排除。

三:当公司更新了一个版本后,如果不能到现场维护,只能通过远程或者让客户代劳替换新程序。这种更新机制一旦遇到网络中断,或者客户不配合,将给维护工作带来很大障碍。如果由于需求变更较多,需要经常更新版本, 那么面临的问题将很难解决。

解决的措施:

就第一和第二个问题,可以通过改进目前的日志记录方式来解决。通讯服务器接收客户端程序的错误日志。并且把这些日志内容打包成E_Mail邮件,定时发送到公司指定的邮箱中。

就第三个问题,可以通过自动更新服务来解决。维护人员把最新的软件更新包上传到客户端的通讯服务器中。客户端程序监测到有最新的软件更新包,可以自动更新。

5f84572c0872c2608b4e6724b8b32ec6

解决问题的核心就是在客户那安装一台通讯服务器。这台通讯服务器既要能能够连接到Internet,同时还要和内部的服务器向连接。这台通讯服务器有两个作用:

1:发送各个程序的错误日志到公司的邮件。

2:接收公司上传的程序更新包,并自动通知各个客户端程序更新。

所有的工作都由服务器自动完成。

总结:

任 何一个系统,在现场部署完成,用户正式开始使用后,对于我们开发组来说,那只是万里长征走完了第一步,后期不断地查错,改进,更新,替换也会占用到大量的 人力物力,如果是外省的客户,跑一趟现场还会占用大量的财力。按照现在的技术能力和网络环境,我们完全可以通过技术手段,更高效地对各个系统进行维护。

维护的最高境界是:客户还没有发现问题,我们已经捕捉到bug并在后台悄悄地把程序更新了。

还是架构:再谈 eBay 的扩展性最佳实践

最近,好象谈架构比较多了,所以,我也就跟着copy,paste了一把。。原文来自DBA notes,网址为:http://www.dbanotes.net/arch/best_practices_for_scaling_websites_lessons_from_ebay.html,作者:feng。

内容如下:

很多人都觉得 eBay 在 QCon (北京) 上的技术讲座不错,但对我来说,其实冲击力没那么大了。eBay 一两年前就是这个 PPT 。不过还是比 Amazon 的 Jeff Barr 强了很多,以后要是开个什么会,你把 Jeff Barr 请来还讲那个销售文档,估计自己都不好意思。

不过,eBay 这次的PPT 总算还是有点更新的。

1)数据分片(Partition Everything)

说是分区(Partition),这里不能简单等同于 Oracle 的分区,理解成分片(Sharding)就好啦。可以参考一下我以前写的科普小文:开源数据库 Sharding 技术 (Share Nothing)。这里要强调一下的是,分片是在数据量的确有规模的时候才适合进行,如果单节点足以应付,那么还是不要冒进。

从分片的模式上,eBay 主要根据功能切分(Functional Segmentation)和水平分割(负载均衡考虑),作为推论,所有会话都是无状态性的。

2)异步处理(Asynchrony Everywhere)

其实对于任何网站来说,过度追求"同步"化设计还是比较糟糕的做法。以用户能观察到的数据为视角进行设计,中间可以最大限度用异步来完成。

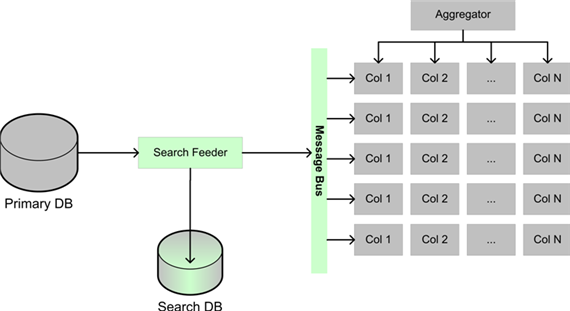
eBay 的举例的模式有两个,一个是事件队列(Event Queue),另一个是信息分发(Message Multicast)。前者基本上是个生产者--消费者的模型。后者主要用在搜索的架构上。

eBay_message_multicast.png

(膘叔:不知道怎么回事,我下载总是只显示一半看来是我的RP不好?)

注意到图中的消息总线,这才是 eBay 整个架构中的动脉,估计轻易不会批露技术细节

3)自动化(Automate Everything)

这里的自动化举了两个例子,一个是针对运维方面的,另外举了关于机器学习的东西,这是演讲者 Randy Shoup 的强项所在。

eBay 的自动化,在一年前的另一篇文章里可以窥测一点东西。只是这篇文章当初没有被更多人重视,参见:eclipse at eBay。可以看到 eBay 能在自动化方面做得这么好(起码敢出来讲)不是一朝一夕之功。

4)故障检测与回溯(Remember Everything Fails)

更好的失败检测机制: 监控每天超过 2TB 的日志,根据日志中的相关事件得出判断或者预警。这个看起来简单,但实现起来还是需要一点技巧和策略的,重要的是,需要不断根据结果的反馈去改进。

完美回滚: 任何服务都通过服务配置中的标记来识别,无痛回滚。(个人感觉这个非常有难度,尤其是升级的时候)

优雅降级(Graceful Degradation):能够相对容易的对应用标记"Marks down(下线)"

5)拥抱不一致性(Embrace Inconsistency)

举了 CAP 原则,程立将其形象描述为帽子戏法,非常准确。说起一致性,自从 Amazon CTO Werner Vogels的 Eventually Consistent 一出,基本上不需要我废话了,这就是事务处理的九阴真经,大家回家慢慢参详好了。

eBay 也有自己的绝对准则: 绝对没有分布式事务(两阶段提交), 通过状态机与操作顺序最小化不一致性,通过异步事件(消息总线?)达到最终一致性。

--EOF--

另外小道消息:Amazon CTO Werner Vogels 可能会参加六月份在杭州举办的侠客行大会。

以前的老帖子:eBay 的Scalability最佳实践


对了,如果想直接看讲了什么内容,请看

InfoQ中文站相关内容:

  1. 可伸缩性最佳实践:来自eBay的经验
  2. eBay的表示层架构与Eclipse
  3. 牺牲一致性来换取分布式架构的可伸缩性
  4. ActionScript类库推动mash-up Web2.0平台
  5. 从业务角度论证如何采用REST风格架构
  6. Engine Yard要接管Ruby 1.8.6的维护?
  7. 可伸缩性原则
  8. 透过digg.com和Reddit了解mashup应用
  9. 使用WCF消费REST服务
  10. eBay技术特别专题


FriendFeed实现基于MySQL的无模式存储

FriendFeed实现基于MySQL的无模式存储

架构这个东西,不能一味的盲目抄袭,因为每种新架构的出现往往都有其特定的历史背景,要么是数据访问量太大、要么(想写的一些内容因为存储关系丢失了,一下子又没有想起来,下面是重写的,但内容已经和原来想的不太一样了)

高春辉就在他的勃客里认为,主从数据库不行了,未来的数据存储走向应该不会再是主从,他这么说:

这里可以先提前说一下吧,记得之前的迁移网站时的帖子里我说过,让 MYSQL 主从架构去死,很多人不太信。

而现在这个 DAL 的架子越来越清楚,我相信是可以达到99%的可能性,可以使主从架构从最大的用途是读写分离,变成了数据备份。其实我到现在也不知道 MySQL 当时推主从架构是为了读写分离还是数据备份。:D

我认为不管是主从还是主主结构都有一个最大的问题,主库和从库的数据的延迟更新问题,主主方式会好一些,但是配置起来太麻烦了。尤其是要求越高,就会越感觉到严重性。

而从程序员的角度,对于数据库的操作,最大的问题就是要把缓存的逻辑和数据逻辑混写,导致代码很难写也很难读,也很难调试清楚。

那么 DAL 如果能够帮助程序不用再关心缓存逻辑,只关心业务逻辑的话,不知道您是否认同 DAL 的重大作用呢?而代码量在我认为,起码可以减少个20%-30%吧?因为起码去掉了三个逻辑:读取缓存、判断有效和设置缓存。

我也觉得其实这个 DAL 的最核心功能就是如何自动缓存和清理缓存了。因为不让程序员缓存和清理,就的是程序自己来管理缓存和清理缓存,总得清理嘛。不过这个还是保密一下吧。起码不是某些人想的只能缓存单条数据,也不是某些人想的清理是按照单条方式的清理。当然另外的一个核心功能就是分库分表的自动和透明化,这个功能有很多软件都实现了,就不多说了。

文末,他推荐了一篇InfoQ上的文章,在这里我也进行转载一下,是关于FriendFeed实现基于MySQL的无模式存储,不过他这种架构也不是能拿来就要用的,也需要根据目前的实际情况,只能进行参考。这是一篇翻译文章:

作者 Dave West译者 王丽娟 发布于 2009年4月4日 下午8时7分

对于迅速增长的网站所遇到的问题——“用灵活的模式存储数据、即时创建新的索引”,FriendFeed的Bret Taylor介绍了一种“无模式的解决方案” 。问题本身源自一些需求:需要不断增加新功能,不断更新底层的数据库结构和数据库中存储的数百万条已有记录,还要同时支持新旧功能。FriendFeed的办法是基于MySQL建立一个无模式的解决方案,而不是迁移到别的技术基础上去。Bret描述了基本问题:

尤其是有一两千万行数据的时候,每次修改模式、往数据库中添加索引都会数小时完全锁定数据库。删除旧索引也需要同样长的时间,但不删除又会影响性能,因为 数据库在每次执行INSERT操作时都会继续读写这些不用的块,而重要的块却没有足够的内存。经过一些复杂的操作过程可以克服以上困难(比如在从机上创建 新索引,然后调换从机和主机),但这些操作过程都很容易出错,也都是重量级的,因此会使我们因为害怕改变模式/索引而不敢增加新功能。由于我们的数据库都 是严重分片的,像JOIN这些MySQL的关系型功能对我们毫无用处,所以我们决定看看RDBMS之外的领域。

研究了几个可行的解决方案后,他们决定基于MySQL的自定义一种“无模式”持久化方案,而不是彻底改换门庭。

他们的解决方案是把主要数据和这些数据的索引分离开来。“我们的数据存储储存了无模式的属性包……我们在单独的MySQL表中存储索引,从而在这些实体中索引数据。”这是以容量来换效率。

结果我们比以前多了很多的表,但添加和删除索引却很容易。我们大力优化了填充新索引的进程(我们称之为“Cleaner”),以便该进程能快速填充新索引,而不会让站点中断。

分离数据和索引引起了一致性和原子性问题。他们没有建立严格的事务规则,而是把数据库表推到最简,索引只用来引用,发生实际的数据库读操作的时候才 施加数据过滤。他们改进了持续更新表的自动化进程,让这个“Cleaner”进程不停地对优先级高的被更新实体进行更新和索引修正。尽管可能出现不一致, 但消除不一致的时间平均不到两秒钟。

Bret用平均页面延迟这一指标描述了以下走向。

  • 整体来说——尽管有增加的趋势,但还是有显著的减少。
  • 过去二十四小时——即使在高峰时段也保持稳定。
  • 前一周——明显减少。

Bret的帖子有很多回复。有一种观点认为“对于模式演变,现代的RDBMS不像MySQL局限那么大”,这种观点忽略了选择背后的成本问题。其它读者则回复了更多种不同的解决办法。

有意思的是,并没有人指出FriendFeed的解决方案与古老的ISAM技术(Indexed Sequential Access Method,索引顺序存取法)之间的相似性。ISAM用的是同样的基本架构——分离数据和索引,同时在数据发生变化时自动更新索引。

查看英文原文:FriendFeed Implements Schema-less Storage Atop MySQL