标签:javascript

浏览模式: 标准 | 列表 | 图文
雅虎JavaScript架构师:网页开发技术安全优先

雅虎JavaScript架构师:网页开发技术安全优先

html5 越来越近了,HTML5可能给我们带来很大的改变,就象新的标签可以支持视频了。看看javascript的架构师能够做什么吧。原文来自http://www.cnbeta.com/articles/109538.htm

由于当前技术仍偏向功能强化为主要思维,指令码趋向庞杂的结果,容易产生更多安全漏洞,且失去快速因应攻击调整架构的灵活性。
身 为JavaScript网路技术重要推手的雅虎(Yahoo!)架构设计师Douglas Crockford表示,现行网页开发技术思维仍偏重多媒体功能或浏览效能的提升,未来应以安全为第一优先。 Crockford 现为Yahoo!资深JavaScript架构师,负责YUI(Yahoo! User Interface)的架构设计,并且担任ECMA JavaScript 2.0技术委员会成员,为JavaScript开发社群大师级人物,此次受邀来台参加OSDC(Open Source Developer's Conference Taiwan)进行专题演讲,向国内开发者介绍ECMA JavaScript的发展。

Crockford向媒体阐述网络技术发展时指出,当前的网络技术仍然不脱过去的思维,网页开发技术仍以功能强化、浏览网页效能提升为主,虽然强 化了网络开发的丰富性,但未将网络安全列为开发优先考虑因素的结果,致使网络安全事件层出不穷。

延续过去网络开发思维的结果,现今网络技 术强调强大的互动、多媒体功能,但也让一些攻击手法兴起,以XSS(Cross-Site Scripting)为例,由于内嵌多个不同来源的脚本,容易让黑客借指令集趁虚而入,窃取用户端计算机的数据。

虽然也有新的技术,如 Google推动的Caja,用以防范XSS跨站攻击手法,但整体技术发展方向仍是朝功能、效能提升前进。

以HTML 5技术为例,Crockford表示,虽然HTML5增加了许多功能,但让整个脚本变得更为庞大且复杂,容易产生漏洞遭到攻击;另外,支持存取使用者电 脑、手机的终端数据,将数据被窃的安全风险扩大至手机上,而过于庞大复杂的结果,不容易因应日新月异的攻击手法改变,长期而言易形成安全风险。

对 于当前浏览器业者形成速度竞赛,纷纷强化JavaScript引擎加速网页浏览速度,号称最快的浏览速度,他认为,浏览器加速网页浏览速度虽是好事,但这 样改善方式有限,只在5至10%的终端浏览器部份加速,若能同时改善服务器端,加速的效果更大。

对于制定中的新标准ECMA Script 5,他乐观预期未来将成为主要的网络开发标准,虽然Apple、Chrome还不明确,但包括IE、FireFox、Opera都倾向ECMA Script 5,今年应会看到新的浏览器应用。
--EOF--
HTML5已经被越来越多的浏览器所支持,IE还能挺多久?是否又会创造出什么新标准?从IE4开始,多少网页设计师为了兼容所有的浏览器而痛苦?以后又会怎么样?IE6还有这么多用户,怎么办?这一些都让人迷惘啊。HTML5来了,对于前端工程师的压力就要更大一点了。代码没写好,很可能就直接被人利用了。以前的XSS漏洞可能会被更加扩大、放大。还是需要多学一点安全了

如何避免switch-case组合

这是cssrain站长翻译的一篇文章,事实上,在PHP中,已经不太建议使用switch-case了。
特别是在面向OO的代码中,你几乎也看不到这样的代码出现

不是说这个方式不好。而是,它的可扩展性不强。所以在大多数情况下,都放弃采用这种方式。

以下是翻译内容,来源于:http://www.cssrain.cn/article.asp?id=1384:

我很年轻,还没有做过很长的编程。所以我对使用switch-case 语法没有什么很深刻的印象,至少在我的记忆中是这样。或许你认为这是一件坏事情。你甚至会怀疑我为什么不使用它们。我真的不知道为什么,似乎我天生就不喜欢使用它,如下所示:

switch (something) {
case 1:
doX();
break;
case 2:
doY();
break;
case 3:
doN();
break;
// And so on...
}

显然,虚构此代码的作者不够了解使用其他JavaScript方法来构建此功能。其实有很多种方式更适合这种情况,而不是一个丑陋的switch. 有许多许多更轻松,更优雅的方式来实现这种功能。
switch-case组合肯定是非常有用的,当你有一个变量并且依靠它的值的不同来做不同的事情。使用多个if-else不太恰当,所以人们通常使用switch-case来代替多个if-else.我敢肯定你也是.
上面的例子依赖于 something 判断 ,然后根据条件运行doX , doY或doN 。在JavaScript中,同样的逻辑可以表示一个简单的查找表的形式————对象,如下所示:

var cases = {
1: doX,
2: doY,
3: doN
};
if (cases[something]) {
cases[something]();
}

这不仅简洁,而且也可以重复使用和修改条件。所有条件都是对象的一部分,因此,如果您需要改变某些条件那就非常简单了。

所以,我想说的是:请不要使用switch-case,除非绝对必要的。 为什么? 因为有更好的替代品,比它更简单!

关于“ switch-case”的语法,请浏览:http://en.wikipedia.org/wiki/Switch_statement

如果想阅读原文,请点击这里:http://james.padolsey.com/javascript/how-to-avoid-switch-case-syndrome/
提示:译文跟原文有出入,请看原文。

jQuery 1.3 中文文档发布

jQuery 1.3 中文文档发布

jquery 1.3刚刚出来没几天,shawphy的中文API就基本出炉了,有时候真的挺佩服他们,当我们在娱乐的时候,他们还在努力的为我们这些人造福。我没有什么其他能力,只能做到代为传播了。同时也是希望有更多的人参与,可以让我们这些使用者也能够更加方便。

网址:http://shawphy.com/2009/01/release-jquery-doc-cn-1-3.html
原文如下:

jQuery 1.3自从2008年1月14日发布后,后引来了各界的关注。我们也随即投入到翻译文档的工作中来。经过4天的努力,终于完工了。这个版本更新了不少东西

changelog:

2009-01-18 16:06:52 +0800
* triggerHandler 进一步说明
* trigger 进一步说明

2009-01-17 22:37:11 +0800
* live() - 与bind()不同的是,live()一次只能绑定一个事件。
* [attribute!=value] jQuery 1.3中意义改变
* load 的data参数在jQuery 1.3中也可以接受String
+ ajax的error回调的第二个参数可能值”timeout”, “error”, “notmodified” 和 “parsererror”
+ ajax参数xhr
* animate 的duration为0的问题
* show, hide, toggle, slideDown, slideUp, slideToggle 在jQuery 1.3中,padding和margin也会有动画,效果更流畅。
* jQuery(html,[ownerDocument])等效于$(document.createElement(”span”)
* is支持复杂表达式

2009-01-17 18:31:10 +0800
+ jQuery.support.scriptEval
+ 原 Dimension 插件功能(1.2.6版加入jQuery核心)

2009-01-16 19:11:10 +0800
+ jQuery.fx.off
+ toggleClass( class, switch )
+ toggle( switch )
+ toggle(speed,[callback])
* 修改queue和dequeue方法的参数和说明

2009-01-15 22:31:02 +0800
* jQuery(html,[ownerDocument])
+ jQuery.selector
+ jQuery.context
* 效果下的queue和dequeue搬到核心下
+ live()
+ die()
+ closest()
* stop( [clearQueue], [gotoEnd]) 增加两个参数
+ jQuery.support
+ jQuery.isArray( obj )

感谢Cloudream的热情帮忙。还要感谢一揪制作chm版。这个版本还加入了检查更新的功能。如果有需要的同学可轻松查看是否有更新的中文文档(chm版中的检查更新也将同步升级)。

在线查看 下载离线版 bug提交

JS的一些设计模式的演示

最近可能是快过年了吧,园子里的人写文章的激情开始迸发,什么样的文章都有了。这不,看到这些用JS写的设计模式,感觉还不错。转载一下看看。。。

Javascript乱弹设计模式系列(4) - 组合模式(Composite)
Javascript乱弹设计模式系列(3) - 装饰者模式(Decorator)
Javascript乱弹设计模式系列(2) - 抽象工厂以及工厂方法模式(Factory)

Javascript乱弹设计模式系列(1) - 观察者模式(Observer)
Javascript乱弹设计模式系列(0) - 面向对象基础以及接口和继承类的实现

估计以后还会有,先贴上,有的时候,我再加上

How JavaScript Timers Work[COPY]

转载这篇文章的原因是它解释了setTimeout和setInterval之间的区别,对于这篇文章,博客园有位朋友进行了翻译,网址如下:http://www.cnblogs.com/rainman/archive/2008/12/26/1363321.html

翻译内容为:

How JavaScript Timers Work

从基础的层面来讲,理解JavaScript的定时器是如何工作的是非常重要的。计时器的执行常常和我们的直观想象不同,那是因为JavaScript引擎是单线程的。我们先来认识一下下面三个函数是如何控制计时器的。

  • var id = setTimeout(fn, delay); - 初始化一个计时器,然后在指定的时间间隔后执行。该函数返回一个唯一的标志ID(Number类型),我们可以使用它来取消计时器。
  • var id = setInterval(fn, delay); - 和setTimeout有些类似,但它是连续调用一个函数(时间间隔是delay参数)直到它被取消。
  • clearInterval(id);, clearTimeout(id); - 使用计时器ID(setTimeout 和 setInterval的返回值)来取消计时器回调的发生

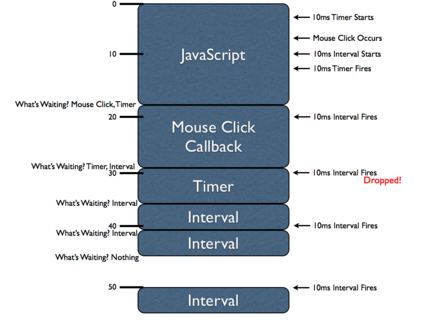
为了理解计时器的内在执行原理,有一个重要的概念需要加以探讨:计时器的延迟(delay)是无法得到保障的。由于所有JavaScript代码是在一个线程里执行的,所有异步事件(例如,鼠标点击和计时器)只有拥有执行机会时才会执行。用一个很好的图表加以说明:

(点击查看大图)

在这个图表中有许多信息需要理解,如果完全理解了它们,你会对JavaScript引擎如何实现异步事件有一个很好的认识。这是一个一维的图标:垂 直方向表示时间,蓝色的区块表示JavaScript代码执行块。例如第一个JavaScript代码执行块需要大约18ms,鼠标点击所触发的代码执行 块需要11ms,等等。

由于JavaScript引擎同一时间只执行一条代码(这是由于JavaScript单线程的性质),所以每一个JavaScript代码执行块会 “阻塞”其它异步事件的执行。这就意味着当一个异步事件发生(例如,鼠标点击,计时器被触发,或者Ajax异步请求)后,这些事件的回调函数将排在执行队 列的最后等待执行(实际上,排队的方式根据浏览器的不同而不同,所以这里只是一个简化);

从第一个JavaScript执行块开始研究,在第一个执行块中两个计时器被初始化:一个10ms的setTimeout()和一个10ms的setInterval()。 依据何时何地计时器被初始化(计时器初始化完毕后就会开始计时),计时器实际上会在第一个代码块执行完毕前被触发。但是,计时器上绑定的函数不会立即执行 (不被立即执行的原因是JavaScript是单线程的)。实际上,被延迟的函数将依次排在执行队列的最后,等待下一次恰当的时间再执行。

此外,在第一个JavaScript执行块中我们看到了一个“鼠标点击”事件发生了。一个JavaScript回调函数绑定在这个异步事件上了(我 们从来不知道用户什么时候执行这个(点击)事件,因此认为它是异步的),这个函数不会被立即执行,和上面的计时器一样,它将排在执行队列的最后,等待下一 次恰当的时候执行。

当第一个JavaScript执行块执行完毕后,浏览器会立即问一个问题:哪个函数(语句)在等待被执行?在这时,一个“鼠标点击事件处理函数”和 一个“计时器回调函数”都在等待执行。浏览器会选择一个(实际上选择了“鼠标点击事件的处理函数”,因为由图可知它是先进队的)立即执行。而“计时器回调 函数”将等待下次适合的时间执行。

注意,当“鼠标点击事件处理函数”执行的时候,setInterval的回调函数第一次被触发了。和setTimeout的回调函数一样,它将排到执行队列的最后等待执行。但是,一定要注意这一点:当setInterval回调函数第二次被触发时(此时setTimeout函数仍在执行)setTimeout的第一次触发将被抛弃掉。当一个很长的代码块在执行时,可能把所有的setInterval回调函数都排在执行队列的后面,代码块执行完之后,结果便会是一大串的setInterval回调函数等待执行,并且这些函数之间没有间隔,直到全部完成。所以,浏览器倾向于的当没有更多interval的处理函数在排队时再将下一个处理函数排到队尾(这是由于间隔的问题)。

我们能够发现,当第三个setInterval回调函数被触发时,之前的setInterval回调函数仍在执行。这就说明了一个很重要的事实:setInterval不会考虑当前正在执行什么,而把所有的堵塞的函数排到队列尾部。这意味着两次setInterval回调函数之间的时间间隔会被牺牲掉(缩减)。

最后,当第二个setInterval回调函数执行完毕后,我们可以看到没有任何程序等待JavaScript引擎执行了。这就意味着浏览器现在在等待一个新的异步事件的发生。在50ms时一个新的setInterval回调函数再次被触发,这时,没有任何的执行块阻塞它的执行了。所以它会立刻被执行。

让我们用一个例子来阐明setTimeout和setInterval之间的区别:

setTimeout(function(){
/* Some long block of code... */
setTimeout(arguments.callee, 10);
}, 10);

setInterval(function(){
/* Some long block of code... */
}, 10);

这两句代码乍一看没什么差别,但是它们是不同的。setTimeout回调函数的执行和上一次执行之间的间隔至少有10ms(可能会更多,但不会少于10ms),而setInterval的回调函数将尝试每隔10ms执行一次,不论上次是否执行完毕。

在这里我们学到了很多知识,总结一下:

  • JavaScript引擎是单线程的,强制所有的异步事件排队等待执行
  • setTimeout 和 setInterval 在执行异步代码的时候有着根本的不同
  • 如果一个计时器被阻塞而不能立即执行,它将延迟执行直到下一次可能执行的时间点才被执行(比期望的时间间隔要长些)
  • 如果setInterval回调函数的执行时间将足够长(比指定的时间间隔长),它们将连续执行并且彼此之间没有时间间隔。

上述这些知识点都是非常重要的。了解了JavaScript引擎是如何工作的,尤其是大量的异步事件(连续)发生时,才能为构建高级应用程序打好基础。


英文原文如下:

At a fundamental level it's important to understand how JavaScript timers work. Often times they behave unintuitively because of the single thread which they are in. Let's start by examining the three functions to which we have access that can construct and manipulate timers.

  • var id = setTimeout(fn, delay); - Initiates a single timer which will call the specified function after the delay. The function returns a unique ID with which the timer can be canceled at a later time.
  • var id = setInterval(fn, delay); - Similar to setTimeout but continually calls the function (with a delay every time) until it is canceled.
  • clearInterval(id);, clearTimeout(id); - Accepts a timer ID (returned by either of the aforementioned functions) and stops the timer callback from occurring.

In order to understand how the timers work internally there's one important concept that needs to be explored: timer delay is not guaranteed. Since all JavaScript in a browser executes on a single thread asynchronous events (such as mouse clicks and timers) are only run when there's been an opening in the execution. This is best demonstrated with a diagram, like in the following:
aab87e80b3d460b7be414cc9cda00be7

There's a lot of information in this figure to digest but understanding it completely will give you a better realization of how asynchronous JavaScript execution works. This diagram is one dimensional: vertically we have the (wall clock) time, in milliseconds. The blue boxes represent portions of JavaScript being executed. For example the first block of JavaScript executes for approximately 18ms, the mouse click block for approximately 11ms, and so on.

Since JavaScript can only ever execute one piece of code at a time (due to its single-threaded nature) each of these blocks of code are "blocking" the progress of other asynchronous events. This means that when an asynchronous event occurs (like a mouse click, a timer firing, or an XMLHttpRequest completing) it gets queued up to be executed later (how this queueing actually occurs surely varies from browser-to-browser, so consider this to be a simplification).

To start with, within the first block of JavaScript, two timers are initiated: a 10ms setTimeout and a 10ms setInterval. Due to where and when the timer was started it actually fires before we actually complete the first block of code. Note, however, that it does not execute immediately (it is incapable of doing that, because of the threading). Instead that delayed function is queued in order to be executed at the next available moment.

Additionally, within this first JavaScript block we see a mouse click occur. The JavaScript callbacks associated with this asynchronous event (we never know when a user may perform an action, thus it's consider to be asynchronous) are unable to be executed immediately thus, like the initial timer, it is queued to be executed later.

After the initial block of JavaScript finishes executing the browser immediately asks the question: What is waiting to be executed? In this case both a mouse click handler and a timer callback are waiting. The browser then picks one (the mouse click callback) and executes it immediately. The timer will wait until the next possible time, in order to execute.

Note that while mouse click handler is executing the first interval callback executes. As with the timer its handler is queued for later execution. However, note that when the interval is fired again (when the timer handler is executing) this time that handler execution is dropped. If you were to queue up all interval callbacks when a large block of code is executing the result would be a bunch of intervals executing with no delay between them, upon completion. Instead browsers tend to simply wait until no more interval handlers are queued (for the interval in question) before queuing more.

We can, in fact, see that this is the case when a third interval callback fires while the interval, itself, is executing. This shows us an important fact: Intervals don't care about what is currently executing, they will queue indiscriminately, even if it means that the time between callbacks will be sacrificed.

Finally, after the second interval callback is finished executing, we can see that there's nothing left for the JavaScript engine to execute. This means that the browser now waits for a new asynchronous event to occur. We get this at the 50ms mark when the interval fires again. This time, however, there is nothing blocking its execution, so it fires immediately.

Let's take a look at an example to better illustrate the differences between setTimeout and setInterval.

setTimeout(function(){
/* Some long block of code... */
setTimeout(arguments.callee, 10);
}, 10);

setInterval(function(){
/* Some long block of code... */
}, 10);

These two pieces of code may appear to be functionally equivalent, at first glance, but they are not. Notably the setTimeout code will always have at least a 10ms delay after the previous callback execution (it may end up being more, but never less) whereas the setInterval will attempt to execute a callback every 10ms regardless of when the last callback was executed.

There's a lot that we've learned here, let's recap:

  • JavaScript engines only have a single thread, forcing asynchronous events to queue waiting for execution.
  • setTimeout and setInterval are fundamentally different in how they execute asynchronous code.
  • If a timer is blocked from immediately executing it will be delayed until the next possible point of execution (which will be longer than the desired delay).
  • Intervals may execute back-to-back with no delay if they take long enough to execute (longer than the specified delay).

All of this is incredibly important knowledge to build off of. Knowing how a JavaScript engine works, especially with the large number of asynchronous events that typically occur, makes for a great foundation when building an advanced piece of application code.
浅复制与深复制中的传值与传址

浅复制与深复制中的传值与传址

说实话,我看到这个标题的时候没有看懂,确实没有理解本文的标题想表达什么意思。看完之后我是理解了。先贴上原文,再谈我的理解。。。

原文地址:http://www.cn-cuckoo.com/2008/12/24/shallow-or-deep-copy-and-pass-by-value-or-reference-270.html

内容如下:

这个标题念起来有点拗口,但却是理解数据结构的关键。标题中的4个术语,对应的英文分别是:shallow copy(注意,不是shadow copy)、deep copy、pass by value、pass by reference(或pass by address)。传址和传引用是一回事。

一门编程语言的核心是数据结构,粗略来讲,可以把数据结构分成不可变类型(immutable)和可变类型(mutable)。为什么这么分呢?这涉及到内存分配问题。对于不可变类型,只要分配有限的内存空间即可,而对于不可变类型,理论上则要分配没有大小限制的空间。因此,这么分是出于合理利用系统资源的考虑。实际上,堆内存和栈内存分别用于保存不可变类型值和可变类型值。

什么是不可变类型?就是该值一旦赋予某个变量,就只属于某个变量,不能同属于其他变量。如:

var stringValue = “I’m immutable data structure, mean you can’t modify me!”;
var anotherStringValue = stringValue;
stringValue = “I have changed”;

此时,anotherStringValue中保存的值会不会也变成“I have changed”?不会。因为

var anotherStringValue = stringValue;

照stringValue中保存的字符串的原样,复制一个字符串(相应地,在内存中分配一块新空间),并将该字符串赋给 anotherStringValue。换句话说,这两个变量虽然保存的值相同,但它们的值并不在一块内存中。因此,修改任何一个变量,都不会影响另一个变量。即

stringValue = “I have changed”;

只会影响stringValue的值。但是,确切来讲,stringValue = “I have changed”;并不是修改stringValue,而是创建了一个新字符串(相应地,在内存中分配一块新空间),然后让stringValue引用该字符串——更像是替换变量的值;原来的字符串呢?因为没有变量引用它,也就成为垃圾了(当然,垃圾所占用的内存会被回收)。

由此可见,赋值操作对于不变类型而言,传递的是内存中的值本身。那么,对于可变类型呢?当然,传递的是内存中值的引用(或者说地址),而且无论传递多少次,内存中始终都只有一份原始值——毕竟可变类型大小莫测,只保存一份原始值能最大限度节省内存空间。例如:

var objectValue = {1:1,’s’:’string’,'innerObject’:{’innerArray’ : [1,2,3]}};
var anotherObjectValue = objectValue;
objectValue[1] = 100;
anotherObjectValue[1]; //100

不言自明,这里的anotherObjectValue通过赋值操作,从objectValue那里只获得了对原始对象( {1:1,’s’:’string’,'innerObject’:{’innerArray’ : [1,2,3]}})的引用,也就是该对象在内存中的地址,或者说“门牌号码”。因此,修改通过objectValue修改原始对象的第一个元素(objectValue[1] = 100;),结果当然会在anotherObjectValue[1]这里得到反映了。

在JavaScript中,给函数传递参数是按照上述默认约定——即对不可变类型,传值;对可变类型,传址——进行的。如:

function example(str, obj){
……
}
example(stringValue,objectValue);

调用example函数时,第一个参数传递的是实际的字符串值,第二参数传递的是对象的引用(内存地址)。

在PHP中,定义函数时可以指定相应参数是传值还是传址——通常是传值。其实,这也很容易理解:假如函数要求为某个可变类型参数传值,而不是传址,那么也就意味着内存中会因此多出一份该类型值的副本。相应地,在函数中修改这份新副本,不会影响函数外的原副本。因为新旧副本在内存中就不是同一个地址。说到这,也就引出了浅复制和深复制的概念。事实上,浅复制和深复制的区别恰恰在于复制可变类型时,是传值还是传址。如果是像往常一样传址(传引用),那么就是浅复制。如果是传值,那么就是深复制。浅复制和深复制到底有什么区别呢?以下面的Python代码为例:

>>> x = {’username’: ‘admin’, ‘machines’: [’foo’, ‘bar’, ‘baz’]}
>>> y = x.copy()
>>> y[’username’] = ‘mlh’
>>> y[’machines’].remove(’bar’)
>>> y
{’username’: ‘mlh’, ‘machines’: [’foo’, ‘baz’]}
>>> x
{’username’: ‘admin’, ‘machines’: [’foo’, ‘baz’]}

调用字典x的copy方法返回一个新字典并赋值给y,新字典中带有与原字典相同的键-值对。注意,copy方法采用浅复制创建的新字典,与原字典有区别也有联系。区别体现在,对于原字典中不可变的值,如数字、字符串、元组等,会在新字典中重新生成一份新副本;因此,修改(实际上是替换,或者说是重新赋值)这些键的值(y[’username’] = ‘mlh’)不会影响原字典。联系体现在,对于原字典中可变的值,如列表、字典,不会在新字典中生成新副本,而只复制值的引用,即新字典中相应的键保存的是引用,当然,原字典中相应的键保存的也是引用,而且这两个引用都指向同一块内存地址。这就是所谓的浅复制。因此,如果修改的是可变类型的值(y[’machines’].remove(’bar’)),就一定会影响引用该值的原字典项了。

深复制则不然。深复制是实实在在地把原字典中所有的值全都照原样子重新创建一遍,无论是不变类型值,还是可变类型值。执行深复制后,内存中会存在两份完全一样的数据段,但分别处于不同内存空间中,即地址不同。而且,分别由不同变量(原字典、新字典)引用。因此,经过深复制后修改一个字典,不会影响另一个字典。Python的copy模块中的deepcopy函数可以实现深复制:

>>> from copy import deepcopy
>>> d = {}
>>> d[’names’] = [’Alfred’, ‘Bertrand’]
>>> c = d.copy()
>>> dc = deepcopy(d)
>>> d[’names’].append(’Clive’)
>>> c
{’names’: [’Alfred’, ‘Bertrand’, ‘Clive’]}
>>> dc
{’names’: [’Alfred’, ‘Bertrand’]}

显然,修改深复制得到的新值不会影响原值;而修改浅复制得到的“新”值,在某种程度上仍然会影响原值。
作者想表达的意思应该是在javascript中变量的复制和赋值,对于普通的变量而言,赋值仅仅是一个复制,而对于对象而言,赋值则是一个引用。

比如:var a=1;var b=a;

在这里,b其实是a的一个复制,所以b=1,正因为是复制,所以复制完后,b和a就没有任何关系了,当a重新赋值的时候,对于b则没有影响,同样,对于b再重新赋值,对a也没有影响 。

但是,如果a是一个对象,那就不一样了

例如var test ={a:1,b:2};var test1 =test;

在这样的情况下,test1就不再是test的复制了,而是直接取了test的地址,所以对于Test的值的改变,也影响到了test1,比如我test.a = 2,那么我test1.a的值也就自动变成了2

这点其实在PHP5里面已经也这样了,在PHP4的时候,对象的赋值也是一个复制,所以我们为了保证只有一个实例,往往都是采用:$a = &$b ;但是从5开始则不一样,对于对象而言,如果没有特别指定的操作,那么就相当于是对地址的一个引用。效果和上面的JS代码类似。

作者在最后举了一个PYTHON的例子来说明深复制,其实也就是为对象也做一个拷贝而不是采用引用,这个,当然在PHP里也有,clone就是实现的这个效果。HOHO

Help Test jQuery 1.3 Beta 1

The jQuery team has been working hard on the new release of the jQuery library and it’s ready for some in-depth testing! jQuery 1.3 is not ready for production use yet but we need help to weed out any bugs that might’ve snuck through.

看上去jQuery团队们都很辛苦,所以,小白鼠们,你们也辛苦一点,把BUG测试的多一点,我们在以后的项目中才敢正常的应用啊。

自己也是用jQuery的,应该也会测试一些,特别是针对这次更新的功能:

  • Selector Engine - The selector code has undergone a complete rewrite - it’s likely that some edge cases still exist here.
  • DOM Manipulation (append/prepend/before/after) - This code has also undergone a large rewrite along with some of the logic for executing inline script elements.
  • .offset() - Another method that has been completely rewritten.
  • Event Namespaces - The logic for handling namespaced events has been completely rewritten.
  • Event Triggering - When triggering an event the event now bubbles up the DOM - this is likely to cause some problems.

选择器改写,DOM控制器又是大的改写,.offset改写,事件命名空间改写,不知道改写后效率会怎么样,当然,估计改写也应该是冲着效率而去的,否则改写的意义也不是特别大了。

事件触发,针对DOM的事件触发?估计问题也会挺多,他们也是这么认为的。DOM太难控制了,毕竟不是每个页面都是按照规范来写的。

如果你写了一些代码,并认为它触发了这些BUG,你可以提交到:http://dev.jquery.com/ ,当然提交的代码尽量是简短一些,提交的时候也需要将你的mail写上,这样,jQuery Team可能在修改后会通知你的哦。

jQuery插件---获取URL参数

jQuery插件---获取URL参数

平时我们取得location的search的时候,往往都是要用location.search,然后根据取回的结果集再处理

1、先判断第一位是否是“?”,如果是则从?开始往后面处理

2、写程序以&开始分隔,当然得先用unescape,或者用那个urldecode(具体的名字不记得了)处理一下,把&之类的处理一下

3、以=分隔,这样才能可以取得一一对应的值。

现在方便了。jQuery有这样的插件了。。。。

原文来自:http://www.cssrain.cn/article.asp?id=1204

内容如下:

例如 当前你的URL是:
http://www.cssrain.cn/index.php?test=1&kk=2

如果想获取test,则可以引入插件后,
用如下方法获取:
var test = $.query.get('test');

如果参数有多个相同的名称 ,则可以这样:
var arr = $.query.get('testy');
输出: [ 值1 , 值2, 值3...]

如果要获取多个相同名称中的某一个,可以这样:
var arrayElement = $.query.get('testy[1]');

此插件不仅能获取参数,也能设置参数。

设置一个参数:
var newUrl = $.query.set("section", 5).toString();
输出 : "?section=5"

设置两个参数:
var newUrl = $.query.set("section", 5).set("action", "do").toString();
输出 : "?action=do&section=5"


删除一个参数:
var oldQueryAgain = $.query.REMOVE("type");

清空所有参数:
var emptyQuery = $.query.empty();

复制所有参数:
var stillTheSame = $.query.copy();


插件地址:
http://plugins.jquery.com/project/query-object

通过JS更改FORM的action

通过JS更改FORM的action

有时候我们不得不通过更改form的action来进行提交数据。当然大多数情况下,我们都是通过隐藏的字段来使action得到不同的数据。比如我们form的action是search.php,那么我们都是通过隐藏字段来使我们通过search.php搜索不同值,比如<input type="hidden" name="action" value="article">然后在search.php里面通过$_POST['action']=='article'来知道我们搜索的内容是文章而不是其他。

但如果我们搜索页面并非只有一个入口search.php怎么办?比如我们的全文搜索是search.php,搜索文章是search_article.php,搜索新闻是search_news.php。怎么办?当然我们可以通过下拉框的值来更改FORM的action,就可以了。

简单代码如下,

<script type="text/javascript">
<!--
function redirectForm( which ){
var searchModeList = document.getElementById('searchMode');
var actionFile = '';
for (var i=0,sml=searchModeList.length; i<sml ; i++ ){
if( i == searchModeList.selectedIndex ){
actionFile = searchModeList[i].value;
}
}
if( actionFile == ''){
return false;
}else{
actionFileactionFile = actionFile + '.php';
}
which.action = actionFile;
which.submit();
}
//-->
</script>
<form method="post" action="" onsubmit="return redirectForm(this);" id='searchForm'>
<select id="searchMode">
<option value="search" selected="selected">Default</option>
<option value="search_article" >Article</option>
<option value="search_news">News</option>
</select>
<input type="submit" />
</form>

Minify的简单介绍

上篇从老王的博客里抓了点东西,在文末我提到了minify,然后我又从nio的博客中找到minify的资料,同样贴给大家,具体的英文更新,还是可以从:http://code.google.com/p/minify/来进行获取,下面的是nio的翻译。。。

原文网址:http://nio.infor96.com/archives/862

内容如下:

Minify 是使用 PHP5 开发的用于合并压缩 js/css 文件的应用程序。合并压缩之后的结果可通过 HTTP gzip/deflate 及一些相关头,优化客户端缓存。可参考 Yahoo 的 Rules for High Performance Web Sites。

Minify 的安装使用很简单,下载最新版本,解压,将 min 目录复制到发布目录下,然后访问 http://example.com/min/,在显示的界面中加入你想合并压缩的 js/css 路径,点击 'Update' 之后会为你生成一个 url,如:

http://localhost/min/b=googletesting/js&f=mootools.js,iAction.js,iAjax.js,global.js

接下来你就可以将这个 url 放到你的页面中了。这样可以使请求数减少,传输的字节数也小了很多。而且 Minify 支持服务器端 cache,即将合并压缩的结果 cache 到服务器端文件中,下次访问就不需要再重新做合并压缩的操作了。如果需要组合的文件很多,url 就会变得很长,Minify 支持 group,可以将这些文件分组,这样 url 中只需指定 g=group名字 就可以了。

总之,Minify 很实用 :)


以下是最新更新的内容:

Version 2.1.0 (2008-09-18)

  • "min" default application for quick deployment
  • Minify URI Builder app & bookmarklet for quickly creating minify URIs
  • Relative URIs in CSS file are fixed automatically by default
  • "debug" mode for revealing original line #s in combined files
  • Better IIS support
  • Improved minifier classes:
    • JS: preserves IE conditional comments
    • CSS: smaller output, preserves more hacks and valid CSS syntax, shorter line lengths, other bug fixes
    • HTML: smaller output, shorter line lengths, other bug fixes
  • Default Cache-Control: max-age of 30 minutes
  • Conditional GETs supported even when max-age sent
  • Experimental memcache cache class (default is files)
  • Minify_Cache_File has flock()s (by default)
  • Workaround for Windows mtime reporting bug