标签:优化

浏览模式: 标准 | 列表 | 图文
优化网站信息架构

优化网站信息架构

信息架构的定义

根据维基百科的定义,信息架构(Information Architecture, 简称IA)是在信息环境中,影响系统组织、导览、及分类标签的组合结构。它是基于信息架构方法论,并运用计算机技术 管 理和组织信息的一个专门学科。信息架构并非一开始就应用于网站设计,其起源于情报科学,最初应该是用于图书馆等地方的信息组织和信息检索的。

《用户体验的要素——以用户为中心的WEB设计》这本书中对信息架构的定义基于网站设计:信息架构着重于设计组织分类和导航的结构,从而让用户可以 提高效率、有效地浏览网站的内容。

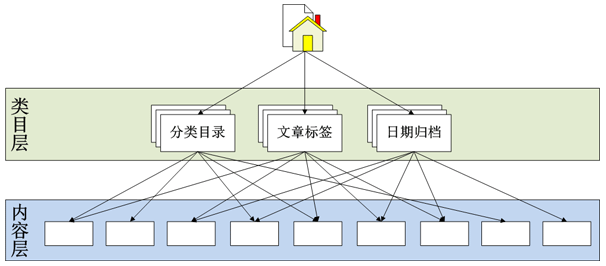
具体的就不再多说的,可能各有各的理解,这里直接来看一个实例——Wordpress的信息架构模式:
a0e0fb463072d00b5ef538198623f077

当然,上面这个图只能展示一个大体的网站信息架构,中间的类目层也许不止一层,会有大类、子类、子子类……底层可以是文章也可能是页面或者一些其他 的具体内容。而网站的内部关系也往往因为全局或局部导航、网站内链和内容关联等功能的存在而复杂的多,图上的箭头也会密集很多,但我们无需罗列所有内容间 的关系,关键是在理清基本的结构。

信息架构的类型

还是参考《用户体验的要素——以用户为中心的WEB设计》中对信息架构的几个分类:

层次结构(Hierarchical Structure)

也叫树形结构,是最常见的网站信息架构模式,上面举例的Wordpress的信息架构就是典型的层次结构。树形结构中箭头的方向不一定是自上而下 的,也可能是自下而上或者是双向的,而内容层之间也会因为一些关联链接的存在而存在同层次间的指向箭头。

矩阵结构(Matrix Structure)

矩阵结构比较注重“维”的概念,即从多维的角度来检索信息,如时间、地域、内容分类等,典型的应用就是内容管理系统(CMS)网站或者电子商务类网 站,比如你浏览豆瓣的电影时可以筛选:2010年—美国—科幻,也许这个时候《钢铁侠2》就呈现在你面前了。

线性结构(Sequential Structure)

看到线性结构也许你马上会想到面包屑,它将网站中最重要的一个信息架构路线展现了出来,即使它无法为你提供你在网站上的平面坐标,但至少它显示了你 现在正处于关键线路的哪个点上;当然,网站的一些关键路径一般也是按照线性结构涉及的,比如用户注册流程或电子商务网站的购买流程等。

网站分析与信息架构

根据网站业务模式的不同,可以选择适合自己网站的信息架构的模式,无论是上面的哪种信息架构模式,只要设计和运用合理,用户便能够在你的网站上以最 方便的形式、最快的速度找到他们需要的信息。

但当我浏览某些网站时,有时真的会让我感觉到“找不到北”,结果就是直接关闭该页面,如果不希望让已经进入了你的网站的用户轻易地离开,网站信息架 构的好坏将直接影响网站的用户体验。所以我们需要通过一些方法来检验网站的信息架构是否满足用户的信息检索的需求。

1.尝试整理出类似上面例子中的网站信息架构图

这个是最简单最直观的方法,如果你的网站信息架构足够清晰,那么画出这样的图对你来说也绝非难事;而当网站的应用比较复杂、内容比较宽泛,那么可能 要整理出网站的整体信息架构就会相对困难,但我相信一个设计优秀的网站只要稍加整理,大体的信息架构图还是画得出来的;而当你绞尽脑汁就是理不清你的网站 的信息架构的头绪的时候,那么说明你的网站需要优化了。

2.通过网站分析的方法验证信息架构的合理性

本文的副标题是“让用户更容易地找到需要的信息”,所以我们需要分析用户是否能够在你的网站上方便快捷地找到他们需要的信息,这里推荐一种方法—— 寻找网站中的迷失用户(Lost Visits)。

在一个合理的信息架构下,大多数的用户是不会在你的网站上迷路的;反之,混乱的信息架构会导致大量的用户迷失方向,就像是进入了一个巨大的迷宫。那 么如何寻找这些迷失用户?我们可以先分析下这类用户的行为,最明显特征的就是:连续点击好几个页面,每个页面都只是初步浏览(因为没有找到他们需要的信 息)就转到另外的页面或直接离开了。所以我们可以借助网站分析中的两个度量:

浏览页面数(Depth of Visit):一次访问中用户总的浏览页面数;

页面平均停留时间(Avg. Time on Page):一次浏览中用户在每个页面的平均停留时间,即该次访 问总停留时间(Time on Site)/该次访问页面数(Depth of Visit)。

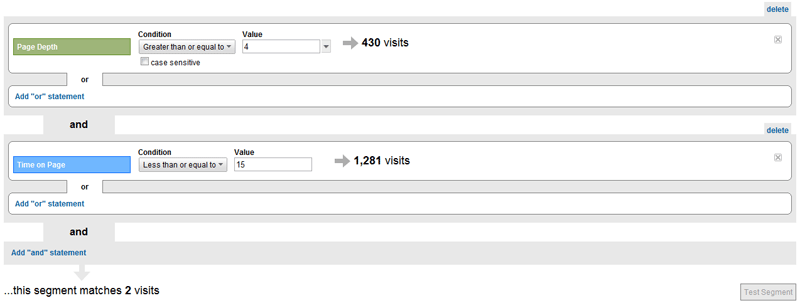
我们可以用户细分的方法把那些浏览页面数较多,但页面平均停留时间较短的用户浏览看作是迷失用户,具体的数值可 以根据网站自身的特点进行定义,比如我定义我的博客中浏览页面数大于等于4,而页面平均停留时间小于等于15秒的Visits为迷失用户的浏览行为,我们 可以借助Google Analytics中的高级群组(Advanced Segment)来 区分出这类用户,关于如何使用Google Analytics的高级群组功能,可以参考蓝鲸的文章——Google Analytics功能篇—高级群组,如下图:
07a7a0347dfc199008e48ec904f47ca3

当然,你可能会说这种用户区分的方法不准确,这类用户不一定就是迷失用户,也有可能他们确实找到并浏览了具体内容,但因为内容不够吸引人或者其他原 因而马上离开了该页面。所以这里用高级群组划分出来的这类Visits的数量不能看作是迷失用户的一个绝对数值,我们只能认为里面的大部分Visits都 是迷失用户,而不排除存在某些另类。所以更合理的方法是通过计算这类Visits占网站总Visits的比例情况来分析网站的信息架构到底是否合理,我们 可以在Google Analytics上面选取网站的All Visits和Lost Visits进行比例和趋势的比较,如下图:
7957f0c5378d0dd4b591d1737525f3c5

6565bf8f5f2a447fc9b28e749c29cf39

网站中迷失用户浏览的所占比例只需通过Lost Visits/All Visits就可以计算得到,但这个时候你还是无法根据这个计算结果来评判网站的信息架构到底是好是坏,因为还缺少一个基准线(Benchmark)或 者说是评判标准。在Google Analytics上面的Visitors标签下,提供了“Sites of similar size”的基 准比较(Benchmarking),你可以选择与你的网站相似类型的网站作为基准线进行数据比 较,这的确是个很好的参考,因为通过比较能够更加明确你的网站在同类型网站中的优势和劣势,为网站优化指明方向。GA借助其强大的数据平台可以为我们提供 基准线,但也许对于上面这个例子会显得无能为力,这个时候需要我们理性地自己去选择一个合适的基准线,比如我的博客目前类目和内容都还比较少,那么我可能 会定义我的网站的迷失用户比例应该控制在1%以下;但如果对于一个应用和内容比较复杂的网站,那么基准线显然会需要定得更高一点。一旦某段时间的数据越过 了基准线,就需要关注一下网站的信息架构是不是在趋于混乱了,是不是该进行一下整理和优化了。

总之,一个好的信息架构能够帮助用户更容易地找到他们需要的信息,从而有效地提升网站的用户体验,所以,尝试着去优化下你的网站的信息架构。如果你 有更好的方法能够有效地检验网站的信息架构的优劣,或者能够明确地分析得到网站信息架构的哪些细节上存在缺陷,希望能与我交流,我期待网站分析方法在优化 网站信息架构方面的更多的应用。

原文来自:《优 化网站信息架构》。

不过,如果你看过《胜于言传》这本书,其实就会发现,上面的内容和该书有一点雷同,只是胜一书中讲的更多的是如何改善用户体验,让用户看到更多的东西(指有效内容),如果你没有读过,还真是推荐看一下的。点击进入当当书店选购该书。

该书在当当中可是没有差评的,书的简介也真的很简单:

无论是居家还是办公,只要是在网上,我们通常都想快速地获取和使用信息。我们上网不是为了寻求某些问题的答案,就是为了完成某些任务——搜集信息、只阅读 我们需要的内容。我们都很忙.根本没有时间阅读网站中的太多内容。
本书会帮你为网站用户成功地撰写内容。它为网站内容的创建和修改提供了相应的策略、流程和方法。它有助于你对网站内容进行规划,组织、撰写、设计和测试, 从而吸引用户不断地光顾你的网站。
Ginny Redish大师介绍了如何创建有用、可用的网站内容。Ginny大师曾指导过许多写作人员、信息设计人员和内容负责人员,向他们传授过编写网站的原则和 秘诀。帮助他们创建了易于浏览、易于阅读且易于使用的网站信息。
这本具有实践性和教育性的书籍可以帮助所有创建网站内容的人更出色地完成他们的工作。
本书特色:
·全书用全彩图和来自真实网站的例子 清晰地阐述了内容编写原则。
·实例中带有改进前后的对比效果,写作的风格简明易读。
·包含针对网络版新闻稿、网络版法律声明和网 络版其他文档的具体原则。
·为了让有特殊需求的人们也可以使用网站,介绍了相关的编写技巧。

如果真想把内容当成主打对象,这本书还是值得购买的。
又是Firefox优化:speedyfox

又是Firefox优化:speedyfox

对firefox不停的在做优化,因为。。。实在没办法了,插件一多,FF吃内存就厉害多了。所以就在不停的想法办法。比如我把内存虚拟出128Mramdisk出来。把firefox的cache目录设进去。然后又发现,还有这个软件,可以把firefox使用到的sqlite进行一下优化(我没明白优化啥,难道是象mysql的碎片整理?)不过,不管它,先用一下下喽。。。
e78d7e7712a0d7e35ab94313ecf09098
官方认为:The method used in SpeedyFox is 100% safe for your profile (e.g. bookmars, passwords, etc), it's well documented and tested on many computers.灰常安全。。
96c28a926c4af5ea02e91db938ed8485
看了上面这张图,我基本确认应该是碎片整理,以及(可能)清空了一些已经废弃的数据。

[转]Firefox的优化技巧

[转]Firefox的优化技巧

这是一些优化firefox的奇技淫巧之一,我也是转载来的。
firefox是我最常用的浏览器(没有之一,最常用的就是它,没有其他的),从开机到关机,浏览器都在运行。除非是addon updater后的重启或者我新装了add-on后的重启,其他时间,就一直开着。
家里的笔记本还好,4G内存,随便我挥霍,单位只有2G,经常会发现FF占了4~500M左右的内存。所以当有个优化技巧在我面前时,我还得选择了尝试。目前尚未看出效果,估计时间还短效果还没有出来。

OK,打开你的Firefox,在地址栏内键入 about:config

在页面的 filter 栏内输入 network
找到network.http.pipelining 这一项,把值设为 True
找到network.http.piplining.maxrequest这一项,把值改为10。

这是因为很多浏览器的默认设置都是依照拨号上网的情况来设置的,所以在现在的宽带时代,它们的潜力并没有被挖掘出来
查找 browser.cache.disk.parent_directory
如果没有找到 browser.cache.disk.parent_directory ,则新建这个“字符串”
修改到你需要存放的位置,例如我修改到RamDisk位置 x:\firefox
在地址栏输入 about:cache ,可以发现Cache位置已经成功修改
查找 config.trim_on_minimize
如果没有找到 config.trim_on_minimize ,则新建这个“布尔”
设置为true——好处:在最小化时自动释放内存
查找 browser.cache.memory.capacity
如果没有找到 browser.cache.memory.capacity ,则新建这个“整数”
设置为固定值16384——好处:据说是最优化的大小
查 找 browser.sessionhistory.max_total_viewers
如 果没有找到 browser.sessionhistory.max_total_viewers ,则新建这个“整数”
设置为固定值5或者更小 ——好处:页面快进/快退功能中保存的页面总数,默 认是-1(无限)
查 找 network.prefetch-next
如 果没有找到 network.prefetch-next ,则新建这个“布尔”
设置为固定值false——好处:关闭预读取网页的功能

转帖的来源:

http://blog.sunshow.net/2007/02/%E8%BD%AC%E8%BD%BD%E4%BC%98%E5%8C%96firefox%E7%9A%84%E6%96%B9%E6%B3%95/

http://blog.sunshow.net/2006/12/%E8%BD%AC%E8%BD%BD%E8%AE%A9%E4%BD%A0%E7%9A%84firefox%E5%92%8Cie%E8%B7%91%E7%9A%84%E6%9B%B4%E5%BF%AB/

Yahoo优化网站策略

Yahoo优化网站策略

Yslow是所有使用firefox的用户都应该安装的插件之一吧。最早,yahoo把网站优化的14条策略放在程序里,就以此来测试,后来根据小说《第二十二条军规》,增加到了22条,如今,它已经拥有34条策略了。
帕兰映像上有了翻译,我就不客气的转载了。毕竟让我翻译的,恐怕到明年我都翻译不出来。哈哈

原文来自帕兰映像:http://paranimage.com/yahoo-given-34-web-acceleration/

Yahoo给出的包括Yslow规则(22条)的34条 详细说明 ,通过这此规则对自己页面进行一次全面的分析优化,可以提高你网站的加载速度。

1.Minimize HTTP Requests 减少HTTP请求

图片、CSS、script、flash等等这些都会增加http请求数,减少这些元素的数量就能减少响应时间。把多个JS、CSS在可能的情况下写进一个文件,页面里直接写入图片也是不好的做法,应该写进CSS里,利用 CSS sprites 将小图拼合后利用background来定位。

2.Use a Content Delivery Network 利用CDN技术

CDN 确实是好东西,8过服务器提供商的这项服务一般是要收费的,我以前买的国内空间是有这个的但是我当时根本不知道啥用,现在没了。。。

3.Add an Expires or a Cache-Control Header 设置头文件过期或者静态缓存

浏览器会用缓存来减少http请求数来加快页面加载的时间,如果页面头部加一个很长的过期时间,浏览器就会一直缓存页面里的元素。不过这样如果页面里的东西变动的话就要改名字了,否则用户端不会主动刷新,看自己衡量了~ 这项可以通过修改.htaccess文件来实现。

4.Gzip Components Gzip压缩

Gzip格式是一种很普遍的压缩技术,几乎所有的浏览器都有解压Gzip格式的能力,而且它可以压缩的比例非常大,一般压缩率为85%。压缩没压缩,可以到 这里 做下测试。

5.Put Stylesheets at the Top 把CSS放顶部

让浏览者能尽早的看到网站的完整样式。

6.Put Scripts at the Bottom 把JS放底部

网站呈现完毕后再进行功能设置,当然这些JS要在你的加载过程中不影响内容表现。

7.Avoid CSS Expressions 避免CSS Expressions

CSS表达式很可怕,这个只被IE支持的东西执行时候的运算量非常大,你移动一下鼠标它都要进行重计算的,但有时候为了做浏览器的兼容必须要用到这个||| IE6去死去死!~

8.Make JavaScript and CSS External 将JS和CSS外链

前面讲到了缓存这个事情,一些较为公用的JS和CSS,我们可以使用外链的形式,譬如我就是从Google外链来的Jquery文件,如果我的浏览者在浏览别的使用了这个外链文件的网站时已经下载并缓存了这个文件,那么他在浏览我的网站的时候就不需要再进行下载了!~

9.Reduce DNS Lookups 减少DNS查找

貌似是要减少网站从外部调用资源,我的Google分析和picasa的外链图片都算在里面了。

10.Minify JavaScript and CSS 减小JS和CSS的体积

写JS和CSS都是有技巧的,用最少的代码实现同样的功能,减少空白,增强逻辑性,用缩写方式等等,当然也有不少工具也能够帮你实现这一点。

11. Avoid Redirects 避免重定向

再写入链接时,虽然“http://www. today-s-ooxx. com”和“http://www. today-s-ooxx. com/” 仅有一个最后的“/”只差,但是结果是不同的,服务器需要花时间把前者重定向为后者然后进行跳转,这个要自己注意,也可以在Apache里用Alias 或者mod_rewrite或者DirectorySlash解决。

12. Remove Duplicate Scripts 删除重复脚本

重复调用的代码浏览器并不会识别忽略,而是会再次运算一遍,这当然是大大的浪费。

13. Configure ETags 配置ETags

搞不清楚咋回事,总之我是在. htaccess里把它删除了。

14. Make Ajax Cacheable 缓存Ajax

Ajax是实时响应的,在浏览器接收到新的数据前,旧的数据被缓存,这样能够更好的提高效率。

15. Flush the Buffer Early 尽早的释放缓冲

当用户进行页面请求时,服务器端需要花费200到500毫秒时间来拼合HTML,将写在head与body之间,释放缓冲,这样可以将文件头先发送出去,然后再发送文件内容,提高效率。

16. Use GET for AJAX Requests 用GET方式进行AJAX请求

Get 方法和服务器只有一次交互(发送数据),而 Post 要两次(发送头部再发送数据)。

17. Post-load Components 延迟加载组件

最先加载必须的组件进行页面初始化,然后再加载其他,YUI Image Loader 是很好的例子。

18. Preload components 预加载组件

提前加载以后可能用到的东西,和延迟加载并不冲突,它的目的是为后续请求提供更快的响应,参见Google首页上的CSS sprites应用。

19. Reduce the Number of DOM Elements 减少DOM元素数量

复杂的页面结构意味着更长的下载及响应时间,更合理更高效的使用标签来架构页面,是好的前端的必备条件。

20. Split Components Across Domains 跨域分离组件

页面组件多个来源可以增大你的平行下载量,但注意不要过多,超过2-4个域名会引起上面说到的DNS查找浪费。

21. Minimize the Number of iframes 减少iframe数量

需要更有效的利用 ifames。
iframe 优点:有利于下载缓慢的广告等第三方内容,安全沙箱,并行下载脚本
iframe 缺点:即使为空也会有较大资源消耗,会阻止页面的onload,非语义

22. No 404s 不要出现404页面

站点本身里(非搜索结果)出现404页面,无意义的404页面会影响用户体验并且会消耗服务器资源。

23. Reduce Cookie Size 减小Cookie

Cookie在服务器及浏览器之间的通过文件头进行交换,尽可能减小Cookie体积,设置合理的过期时间,能够很好的提高效率。

24. Use Cookie-free Domains for Components 对组件使用无Cookie的域名

对静态组件的Cookie读取是一种浪费,使用另一个无Cookie的域名来存放你的静态组件式一个好方法,或者也可以在Cookie中只存放带www的域名。

25. Minimize DOM Access 减少DOM的访问次数

JS访问DOM是很慢的,尽量不要用JS来设置页面布局。

26. Develop Smart Event Handlers 开发灵活的事件处理句柄

DOM树上过多的元素被加入事件句柄的话,反应效率肯定会低,YUI事件工具有一个 onAvailable 方法可以帮助你灵活的设置DOM事件句柄

27. Choose < link >over @import 使用< link >而非 @import

在IE中使用@import就和在页面底部用< link >一样,我们前面说要把< link >放顶部的。

28. Avoid Filters 避免过滤器的使用

如果需要Alpha透明,不要使用AlphaImageLoader,它效率低下而且只对IE6及以下的版本适用,用PNG8图片。如果你非要使用,加上_filter以免影响IE7+用户。

29. Optimize Images 优化图片

将你的GIF转为PNG8会是个减小体积的好办法,另外有很多方法处理你的JPG及PNG图片以达到优化效果。

30. Optimize CSS Sprites 优化CSS Sprites

在CSS Sprites中竖直并尽量紧凑的排列图片,尽量将颜色相似的图片排在一起,会减小图片本身的大小及提高页面图片显示速度。

31. Don’t Scale Images in HTML 不要在HTML中缩放图片

图片要用多大的就用多大的,1000X1000的图片被width=”100″ height=”100″以后,本身的KB数是不会减少的。

32. Make favicon. ico Small and Cacheable 缩小favicon. ico的大小并缓存它

站点的浏览器ICO应该不是经常换吧,那就长时间的缓存它,并且最好控制在1K以下。

33. Keep Components under 25K 保证组件在25K以下

iPhone不能缓存25K以上的组件,并且这还是要在被压缩前。

34. Pack Components into a Multipart Document 将组件打包进一个多部分的文档中

就好像在邮件中加入附件一样,一个HTTP请求就够了,但是这一技术需要确保你的代理支持,iPhone就不支持。

Wordpress MYSQL数据库优化技巧

Wordpress MYSQL数据库优化技巧

一直在考虑是不是要换到wordpress, sablog用了这么长时间,也算是有感情了的。只是,他一直不更新,而且前台模板用的那种定界符做模板处理,我很不习惯。
以前coolcode.cn也是用的wordpress,后来转到了sablog上面。如今,我却想转到wordpress上面。。。不知道是进步还是退步。

也曾想过重写前台,请了两个朋友帮我做页面,结果现在是程序写了一半,页面做了一半,离完成看来是遥遥无期了。。

所以,记录下这个文章,方便以后真的要转换的时候,也能做个参考。。

原文地址:http://www.phpweblog.net/haix/archive/2009/07/20/6769.html,作者是haix
内容如下:
WordPress系统使用时间长了,数据库中的冗余数据就会很多,定期优化和清理Wordpress的数据库,可以保证Wordpress能够快速工作。

  首先,停用一些无用的插件,将WordPress系统表之外的数据表都删除,只保留wp_posts, wp_comments, wp_terms, wp_term_relationships, wp_term_taxonomy 等系统数据表。

  其次,打开phpMyadmin,通过SQL语句进行冗余数据删除操作。删除前记得先备份一下。

  删除脚本是:

  DELETE FROM wp_posts WHERE post_type = 'revision';

  DELETE FROM wp_postmeta WHERE meta_key = '_edit_lock';

  DELETE FROM wp_postmeta WHERE meta_key = '_edit_last';

  最后,在phpMyAdmin中,选中所有表,点“优化表”。

  经过这一番优化操作,就可以将WordPress数据库中的冗余数据删除,优化了数据库的性能。

以上操作,需要用户懂一些SQL语句,不要进行误操作,如果用户SQL比较熟的话,还可以看看这篇文章

八个有用的WordPress的SQL语句

在过去的十年中,MySQL已经成为广受欢迎的数据库,而WordPress博客使用的是MySQL数据库,虽然使用插件可以解决一些问题,但是实 现某些特殊任务的时候,在phpMyAdmin中执行SQL语句是最简洁的方法,这里就总结八个有用的WordPress系统的SQL语句,用于解决一些 实际碰到的问题。

   1、创建备份数据库

  备份数据库是首先要做的事情,只需要通过以下方法就可以简单备份数据库:

  登录phpMyAdmin后。选择你的WordPress数据库,然后点击“导出”按钮,选择一种压缩方式(可以使用gzip)并单击“执行”按钮,当浏览器提示是否下载的时候,点“是”,将数据库文件下载到本地。

   2、批量删除文章修订

  WordPress2.6以后的版本增加了一个Post revisions功能,虽然有点用,但文章修订增加了你数据库的大小,我们可以选择批量删除。

  登录phpMyAdmin后执行下面的SQL语句即可批量删除。

DELETE FROM wp_posts WHERE post_type = "revision";

   3、批量删除垃圾评论

  一个真实的故事是,我的一个朋友在网上建立了一个博客,有次他花了几天时间外出度假,没有上网,当他回来的时候,登录自己的博客,看到有5000多条评论等待审核,当然,大多数都是垃圾评论,要手动删除这些评论要花大量时间,因此我们可以使用以下办法。

  登录phpMyAdmin后执行下面的SQL语句。

DELETE from wp_comments WHERE comment_approved = '0';

  要小心,虽然这种解决方案对于处理数百万的垃圾平邮非常有用,但是也会清除未经批准的评论,因此最好还是安装使用Akismet来对付垃圾评论。

   4、修改文章属性

  你安装WordPress后,admin账户就创建了,不少人都错误的使用这个帐号来写博客,直到他们认识到,这并不是个人帐号。

  解决的方法,每篇文章修改作者属性需要大量的时间,下面的这个SQL语句可以帮你快速完成这个功能。

  首先你要找到你正确的用户名,使用下面的SQL语句可以找到你的用户ID号。

SELECT ID, display_name FROM wp_users;

  假设这个ID为NEW_AUTHOR_ID,而管理员admin的ID为OLD_AUTHOR_ID,接着,运行下面的SQL语句。

UPDATE wp_posts SET post_author=NEW_AUTHOR_ID WHERE post_author=OLD_AUTHOR_ID;

   5、手动重设密码

  很多人为了保护自己的博客不被人黑掉,使用了很复杂的密码,这虽然是一件好事,但也经常会发生遗忘管理员密码的事情。

  当然,通过电子邮件可以发送给你WordPress重设密码的链接,但如果你无法访问你的邮件地址,那么就只好使用下面的SQL语句来重设你的密码了。

UPDATE wp_users SET user_pass = MD5('PASSWORD') WHERE wp_users.user_login ='admin' LIMIT 1;

  MD5是MySQL内置的哈希函数,用于将密码转换为散列值。

   6、更改WordPress的域名

  你可能有时候会想要更改你博客的域名,但是WordPress会将你的域名存储在数据库中,因此你要使用下面的SQL语句来修改。

UPDATE wp_options SET option_value = replace(option_value, 'http://www.oldsite.com', 'http://www.newsite.com') WHERE option_name = 'home' OR option_name = 'siteurl';

  接着,你还要使用下面的SQL将文章的GUID也进行修改。

UPDATE wp_posts SET guid = replace(guid, 'http://www.oldsite.com','http://www.newsite.com');

  最后,使用下面的语句将文章里所有旧域名替换为新域名。

UPDATE wp_posts SET post_content = replace(post_content, 'http://www.oldsite.com', 'http://www.newsite.com');

   7、显示SQL查询数量

  在你有话博客性能的时候,了解到查询数据库的数量是非常重要的,为了减少数据库查询,我们需要知道在一个页面上到底有多少个查询。

  这一次,不需要登录phpMyAdmin了,你只需要修改footer.php文件,在文件结尾增加下面几行代码即可。

<?php if (is_user_logged_in()) { ?>
<?php echo get_num_queries(); ?> queries in <?php timer_stop(1); ?> seconds.
<?php } ?>

   8、恢复你的WordPress数据库

  当你的数据库因为某些原因(黑客或者升级错误)被损坏或者丢失了,如果你有备份的话,那可以恢复你的WordPress数据库。

  登录phpMyAdmin,选择你的WordPress数据库,点“导入”按钮,点“浏览”按钮,然后从你的硬盘选择备份文件,点“执行”按钮就可以将数据库导入。

  如果顺利的话,你的WordPress功能将会恢复正常。


来源月光博客:

mysql性能的检查和优化方法

mysql性能的检查和优化方法

原文地址:http://www.artbeta.com/bbs/thread-817-1-1.html

mysql在遇到严重性能问题时,一般都有这么几种可能:
1、索引没有建好;
2、sql写法过于复杂;
3、配置错误;
4、机器实在负荷不了;
1、索引没有建好
如果看到mysql消耗的cpu很大,可以用mysql的client工具来检查。
在linux下执行
/usr/local/mysql/bin/mysql -hlocalhost -uroot -p
输入密码,如果没有密码,则不用-p参数就可以进到客户端界面中。
看看当前的运行情况
show full processlist
可以多运行几次
这个命令可以看到当前正在执行的sql语句,它会告知执行的sql、数据库名、执行的状态、来自的客户端ip、所使用的帐号、运行时间等信息
在我的cache后端,这里面大部分时间是看不到显示任何sql语句的,我认为这样才算比较正常。如果看到有很多sql语句,那么这台mysql就一定会有性能问题
如果出现了性能问题,则可以进行分析:
1、是不是有sql语句卡住了?
这是出现比较多的情况,如果数据库是采用myisam,那么有可能有一个写入的线程会把数据表给锁定了,如果这条语句不结束,则其它语句也无法运行。
查看processlist里的time这一项,看看有没有执行时间很长的语句,要留意这些语句。
2、大量相同的sql语句正在执行
如果出现这种情况,则有可能是该sql语句执行的效率低下,同样要留意这些语句。
然后把你所怀疑的语句统统集合一下,用desc(explain)来检查这些语句。
首先看看一个正常的desc输出:
mysql> desc select * from imgs where imgid=1651768337;
+----+-------------+-------+-------+---------------+---------+---------+-------+------+-------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+-------+---------------+---------+---------+-------+------+-------+
| 1 | SIMPLE | imgs | const | PRIMARY | PRIMARY | 8 | const | 1 | |
+----+-------------+-------+-------+---------------+---------+---------+-------+------+-------+
1 row in set (0.00 sec)
注意key、rows和Extra这三项,这条语句返回的结果说明了该sql会使用PRIMARY主键索引来查询,结果集数量为1条,Extra没有显 示,证明没有用到排序或其他操作。由此结果可以推断,mysql会从索引中查询imgid=1651768337这条记录,然后再到真实表中取出所有字 段,是很简单的操作。
key是指明当前sql会使用的索引,mysql执行一条简单语句时只能使用到一条索引,注意这个限制;rows是返回的结果集大小,结果集就是使用该索引进行一次搜索的所有匹配结果;Extra一般会显示查询和排序的方式,。
如果没有使用到key,或者rows很大而用到了filesort排序,一般都会影响到效率,例如:
mysql> desc select * from imgs where userid="7mini" order by clicks desc limit 10;
+----+-------------+-------+------+---------------+------+---------+------+-------+-----------------------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+------+---------------+------+---------+------+-------+-----------------------------+
| 1 | SIMPLE | imgs | ALL | NULL | NULL | NULL | NULL | 12506 | Using where; Using filesort |
+----+-------------+-------+------+---------------+------+---------+------+-------+-----------------------------+
1 row in set (0.00 sec)
这条sql结果集会有12506条,用到了filesort,所以执行起来会非常消耗效率的。这时mysql执行时会把整个表扫描一遍,一条一条去找到匹 配userid="7mini"的记录,然后还要对这些记录的clicks进行一次排序,效率可想而知。真实执行时如果发现还比较快的话,那是因为服务器 内存还足够将12506条比较短小的记录全部读入内存,所以还比较快,但是并发多起来或者表大起来的话,效率问题就严重了。
这时我把userid加入索引:
create index userid on imgs (userid);
然后再检查:
mysql> desc select * from imgs where userid="7mini" order by clicks desc limit 10;
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| 1 | SIMPLE | imgs | ref | userid | userid | 51 | const | 8 | Using where; Using filesort |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
1 row in set (0.00 sec)
嗯,这时可以看到mysql使用了userid这个索引搜索了,用userid索引一次搜索后,结果集有8条。然后虽然使用了filesort一条一条排序,但是因为结果集只有区区8条,效率问题得以缓解。
但是,如果我用别的userid查询,结果又会有所不同:
mysql> desc select * from imgs where userid="admin" order by clicks desc limit 10;
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| 1 | SIMPLE | imgs | ref | userid | userid | 51 | const | 2944 | Using where; Using filesort |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
1 row in set (0.00 sec)
这个结果和userid="7mini"的结果基本相同,但是mysql用userid索引一次搜索后结果集的大小达到2944条,这2944条记录都会 加入内存进行filesort,效率比起7mini那次来说就差很多了。这时可以有两种办法可以解决,第一种办法是再加一个索引和判断条件,因为我只需要 根据点击量取最大的10条数据,所以有很多数据我根本不需要加进来排序,比如点击量小于10的,这些数据可能占了很大部分。
我对clicks加一个索引,然后加入一个where条件再查询:
create index clicks on imgs(clicks);
mysql> desc select * from imgs where userid="admin" order by clicks desc limit 10;
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
| 1 | SIMPLE | imgs | ref | userid,clicks | userid | 51 | const | 2944 | Using where; Using filesort |
+----+-------------+-------+------+---------------+--------+---------+-------+------+-----------------------------+
1 row in set (0.00 sec)
这时可以看到possible_keys变成了userid,clicks,possible_keys是可以匹配的所有索引,mysql会从 possible_keys中自己判断并取用其中一个索引来执行语句,值得注意的是,mysql取用的这个索引未必是最优化的。这次查询mysql还是使 用userid这个索引来查询的,并没有按照我的意愿,所以结果还是没有什么变化。改一下sql加上use index强制mysql使用clicks索引:
mysql> desc select * from imgs use index (clicks) where userid='admin' and clicks>10 order by clicks desc limit 10
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
| 1 | SIMPLE | imgs | range | clicks | clicks | 4 | NULL | 5455 | Using where |
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
1 row in set (0.00 sec)
这时mysql用到了clicks索引进行查询,但是结果集比userid还要大!看来还要再进行限制:
mysql> desc select * from imgs use index (clicks) where userid='admin' and clicks>1000 order by clicks desc limit 10
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
| 1 | SIMPLE | imgs | range | clicks | clicks | 4 | NULL | 312 | Using where |
+----+-------------+-------+-------+---------------+--------+---------+------+------+-------------+
1 row in set (0.00 sec)
加到1000的时候结果集变成了312条,排序效率应该是可以接受。
不过,采用换索引这种优化方式需要取一个采样点,比如这个例子中的1000这个数字,这样,对userid的每个数值,都要去找一个采样点,这样对程序来 说是很难办的。如果按1000取样的话,那么userid='7mini'这个例子中,取到的结果将不会是8条,而是2条,给用户造成了困惑。
当然还有另一种办法,加入双索引:
create index userid_clicks on imgs (userid, clicks)
mysql> desc select * from imgs where userid="admin" order by clicks desc limit 10;
+----+-------------+-------+------+----------------------+---------------+---------+-------+------+-------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+----+-------------+-------+------+----------------------+---------------+---------+-------+------+-------------+
| 1 | SIMPLE | imgs | ref | userid,userid_clicks | userid_clicks | 51 | const | 2944 | Using where |
+----+-------------+-------+------+----------------------+---------------+---------+-------+------+-------------+
1 row in set (0.00 sec)
这时可以看到,结果集还是2944条,但是Extra中的filesort不见了。这时mysql使用userid_clicks这个索引去查询,这不但 能快速查询到userid="admin"的所有记录,并且结果是根据clicks排好序的!所以不用再把这个结果集读入内存一条一条排序了,效率上会高 很多。
但是用多字段索引这种方式有个问题,如果查询的sql种类很多的话,就得好好规划一下了,否则索引会建得非常多,不但会影响到数据insert和update的效率,而且数据表也容易损坏。
以上是对索引优化的办法,因为原因可能会比较复杂,所以写得比较的长,一般好好优化了索引之后,mysql的效率会提升n个档次,从而也不需要考虑增加机器来解决问题了。
但是,mysql甚至所有数据库,可能都不好解决limit的问题。在mysql中,limit 0,10只要索引合适,是没有问题的,但是limit 100000,10就会很慢了,因为mysql会扫描排好序的结果,然后找到100000这个点,取出10条返回。要找到100000这个点,就要扫描 100000条记录,这个循环是比较耗时的。不知道会不会有什么好的算法可以优化这个扫描引擎,我冥思苦想也想不出有什么好办法。对于limit,目前直 至比较久远的将来,我想只能通过业务、程序和数据表的规划来优化,我想到的这些优化办法也都还没有一个是万全之策,往后再讨论。
2、sql写法过于复杂
sql写法假如用到一些特殊的功能,比如groupby、或者多表联合查询的话,mysql用到什么方式来查询也可以用desc来分析,我这边用复杂sql的情况还不算多,所以不常分析,暂时就没有好的建议。
3、配置错误
配置里主要参数是key_buffer、sort_buffer_size/myisam_sort_buffer_size,这两个参数意思是:
key_buffer=128M:全部表的索引都会尽可能放在这块内存区域内,索引比较大的话就开稍大点都可以,我一般设为128M,有个好的建议是把很少用到并且比较大的表想办法移到别的地方去,这样可以显著减少mysql的内存占用。
sort_buffer_size=1M:单个线程使用的用于排序的内存,查询结果集都会放进这内存里,如果比较小,mysql会多放几次,所以稍微开大一点就可以了,重要是优化好索引和查询语句,让他们不要生成太大的结果集。
另外一些配置:
thread_concurrency=8:这个配置标配=cpu数量x2
interactive_timeout=30
wait_timeout=30:这两个配置使用10-30秒就可以了,这样会尽快地释放内存资源,注意:一直在使用的连接是不会断掉的,这个配置只是断掉了长时间不动的连接。
query_cache:这个功能不要使用,现在很多人看到cache这几个字母就像看到了宝贝,这是不唯物主义的。mysql的query_cache 在每次表数据有变化的时候都会重新清理连至该表的所有缓存,如果更新比较频繁,query_cache不但帮不上忙,而且还会对效率影响很大。这个参数只 适合只读型的数据库,如果非要用,也只能用query_cache_type=2自行用SQL_CACHE指定一些sql进行缓存。
max_connections:默认为100,一般情况下是足够用的,但是一般要开大一点,开到400-600就可以了,能超过600的话一般就有效率问题,得另找对策,光靠增加这个数字不是办法。
其它配置可以按默认就可以了,个人觉得问题还不是那么的大,提醒一下:1、配置虽然很重要,但是在绝大部分情况下都不是效率问题的罪魁祸首。2、mysql是一个数据库,对于数据库最重要考究的不应是效率,而是稳定性和数据准确性。
4、机器实在负荷不了
如果做了以上调整,服务器还是不能承受,那就只能通过架构级调整来优化了。
1、mysql同步。
通过mysql同步功能将数据同步到数台从数据库,由主数据库写入,从数据库提供读取。
我个人不是那么乐意使用mysql同步,因为这个办法会增加程序的复杂性,并常常会引起数据方面的错误。在高负荷的服务中,死机了还可以快速重启,但数据错误的话要恢复就比较麻烦。
2、加入缓存
加入缓存之后,就可以解决并发的问题,效果很明显。如果是实时系统,可以考虑用刷新缓存方式使缓存保持最新。
在前端加入squid的架构比较提倡使用,在命中率比较高的应用中,基本上可以解决问题。
如果是在程序逻辑层里面进行缓存,会增加很多复杂性,问题会比较多而且难解决,不建议在这一层面进行调整。
3、程序架构调整,支持同时连接多个数据库
如果web加入缓存后问题还是比较严重,只能通过程序架构调整,把应用拆散,用多台的机器同时提供服务。
如果拆散的话,对业务是有少许影响,如果业务当中有部分功能必须使用所有的数据,可以用一个完整库+n个分散库这样的架构,每次修改都在完整库和分散库各操作一次,或定期整理完整库。
当然,还有一种最笨的,把数据库整个完完整整的做拷贝,然后程序每次都把完整的sql在这些库执行一遍,访问时轮询访问,我认为这样要比mysql同步的方式安全。
4、使用 mysql proxy 代理
mysql proxy 可以通过代理把数据库中的各个表分散到数台服务器,但是它的问题是没有能解决热门表的问题,如果热门内容散在多个表中,用这个办法是比较轻松就能解决问题。
我没有用过这个软件也没有认真查过,不过我对它的功能有一点点怀疑,就是它怎么实现多个表之间的联合查询?如果能实现,那么效率如何呢?
5、使用memcachedb
数据库换用支持mysql的memcachedb,是可以一试的想法,从memcachedb的实现方式和层面来看对数据没有什么影响,不会对用户有什么困扰。
为我现在因为数据库方面问题不多,没有试验过这个玩意。不过,只要它支持mysql的大部分主要的语法,而且本身稳定,可用性是无需置疑的。

php优化:apc缓存

APC其实是PHP5自带的东西,只需要把xxx.dll前的注释去掉就可以用了,不象其他的加速 ,还需要装软件,什么xCache啦,eacceraltor之类的,都需要额外编译好之后放到扩展目录下才行(当然我说的是windows下面的,linux下面就不太一样了)

既然是自带的,又这么好,总要有个介绍的吧?

原文:http://blog.goguoguo.com/html/y2009/311.html

作者:土 豆

先说说php程序的执行流程吧,说明了这个,才好开始我们的优化之旅。

客户端(譬如浏览器)
—》请求Get hello.php
—-》cgi服务器接(譬如apache)收到请求,根据配置寻找php的处理程序(譬如mod_php)
—-》apache加载php的处理程序,php的处理程序读取php.ini初始化php的解释环境
—-》mod_php定位寻找hell.php,将其载入到内存中来
—-》mod_php编译源代码成为opcode树
—-》mod_php执行opcode树
—-》生成结果给浏览器

在这个过程中我们有哪些地方可以优化呢:
1 将mod_php fast-cgi化,避免每次都要加载这个模块,这个模块还要每次都去初始化php的解释环境
2 缓存php文件的opcode码,这样话,避免每次都去编译。

缓存opcode码有很多软件,apc、以及zend提供的cache等。
转载一个apc的配置和使用:

Alternative PHP Cache(APC)是 PHP 的一个免费公开的优化代码缓存。它用来提供免费,公开并且强健的架构来缓存和优化 PHP 的中间代码。

在 Windows 下,APC 要求有 c:\tmp 目录,并且该目录要对 Web 服务器进程可写。

1. 安装:

以PHP extension 形式安装.

2. 配置
apc.enabled boolean
apc.optimization optimization
选项在脚本中可以改变

APC PHP.ini配置选项详解

[APC]
; Alternative PHP Cache 用于缓存和优化PHP中间代码

apc.cache_by_default = On
;SYS
; 是否默认对所有文件启用缓冲。
; 若设为Off并与以加号开头的apc.filters指令一起用,则文件仅在匹配过滤器时才被缓存。

apc.enable_cli = Off
;SYS
; 是否为CLI版本启用APC功能,仅用于测试和调试目的才打开此指令。

apc.enabled = On
; 是否启用APC,如果APC被静态编译进PHP又想禁用它,这是唯一的办法。

apc.file_update_protection = 2
;SYS
; 当你在一个运行中的服务器上修改文件时,你应当执行原子操作。
; 也就是先写进一个临时文件,然后将该文件重命名(mv)到最终的名字。
; 文本编辑器以及 cp, tar 等程序却并不是这样操作的,从而导致有可能缓冲了残缺的文件。
; 默认值 2 表示在访问文件时如果发现修改时间距离访问时间小于 2 秒则不做缓冲。
; 那个不幸的访问者可能得到残缺的内容,但是这种坏影响却不会通过缓存扩大化。
; 如果你能确保所有的更新操作都是原子操作,那么可以用 0 关闭此特性。
; 如果你的系统由于大量的IO操作导致更新缓慢,你就需要增大此值。

apc.filters =
;SYS
; 一个以逗号分隔的POSIX扩展正则表达式列表。
; 如果源文件名与任意一个模式匹配,则该文件不被缓存。
; 注意,用来匹配的文件名是传递给include/require的文件名,而不是绝对路径。
; 如果正则表达式的第一个字符是”+”则意味着任何匹配表达式的文件会被缓存,
; 如果第一个字符是”-”则任何匹配项都不会被缓存。”-”是默认值,可以省略掉。

apc.ttl = 0
;SYS
; 缓存条目在缓冲区中允许逗留的秒数。0 表示永不超时。建议值为7200~36000。
; 设为 0 意味着缓冲区有可能被旧的缓存条目填满,从而导致无法缓存新条目。

apc.user_ttl = 0
;SYS
; 类似于apc.ttl,只是针对每个用户而言,建议值为7200~36000。
; 设为 0 意味着缓冲区有可能被旧的缓存条目填满,从而导致无法缓存新条目。

apc.gc_ttl = 3600
;SYS
; 缓存条目在垃圾回收表中能够存在的秒数。
; 此值提供了一个安全措施,即使一个服务器进程在执行缓存的源文件时崩溃,
; 而且该源文件已经被修改,为旧版本分配的内存也不会被回收,直到达到此TTL值为止。
; 设为零将禁用此特性。

apc.include_once_override = Off
;SYS
; 关于该指令目前尚无说明文档,参见:http://pecl.php.net/bugs/bug.php?id=8754
; 请保持为Off,否则可能导致意想不到的结果。

apc.max_file_size = 1M
;SYS
; 禁止大于此尺寸的文件被缓存。

apc.mmap_file_mask =
;SYS
; 如果使用–enable-mmap(默认启用)为APC编译了MMAP支持,
; 这里的值就是传递给mmap模块的mktemp风格的文件掩码(建议值为”/tmp/apc.XXXXXX”)。
; 该掩码用于决定内存映射区域是否要被file-backed或者shared memory backed。
; 对于直接的file-backed内存映射,要设置成”/tmp/apc.XXXXXX”的样子(恰好6个X)。
; 要使用POSIX风格的shm_open/mmap就需要设置成”/apc.shm.XXXXXX”的样子。
; 你还可以设为”/dev/zero”来为匿名映射的内存使用内核的”/dev/zero”接口。
; 不定义此指令则表示强制使用匿名映射。

apc.num_files_hint = 1000
;SYS
; Web服务器上可能被包含或被请求的不同源文件的大致数量(建议值为1024~4096)。
; 如果你不能确定,则设为 0 ;此设定主要用于拥有数千个源文件的站点。

apc.optimization = 0
; 优化级别(建议值为 0 ) 。
; 正整数值表示启用优化器,值越高则使用越激进的优化。
; 更高的值可能有非常有限的速度提升,但目前尚在试验中。

apc.report_autofilter = Off
;SYS
; 是否记录所有由于early/late binding原因而自动未被缓存的脚本。

apc.shm_segments = 1
;SYS
; 为编译器缓冲区分配的共享内存块数量(建议值为1)。
; 如果APC耗尽了共享内存,并且已将apc.shm_size指令设为系统允许的最大值,
; 你可以尝试增大此值。

apc.shm_size = 30
;SYS
; 每个共享内存块的大小(以MB为单位,建议值为128~256)。
; 有些系统(包括大多数BSD变种)默认的共享内存块大小非常少。

apc.slam_defense = 0
;SYS(反对使用该指令,建议该用apc.write_lock指令)
; 在非常繁忙的服务器上,无论是启动服务还是修改文件,
; 都可能由于多个进程企图同时缓存一个文件而导致竞争条件。
; 这个指令用于设置进程在处理未被缓存的文件时跳过缓存步骤的百分率。
; 比如设为75表示在遇到未被缓存的文件时有75%的概率不进行缓存,从而减少碰撞几率。
; 鼓励设为 0 来禁用这个特性。

apc.stat = On
;SYS
; 是否启用脚本更新检查。
; 改变这个指令值要非常小心。
; 默认值 On 表示APC在每次请求脚本时都检查脚本是否被更新,
; 如果被更新则自动重新编译和缓存编译后的内容。但这样做对性能有不利影响。
; 如果设为 Off 则表示不进行检查,从而使性能得到大幅提高。
; 但是为了使更新的内容生效,你必须重启Web服务器。
; 这个指令对于include/require的文件同样有效。但是需要注意的是,
; 如果你使用的是相对路径,APC就必须在每一次include/require时都进行检查以定位文件。
; 而使用绝对路径则可以跳过检查,所以鼓励你使用绝对路径进行include/require操作。

apc.user_entries_hint = 100
;SYS
; 类似于num_files_hint指令,只是针对每个不同用户而言。
; 如果你不能确定,则设为 0 。

apc.write_lock = On
;SYS
; 是否启用写入锁。
; 在非常繁忙的服务器上,无论是启动服务还是修改文件,
; 都可能由于多个进程企图同时缓存一个文件而导致竞争条件。
; 启用该指令可以避免竞争条件的出现。

apc.rfc1867 = Off
;SYS
; 打开该指令后,对于每个恰好在file字段之前含有APC_UPLOAD_PROGRESS字段的上传文件,
; APC都将自动创建一个upload_的用户缓存条目(就是APC_UPLOAD_PROGRESS字段值)。

3. 函数:

apc_cache_info - Retrieves cached information (and meta-data) from APC’s data store
apc_clear_cache - Clears the APC cache
apc_define_constants - Defines a set of constants for later retrieval and mass-definition
apc_delete - Removes a stored variable from the cache
apc_fetch - Fetch a stored variable from the cache
apc_load_constants - Loads a set of constants from the cache
apc_sma_info - Retrieves APC’s Shared Memory Allocation information
apc_store - Cache a variable in the data store

apc的用法比较简单,只有几个函数,列举如下。
apc_cache_info () 返回缓存信息
apc_clear_cache() 清除apc缓存内容。
默认(无参数)时,只清除系统缓存,要清除用户缓存,需用‚user‘参数。
apc_define_constants ( string key, array constants [, bool case_sensitive] ) 将数组constants以常量加入缓存。
apc_load_constants (string Key)。
取出常量缓存。
apc_store ( string key, mixed var [, int ttl] )。
在缓存中保存数据。
apc_fetch ( string key )。
获得apc_store保存的缓存内容
apc_delete ( string key )。
删除apc_store保存的内容。

apc的管理:
到pecl.php.net下载apc源码包有个apc.php,copy到你的web server可以访问到的地方,浏览即可访问。
管理界面功能有:
1. Refresh Data
2. View Host Stats
3. System Cache Entries
4. User Cache Entries
5. Version Check
apc


配置php.ini的时候一定要跟进编译选项来放置这些扩展的位置。
默认apc.so要放到php.ini同一个目录下,而不是传说中的extension目录。

切勿过早优化

切勿过早优化

放在PHP栏目是我仔细想过的,虽然文章内容里并未提及到PHP
开发WEB,很多人在一开始就考虑了优化优化再优化,但是,如果按照你这样的优化下去,当你发现瓶劲的时候你怎么办?你已经无法优化了。。
因此,为自己的代码预留一点优化空间,先赶着把代码上线,然后再边运行边优化。一来也保证了上线的时间,二来也可以在运行时注意到哪些地方是需要重点优化的。

以下内容来自守望轩(博客园)的文章:原文http://www.cnblogs.com/xjb/archive/2009/04/13/no-premature-optimization.html

Donald Knuth说“过早优化是万恶之源”(premature optimization is the root of all evil)。这话也许有些夸张,但“过早优化”的危害我觉得不能忽视。同时,我觉得“过早优化”的概念不专属编写程序,生活中的示例也比比皆是。不信,你看看下面这些情形你是否遇到过:

http://www.watch-life.net/life-thinking/no-premature-optimization.html

1、当你开始学一门程序语言的时候(比如c#),你想如果可以精通开发工具(比如Visual Studio)一定如虎添翼,于是一开始你就花很多时间去研究开发工具,而忘记自己学习的重点是语言本身,而非工具。或者,一开始,你花不少的时间去选择哪门程序语言,比较各种语言的优劣,在五花八门的语言前面犹豫不决,这个想学,那个也不想放弃,结果都是学个半路子。

2、当你学习一门外语比如英语的时候,一开始,你花了很多的时间去下载有关英语资料,花了很多的时间去找英语书籍,以为有了这些资料和书籍就可以学好英文,而不是一开始就踏踏实实的从单词、语法开始,结果后来资料下载了一大堆,书籍买了不少,却没有坚持下去。

3、你想搞体育锻炼,比如打羽毛球,于是一开始你花大量时间去买球衣、球鞋、球拍等装备,可没连几天,你发现自己开始三天打鱼了,最后,那些装备都起了灰,也没锻炼几次。

4、你想做时间管理(Getting Things Done),于是你研究各种时间管理的资料,上各种时间管理技巧的网站,比如lifehack、 digg 、gtdlife,下载对最流行的GTD的管理软件,以节省时间的名义浪费时间,很浮躁,不能做到实实在在把每天的计划都落实,拖拖拉拉。

5、你有没有这样的体验,一本书你总是对开头的部分看的最仔细,后面的章节没坚持看下去,下次又重复这种循环。当你计划做一件事的时候,总是规划的 非常完美,几乎考虑每个细节,但却没有认认真真、一步一步执行,或者过早完美计划,反而让你缩手缩脚,犹豫不前,瞻前顾后,顾此失彼,最后虎头蛇尾。

6、比如,如果我有了钱,我就如何如何享受快乐,比如,如果我将来有了很多的时间,我就会花更多的时间陪家人或锻炼…

这样类似的例子还可以举很多。

过早优化对大的问题在于:过早关注不重要的部分,而忽略行动和目标本身。以静态的思维来优化,殊不知,事务发展总是动态的,“优化”是需要长期的实 践积累才可以获得。出发点是好的,但往往好心办坏事,折腾大量的时间,做了很多不该做的,而该做的、重要的反而没做。强化外部条件、工具等外在,而忽略内 在因素和行动本身,或者,过多期望将来,而忽略当下眼前。

活在当下,实实在在做好手头的事,是避免“过早优化”最好的方法之一。

如何提高网站的访问速度 - 从30秒到3秒的改变

如何提高网站的访问速度 - 从30秒到3秒的改变

又一篇不是我写的东西,不错,对于WEB开发人员来说还是有参考意义的。所以我就贴了回来,也可以做个参考吧。。

原文:摘自:http://xinsync.xju.edu.cn/index.php/archives/4504

2006年10月份,我开始对web开发产生了兴趣,并决定自己也尝试开发一个网站。在此之前,我做过3年的java application的开发,对web开发应该算一无所知。在比较了java,php,ror,和python后,我选择了基于python的web框 架 - django 。到目前为止,我还认为这是一个明智的决定。Django高效的开发效率让我仅仅用一个月的业余时间,就基本完成了网站的开发。这是一个网络书签的网站, 我加上了一些有意思的特性,让网站显得有些与众不同。

我购买了域名和Dreamhost 的主机空间。Dreamhost支持django,并且第一年的费用只有180元人民币。2006年11月份,http: //www.hpbookmarks.com 上线了。网友们发来了善意的评论,“很有创意”,“点意思”,“一些feature很不错”。同时,还有一个非常一致的意见就是,“访问速度太慢了”。其 实,当时的情况不只是访问速度慢,而且是相当不稳定。很多时候是几个小时网站无法访问。当时,我并没有在意,因为我有两个自以为“合理”的解释。第一,我 用的是国外最便宜的虚拟主机,国内访问慢是很正常的。第二,django的还处于0.95的状态,效率和稳定性方面有问题也正常。

但是,我慢慢发现上面的解释不过是自己骗自己的借口。很多用dreamhost的网站,访问起来也很快。而且django也已经被成功应用在许多 大型的网站。我开始认真考虑提高网站速度的问题了。毕竟,速度慢的网站很可能在第一次就失去的用户,他们可以永远不会再来了。终于,我进行了下面一步一步 的优化工作,并且取得了一个看起来还不错的结果。

第一步,用Ajax提高用户体验

由于我的网站上链接字体的大小是根据点击次数决定,所以每次点击都要提交到服务器端并记录次数,再在客户端打开网站链接。这在localhost 测试的时候没有发现问题,但是部署到服务器上,会感到明显的等待。解决办法就是用Ajax。用户点击网站链接后就直接打开,再通过Ajax将点击的事件提 交到服务器端记录。这样用户感觉不到任何延时。

第二步,将逻辑移到客户端的javascript中

在开始的时候,“网站标签高亮”和“手气不错”的功能都是提交到服务器端操作,然后返回结果的。后来,我发现其实很多逻辑是可以移到客户端,由 javascript来实现的。Javascript非常强大,可以完成很多复杂的逻辑。将逻辑移到客户端的javascript中,可以很有效的减少和 服务器通讯的次数,获得更好的访问速度。

第三步,解决进程的

由于采用的是fastCGI的方式,我配置了django.fcgi。可是,我发现系统进程中,有大量的django.fcgi进程被标记为 < defunct>(失去功能)。这些进程会导致服务器有时无法正常访问。我开始尝试用命令来kill掉这些进程,但是很快发现这无法从根本上解决问 题。后来,我看到一个老外在blog上提到一个解决方案,将django.fcgi改名为dispatch.fcgi。原来,dispatch.fcgi 是一个dreamhost的系统进程,它的健壮性是可以得到保障的。果然,我将django.fcgi改名为 dispatch.fcgi后,的现象再没有出现。

第四步,优化SQL语句

SQL语句的执行通常也是一个很花费时间的操作。经过检查,我发现我的一条SQL语句,是一个嵌套三层的子表查询。而这条SQL还必须是一个 Raw SQL,即不能采用django的OR Maping。这意味着不能被cache缓存,每次都是真刀真枪的执行。更失败的是,经过我的分析,这条SQL完全可以不执行。这是一次设计上的失误,标
准的over design(过渡设计)。当时,我是想通过数据库得到一个最精确的统计值。后来发现,这个值完全可以用一个近似的常量代替。优化SQL,尤其是避免不必要的SQL执行,带来的效果是非常明显的。

第五步,尽量减少页面大小

随着添加网站越来越多,有一天我发现django生成的首页已经达到了80k。我很清楚这是一个非常不能被接受的数字。我开始检查页面,很快发现 了线索。 第一,因为偷懒,页面中很多layout是用空格( )实现的。第二,因为为了增加代码可读行,调试方便,每行生成的页面都增加换行符 (\n)。第三,最糟糕的是,大量的用了
inline css。就是将css style直接嵌入标记块中。于是,我立即动手,用css的align解决layout,去掉\n,将inline css抽象到独立的css文件中。这样下来,在不更改任何内容的情况下,80k变成了57k。(补充:由于网站链接大部分是打开新窗口,所以用了大量的 target=_blank。在ylsdd的提示下,在html的head里增加了,又节约了4k。)

第六步,用gzip进行页面压缩

当我兴高采烈的把页面优化结果贴到了smth bbs上,却被直接泼了盆凉水。原来百分之二十几的优化结果,实在太一般了。ylsdd给我了一个很重要的线索,deflate。原来apache的 deflate模块可以把文件进行gzip压缩,压缩后的文件传到浏览器后再被解压。主流的浏览器都支持这种gzip的解压操作。于是,我在apache 的配置文
件中加入了Add OutputFilter DEFAULT html css js的语句。经过测试,css,js这些文本文件的压缩后都只有原来尺寸的25%。这里,和大家分享一个网站http: //www.port80software.com/products/httpzip/compresscheck 它的作用是检测你的网站是否被压缩,以及压缩比率等。

第七步,回归静态页面

新的问题又来了。原来deflate只支持静态文件的压缩。而我的首页是django动态生成的,deflate模块没有进行压缩。我突然想到, 网站的首页为什么不能是静态页面呢?于是,我增加了一个runtime的api,这个api提供的是和原来一样由django动态生成的页面。我又写了一 个 python的程序,通过urllib2模块下载这个动态生成的页面,并保存为index.html。我将网站的root映射到index.html这个 静态页面。最后,通过linux crontab定义一个行为,每五分钟执行一下这个python程序,生成新的index.html。值得一提的是,由于网络原因,python程序不一 定每次都能准确完整的下载动态生成的页面。所以我们必须再进行一个校验算法。当页面大小要超过一定数字,页面中出现某个校验字符串的情况下,才保存 index.html。这样,每次用户提交的访问,不是由服务器端动态生成页面,极大的节省了服务器端的开销。而静态页面又可以有效的被deflate压 缩。最后结果,首页被压缩为13k,为原来的22%。唯一的区别就是,新提交和推荐的网站不能立即出现在首页。但是我认为,这应该是可以被接受的。

至此,网站的优化工作基本完成。网站的访问速度从原来30秒以上,缩短到3秒左右,应该说算是一个飞跃。虽然,3秒的速度也不是非常快,但是,考虑到虚拟主机等客观原因,这个结果我还是满意的。原来感觉我的网站很慢的朋友们,也可以再试试。

以上的优化方案出自我的个人经验,并不一定适合所有网站。但是,它告诉我们一个事实。影响网站访问速度的不仅仅是服务器配置,网络带宽。也许,你 糟糕的设计,低效率的方案也是致命的因素。应当注意的是,优化工作也不能匆匆上手。一定要仔细研究,具体情况具体分析,得到统计数据,找到真正的问题所 在,再开始优化。相信自己,提高网站的访问速度并不是不可能。毕竟,Nothing is Impossible。祝大家成功。

何时升级硬件,何时更新配置

何时升级硬件,何时更新配置

一直在关注着MYSQL的优化工作,但却也从来没有从硬件方面进行过探讨,前段时间有人在群里贴了一个msyql部落的链接,跑上去偷偷看了两眼,发现还是有点料的。以下就是其中的一点料:

http://www.mysqlsystems.com/?p=3

以前一直在MySQL的本家做咨询工作,所以我下面和大家讨论的话题是一个我在工作中经常遇到的问题。

什么时候我们应该升级硬件?什么时候应该修改配置?

作为DBA,老板和公司总是希望我们以最小的投入换来最大的性能(效益)。不过我并没有暗示大家,我接下讨论的话题,会是让各位避免购买硬件。

对于上面的答案很多人肯定会说两者都做,或者只做配置修改。我想我没有给大家出选择题,只是拿出来做任何一个考虑的时候,哪些因素影响着我们。我的回答经常是:

1.使劲优化MySQL服务器和查询语句

先看看别人的例子,或者仔细读一些MySQL的手册吧,这样你可以优化一些非常简单的my.cnf。也许最简单的index提高了几十倍的性能。不要轻易买硬件!

2. 先看看你的硬件整体架构是否平衡?

这个问题比较复杂,需要配合你的系统管理员来做,比较小的公司可能是一个人包了 这两个角色。我曾经去过一个沈阳的ISV那边,他们是一个大数据量,并发的使用MySQL。后来随着业务增加,其中三台IBM的P机放数据库的机器负担非 常重,后来老板下死令要dba调性能。DBA在尝试了很多种手册上的方法后,均无明显效果。后来在很多次交流以后才得知,他们信息中心还有4台机器跑着 Mail服务器,任务量非常轻。在建议他们利用上这些机器可能配置的情况下,性能很快就上去了

3. 没办法,服务器全用上了?

这种情况也非常常见,特别是对于那些服务器24小时都有人访问的web公司,如 youtube。如果用一些性能监视工具去监控整个服务器,结果看看一整天的流量和性能图,可能会大跌眼镜,服务并不是每时每刻都非常慢,而是某个特定时 间段,排除网络的原因,服务器备份的时候或者DBA下班的时候设置的半夜Cron工作总是对数据库有非常大的压力。

4. 还是买硬件吧,有什么建议?

性能调优有句老话,没有最好只有更好。一个系统的性能出现问题,是各个环节的累计造成的。用微观经济学的说法就是我们要使用边际成本最高的投入。

下面几种情况可以考虑相应的部件升级,经济危机了,整机成本太高而且是在没有必要。

IO读写太多,也许考虑买一条200块的内存?
增加CPU运算,也许考虑买一台x86的服务器,忘记Sun的CMT吧,因为MySQL的限制,使用不了这么多线程,反倒增加负担。